
-
Harpa AI à l'essai : résumer une vidéo, répondre au courrier, facturé au million de jetons
Un raccourci appelle plusieurs modèles de pointe sur n'importe quelle page, et le moteur en dessous les transforme en consignes sensibles à la page, en brouillons de courrier et en automatisations planifiées. La mesure se fait en jetons : le palier choisi décide du travail qu'on peut confier.
-
Sider à l'essai : une barre, trois métiers, et une machine distante sur le haut de gamme
Chat lit la page ouverte, Hand traverse plusieurs sites pour mener la course, Code réécrit une page en langage courant. Les trois partagent une seule barre, et les paliers élevés ajoutent une petite machine distante pour que la course continue une fois l'ordinateur refermé.
-
Monica à l'essai : un assistant dans la barre latérale que le navigateur possède déjà
Ni nouvelle application ni nouvel onglet : l'assistant est une barre posée sur la page qu'on lit. Sélectionnez du texte, il explique, traduit ou résume, et le modèle derrière la réponse se choisit dans un menu. La partie intéressante est la facturation.
-
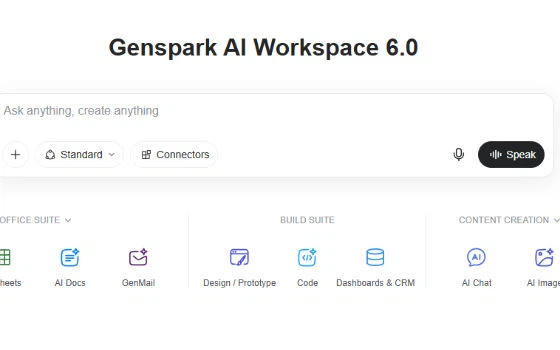
Genspark à l'essai : un établi qui contient diapositives, tableurs et courrier
Une zone de saisie au centre, un anneau d'applications autour, et quatre couches en dessous : mémoire, moteur d'agents, trois suites d'outils et une surface de collaboration. L'ampleur est réelle, la profondeur reste à tester.
-
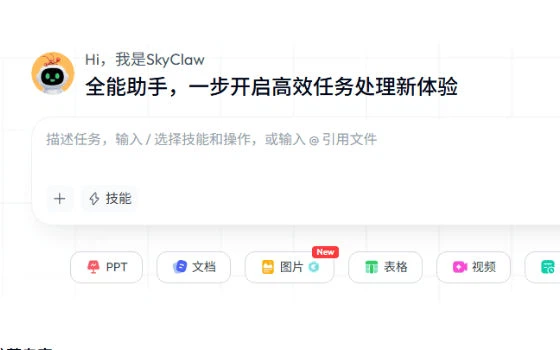
Tiangong est passé d'un champ de recherche à un établi de tâches
La recherche n'est plus qu'une entrée parmi d'autres : un assistant polyvalent prend une tâche décrite en mots, choisit lui-même des compétences ou des experts pour l'exécuter, se planifie dans le temps et s'installe dans une messagerie pour travailler sans surveillance.
-
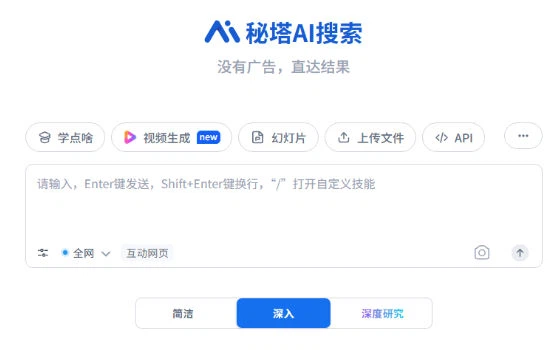
Metaso répond par un plan sourcé plutôt que par une page de liens
Sans publicité, droit au résultat : trois profondeurs au choix, une recherche sur le web, une bibliothèque, le domaine académique, les images, la vidéo ou les podcasts, et une réponse découpée en sections avec une source sur chaque affirmation.
-
NotebookLM ne répond qu'à partir de vos sources, puis les transforme en podcast
Importez des PDF, des sites, des vidéos ou de l'audio : chaque réponse reste dans ce corpus, avec une citation dans le texte qui ramène à la source. Les mêmes documents se recyclent en guide d'étude, en note de synthèse, en carte mentale ou en discussion à deux voix.
-
LocalAI : des moteurs tirés à la demande, un modèle sans carte
Un binaire et un point d'accès compatible : on dirige le client dessus, le code ne bouge pas et le modèle revient chez soi. Les moteurs n'arrivent que lorsqu'un modèle les réclame, chaque fonction a un chemin sur processeur.
-
vLLM : servir un modèle en gérant la mémoire graphique comme un système
Découper le cache des clés et des valeurs en blocs au lieu de le réserver d'un coup fait passer l'occupation de mémoire de trois ou quatre dixièmes à plus de neuf : la même carte sert alors deux à quatre fois plus de requêtes.
-
Msty : modèles locaux et distants dans une seule fenêtre
Deux moteurs dans une même fenêtre font tourner un modèle ouvert en un clic, plus de 12 fournisseurs hébergés s'ajoutent avec votre propre clé, et une conversation peut changer de modèle en route - ou se fendre en volets pour poser deux fois la même question.
-
AnythingLLM : un atelier privé qui reste sur le bureau
Glissez des PDF, des fichiers de traitement de texte et des tableaux dans un espace : vous obtenez un assistant qui a tout lu de ce que vous possédez, avec une citation sous chaque réponse, le modèle, le magasin de vecteurs et le stockage restant sur la machine.
-
llama.cpp : le moteur qui fait tourner un modèle sur un simple processeur
Écrit en C pur, sans une seule dépendance, il a fixé le format de fichier qui a rendu les modèles quantifiés assez petits pour un portable ordinaire, et plusieurs outils de bureau connus reposent discrètement sur lui.
-
GPT4All : un modèle local même sans carte graphique
Pas de carte dédiée, pas de compte, pas de ligne de commande : un modèle ouvert quantifié tourne sur un processeur ordinaire, et un dossier de vos propres papiers devient un ensemble interrogeable qui ne quitte jamais la machine.
-
Jan : un assistant local dont on peut lire les sources
La fenêtre de conversation, la gestion des modèles et le service local sont publiés ligne par ligne sous une licence ouverte permissive : la discussion continue même câble débranché, et la promesse de confidentialité n'a plus besoin d'être crue sur parole.
-
LM Studio : des modèles locaux aussi commodes qu'un assistant hébergé
Pas de terminal, pas de paramètres à mal taper : une fenêtre liste les modèles selon leur taille et selon qu'ils tiennent sur votre carte, un clic les télécharge, et le champ de dialogue se comporte comme chez un assistant hébergé.
-
第 1 / 3 页