
Apifox : un outil gratuit pour concevoir, déboguer et tester des API
Résumé
Apifox réunit documentation, débogage, mock et tests automatisés d'API dans un seul système, si bien qu'un projet n'entretient qu'une copie de ses données d'interface.
Recommander- Nom
- Apifox
- Version
- 20220914
- Tarif
- Gratuit
- Open source
- Propriétaire
- Mis à jour
- 2026-10-06 22:58
Un seul système au lieu de quatre
Apifox accompagne une interface sur toute sa durée de vie : écrire sa documentation, la déboguer, la simuler avant que le backend existe, puis lancer des tests automatisés dessus. Le choix de conception derrière est que ces quatre activités lisent les mêmes données. Un projet entretient une seule description d'une interface, et tout le reste en découle : c'est précisément ce qui supprime le problème connu des deux systèmes qui gardent deux versions de la même API.
Le résumé de l'éditeur nomme quatre domaines — documentation, débogage, mock et tests automatisés d'API — et l'édition SaaS publique est actuellement gratuite, sans limite de membres d'équipe, de fonctions, de projets ou de nombre d'interfaces.
Concevoir la documentation
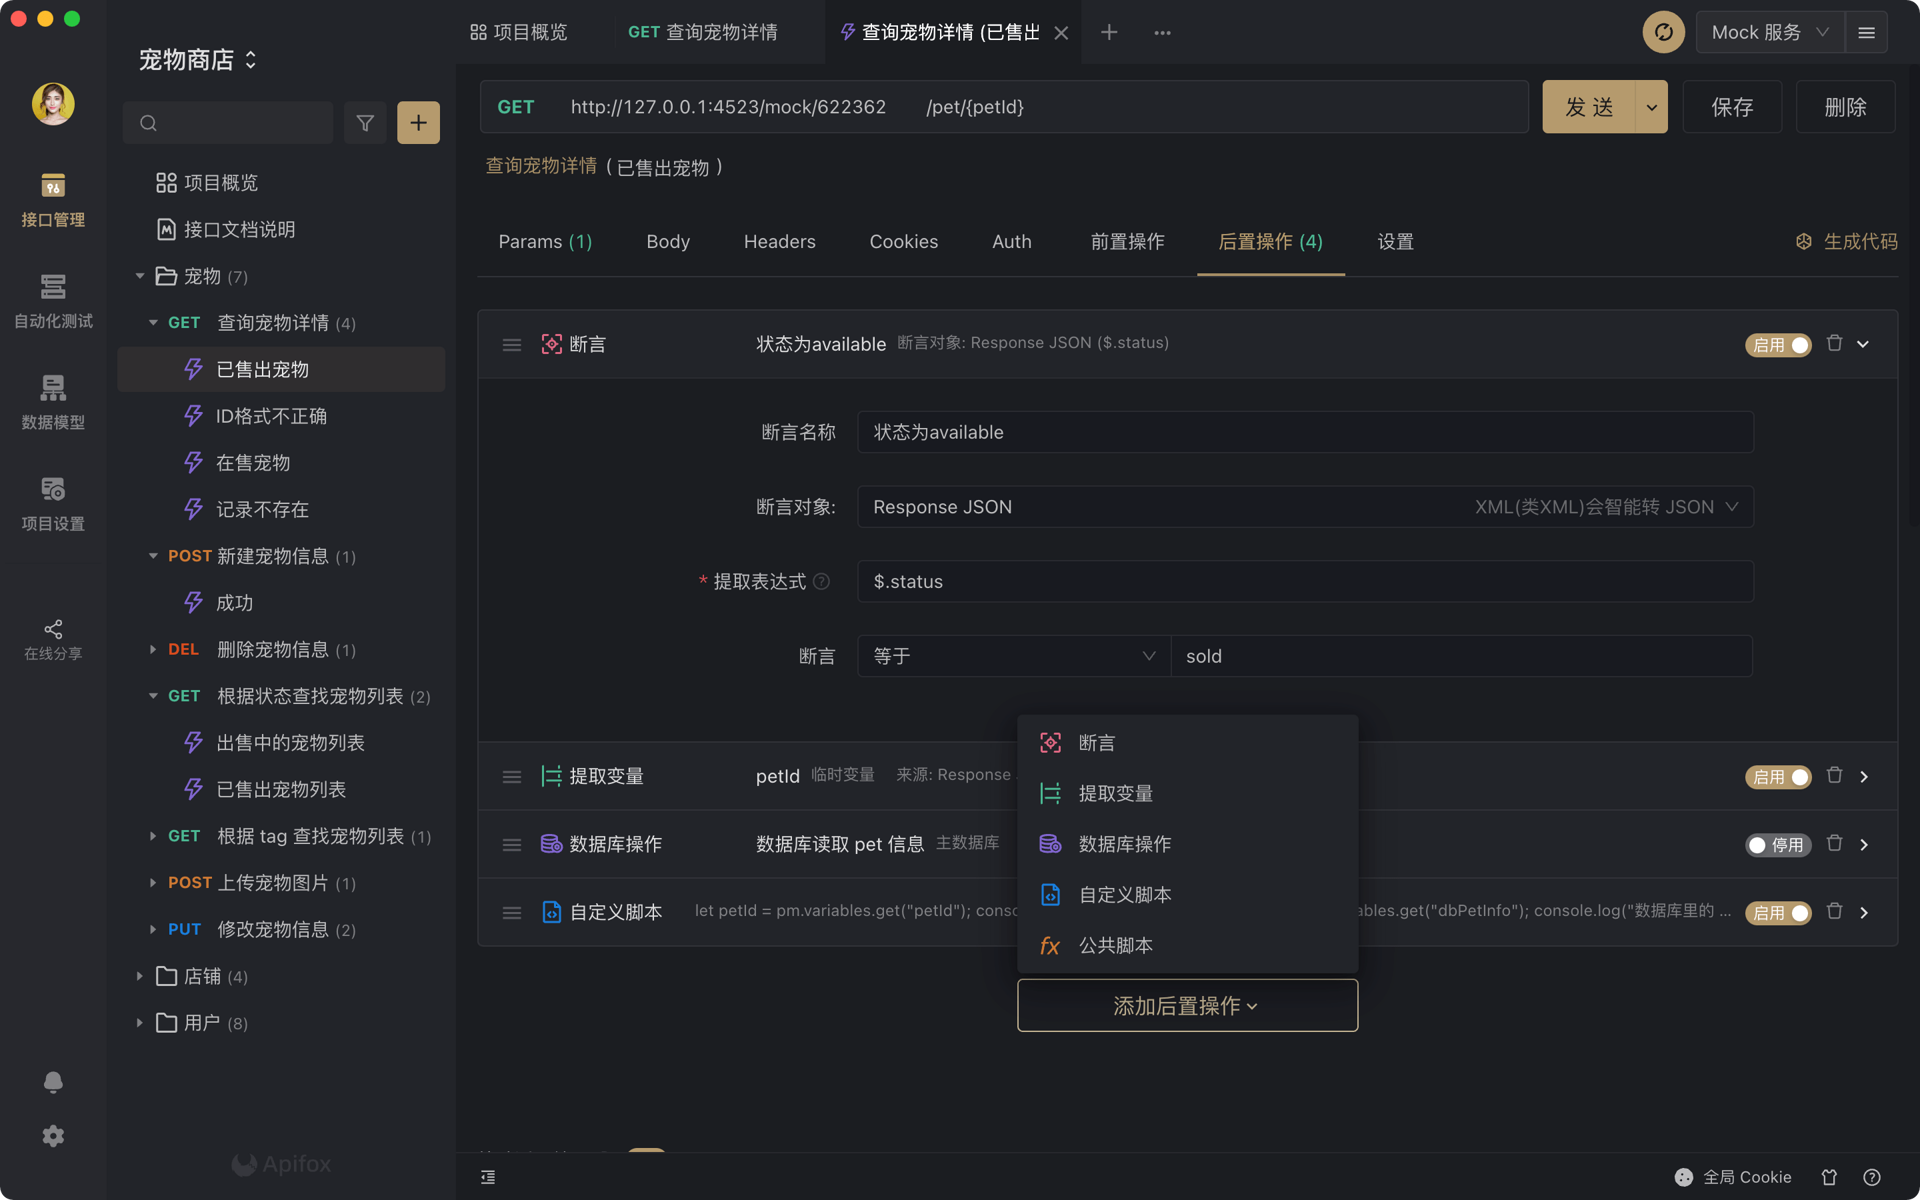
Les tests de scénario exécutent une suite d'appels comme un seul flux et vérifient que les données échangées entre eux restent correctes. Les assertions se posent visuellement plutôt que sous forme de code, des variables peuvent être extraites d'une réponse, et du SQL peut être exécuté contre une base au milieu du flux. Des scripts avant et après requête sont libres, et leur syntaxe est entièrement compatible avec les scripts Postman, ce qui maintient le coût d'apprentissage bas pour une équipe qui vient de cet outil.
Les scripts ne se limitent pas à JavaScript : javascript, java, python, php, js, BeanShell, go, shell, ruby et lua peuvent être appelés, un utilitaire existant n'a donc pas à être réécrit dans un autre langage.
Déboguer
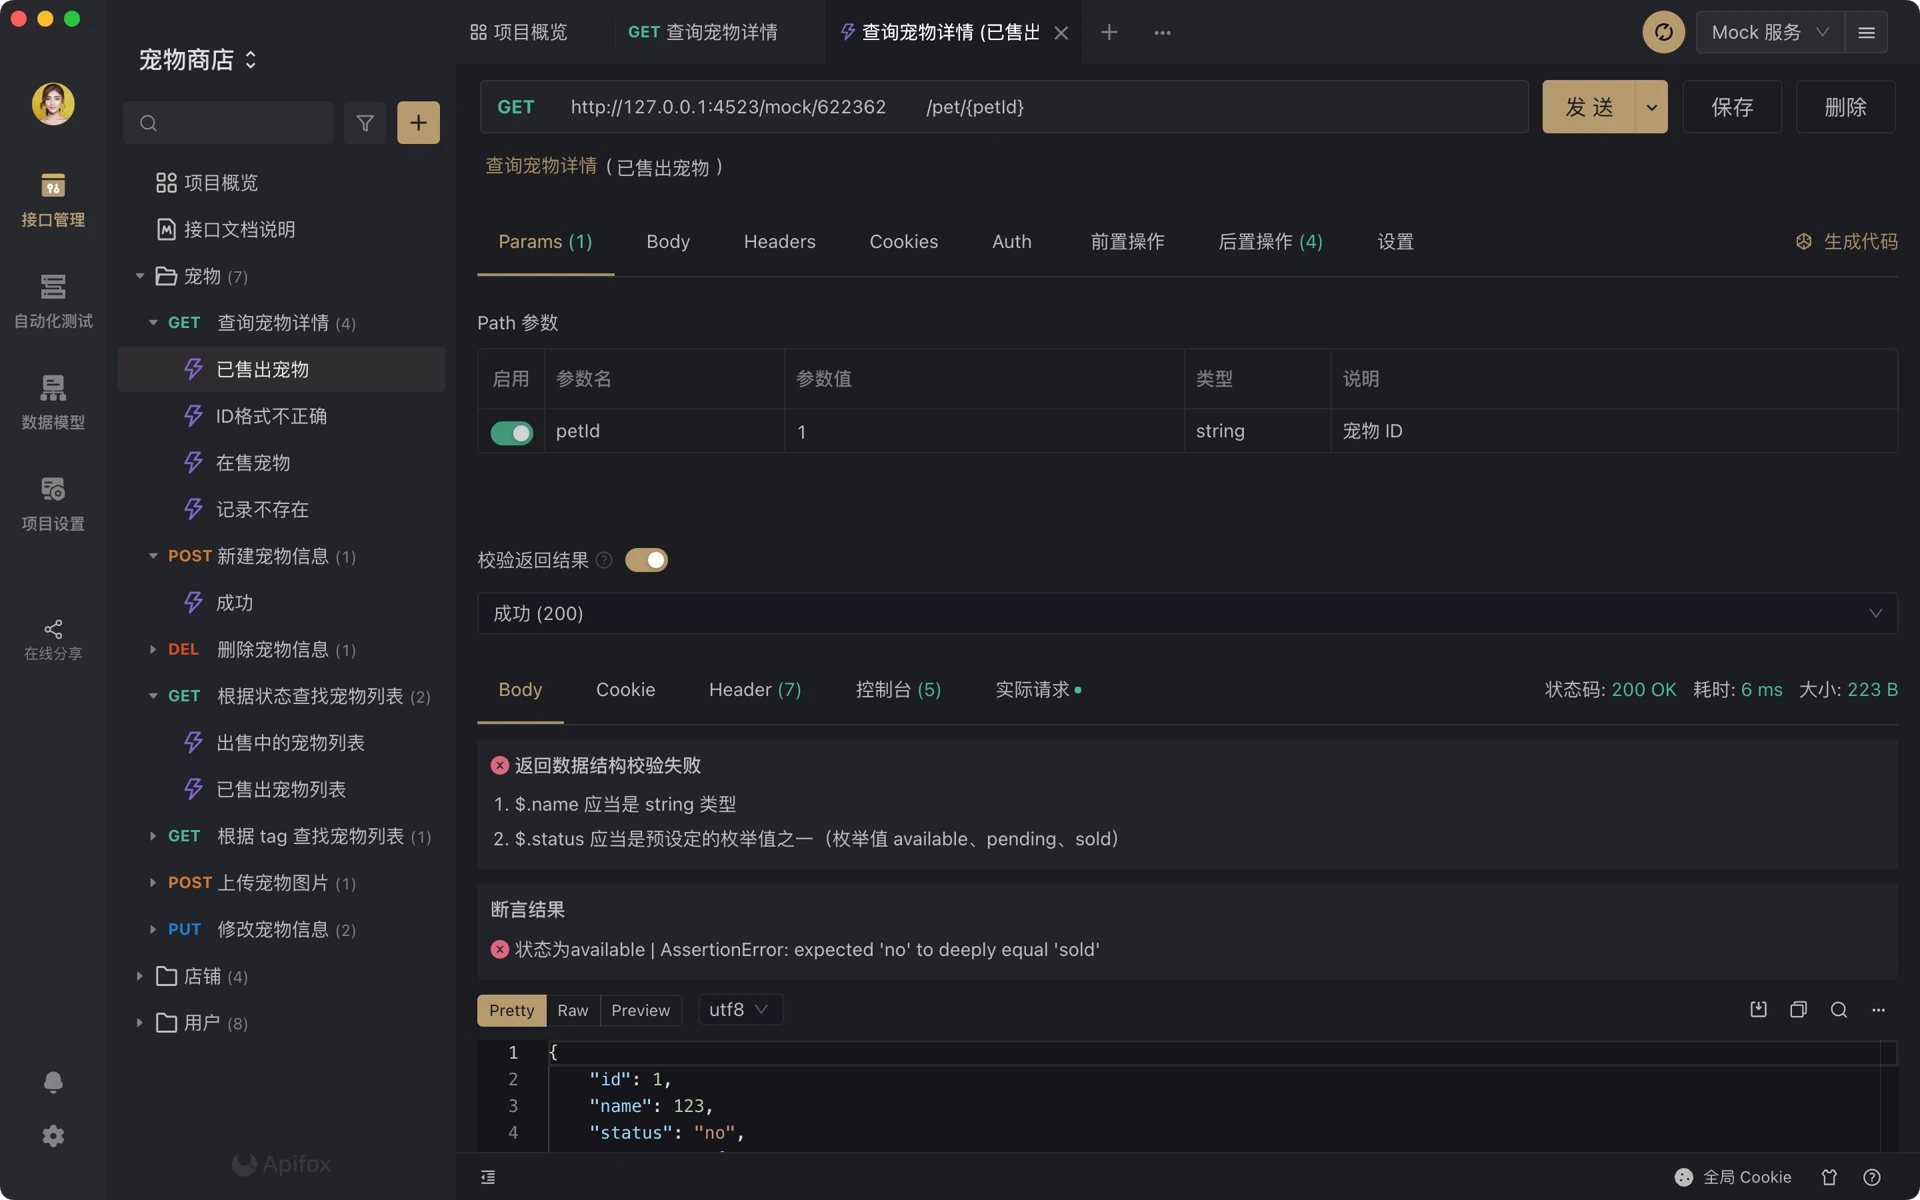
La vue de débogage apporte ce qu'on attend d'un outil d'interface : variables d'environnement, scripts avant et après requête, et données de Cookie et de Session partagées entre requêtes. En plus, elle valide la structure d'une réponse contre la définition de la documentation : un champ qui a changé de type ou disparu est signalé au lieu d'être remarqué une semaine plus tard.
Les cas appartiennent à l'interface et non à une session : une interface peut en contenir plusieurs, chacun avec ses paramètres et ses attentes. Assertions, extraction de variables et opérations SQL se règlent aussi visuellement ici, ce qui garde la même façon de travailler en conception, en débogage et en test.
Mock et tests automatisés
Le mock ne demande aucune configuration : l'outil déduit des données plausibles de la documentation elle-même. Un moteur de règles Mock.js intégré permet de fixer les règles au moment où la structure de données est définie, et des valeurs de paramètres différentes peuvent renvoyer des contenus différents — c'est ce qui rend un mock utile pour tester des branches et non seulement le chemin heureux.
Les tests automatisés réutilisent les tests de scénario décrits plus haut. Ils se lancent en ligne de commande via Apifox CLI, et c'est ce qui les fait entrer dans l'intégration continue : une tâche Jenkins ou n'importe quel autre exécuteur peut dérouler la collection à chaque construction.
Base de données et code généré
L'accès à la base fonctionne dans les deux sens : des données peuvent être lues pour servir de paramètres à une requête, et lues aussi pour vérifier qu'une requête a réellement réussi — ce qui compte quand l'interface ne renvoie qu'un accusé bref et que le vrai résultat atterrit dans une table.
À partir d'une définition d'interface ou de modèle, l'outil génère du code métier et du code d'appel. TypeScript, Java, Go, Swift, Objective-C, Kotlin, Dart, C++, C# et Rust font partie des 130 langages et frameworks couverts, et des modèles personnalisés permettent de suivre les conventions d'architecture d'une équipe.
Protocoles, import et export
Les interfaces HTTP et HTTPS sont gérées, ainsi que les connexions Socket sur TCP. GraphQL, Dubbo, gRPC et WebSocket sont annoncés pour une version ultérieure, ce qu'il vaut la peine de savoir quand un projet décide de standardiser sur l'outil.
L'export se fait en OpenAPI (Swagger), Markdown ou HTML. L'import couvre OpenAPI (Swagger), Postman, HAR, RAP2, JMeter, YApi, Eolinker, NEI, RAML, DOClever, Apizza, DOCWAY, ShowDoc, apiDoc, I/O Docs, WADL et Google Discovery : une collection existante a donc rarement besoin d'être reconstruite à la main.
Le travail en équipe
Les données d'interface sont synchronisées dans le cloud et mises à jour en temps réel, ce qui est la condition pour que l'idée de la copie unique tienne à plusieurs. Les droits se gèrent par équipe et par projet, avec des rôles d'administrateur, de membre ordinaire et de membre en lecture seule.
À qui cela convient
Une équipe backend fatiguée de tenir documentation, collection de débogage et cas de test à trois endroits y gagne immédiatement : une définition, plusieurs usages. Une équipe frontend qui attend une interface inexistante reçoit un mock dérivé de la documentation au lieu d'un bouchon écrit à la main. Et une équipe qui possède déjà une grosse collection ailleurs peut généralement l'importer plutôt que de repartir de zéro.