
IndexTTS s'installe chez soi et laisse régler émotion et débit par paramètre
Résumé
Un système de synthèse vocale zero shot à faire tourner sur sa propre machine. Un seul extrait de référence suffit pour cloner une voix, l'émotion, le débit et la prononciation restent des paramètres, et les poids relèvent d'une licence propre au projet.
Recommander- Nom
- IndexTTS
- Version
- 2.5
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinux
- Mis à jour
- 2026-10-06 20:19
Un titre de dépôt qui ressemble à une fiche technique
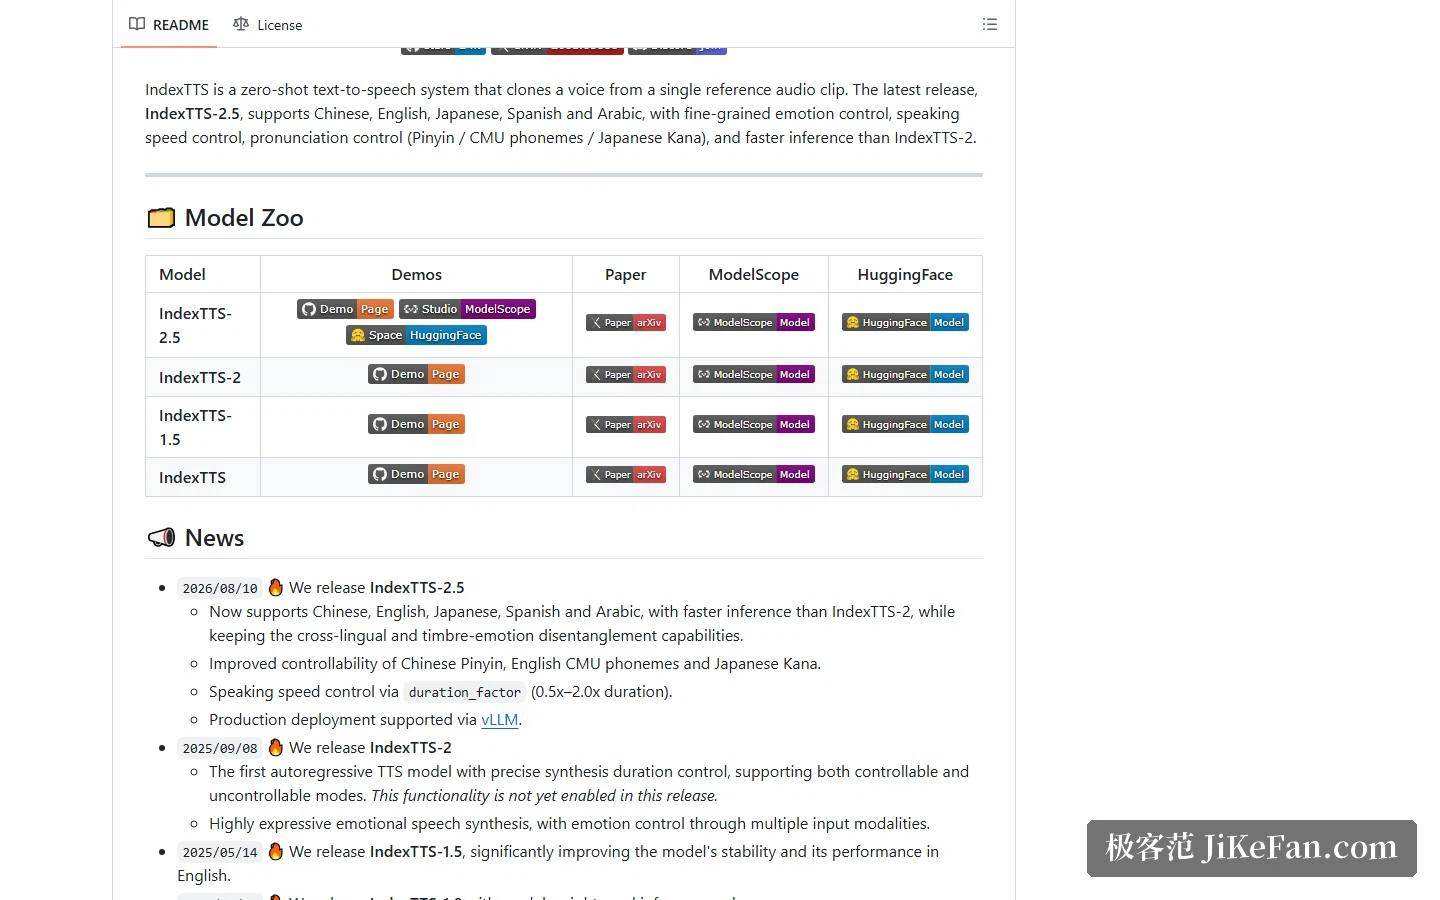
IndexTTS annonce ce qu'il est dès la première ligne de son dépôt : un système de synthèse vocale zero shot industriel, contrôlable et efficace. Trois adjectifs, trois promesses : tenir la charge d'une mise en production, se laisser piloter, et tourner assez vite pour que cela compte. L'entrée pour cloner une voix est tout aussi directe. Un extrait de référence suffit, sans étape d'entraînement entre les deux.
La version courante est IndexTTS-2.5. Elle couvre le mandarin, l'anglais, le japonais, l'espagnol et l'arabe, et le projet indique une inférence plus rapide que sur IndexTTS-2, tout en conservant la capacité interlangue et la séparation entre timbre et émotion établie par la version précédente.
Quatre versions, une seule lignée
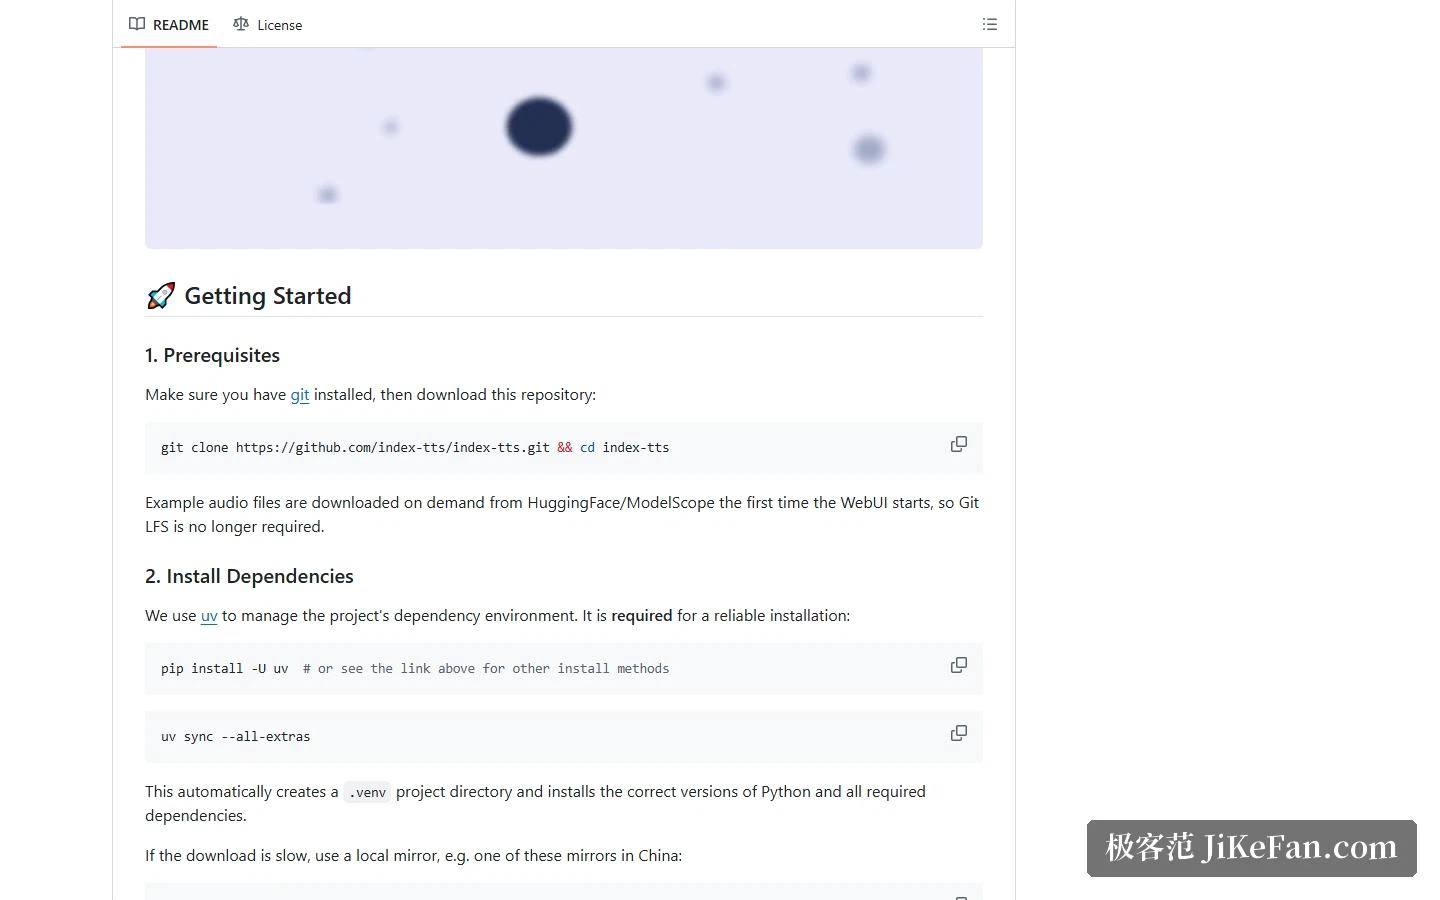
Le journal des modifications raconte la suite sans détour. La base IndexTTS est venue d'abord. La version 1.5 a mis l'accent sur la stabilité et sur l'anglais. La version 2 a été le premier modèle autorégressif de la série à contrôler précisément la durée de synthèse, même si la même note précise que la fonction n'était pas activée lors de cette publication. La version 2.5 élargit l'ensemble à cinq langues, améliore le contrôle de la prononciation pour le pinyin et les phonèmes, et ajoute la régulation du débit ainsi qu'un chemin de déploiement via vLLM.
Les quatre coexistent dans la bibliothèque de modèles, chacune avec sa démo, son article et son téléchargement de poids. Le choix dépend des capacités dont le cas d'usage a besoin, pas du numéro le plus élevé.
Trois axes de réglage
C'est ici qu'IndexTTS se distingue. Rien que pour l'émotion, trois méthodes existent. On peut fournir un extrait de référence émotionnel séparé et doser son effet avec emo_alpha, qui va de 0 à 1 et vaut le maximum par défaut. On peut plutôt passer un vecteur de flottants de longueur huit, dans un ordre fixe : joie, colère, tristesse, peur, dégoût, mélancolie, surprise, calme. On peut enfin décrire l'émotion en une phrase de texte.
Le débit passe par duration_factor, qui accepte de la moitié au double, la valeur par défaut correspondant au rythme d'origine. Au-dessus, la parole ralentit ; en dessous, elle accélère. Le paramètre se justifie quand on double une vidéo, puisque la longueur de l'image est fixée et que la voix doit tenir dedans.
La prononciation est le troisième axe, avec trois cibles : le pinyin pour le mandarin, les phonèmes CMU pour l'anglais, les kana pour le japonais. Quand un caractère a plusieurs lectures, ou qu'un nom propre étranger sort de travers, on intervient à la main au lieu de réenregistrer.
Le facteur temps réel sur une seule 4090
Le repère publié a été mesuré sur une seule 4090 avec le cache KV activé. IndexTTS-2.5 atteint un facteur temps réel de 0,2065 en bf16 et de 0,2060 en fp32. À titre de comparaison, IndexTTS-2.0 mesurait 0,3257 en fp16 et 0,3748 en fp32. Plus petit est meilleur : le chiffre décrit la marge de la génération sur la vitesse de lecture, et l'écart entre les deux générations se lit donc directement dans les nombres.
Les dépendances passent par uv
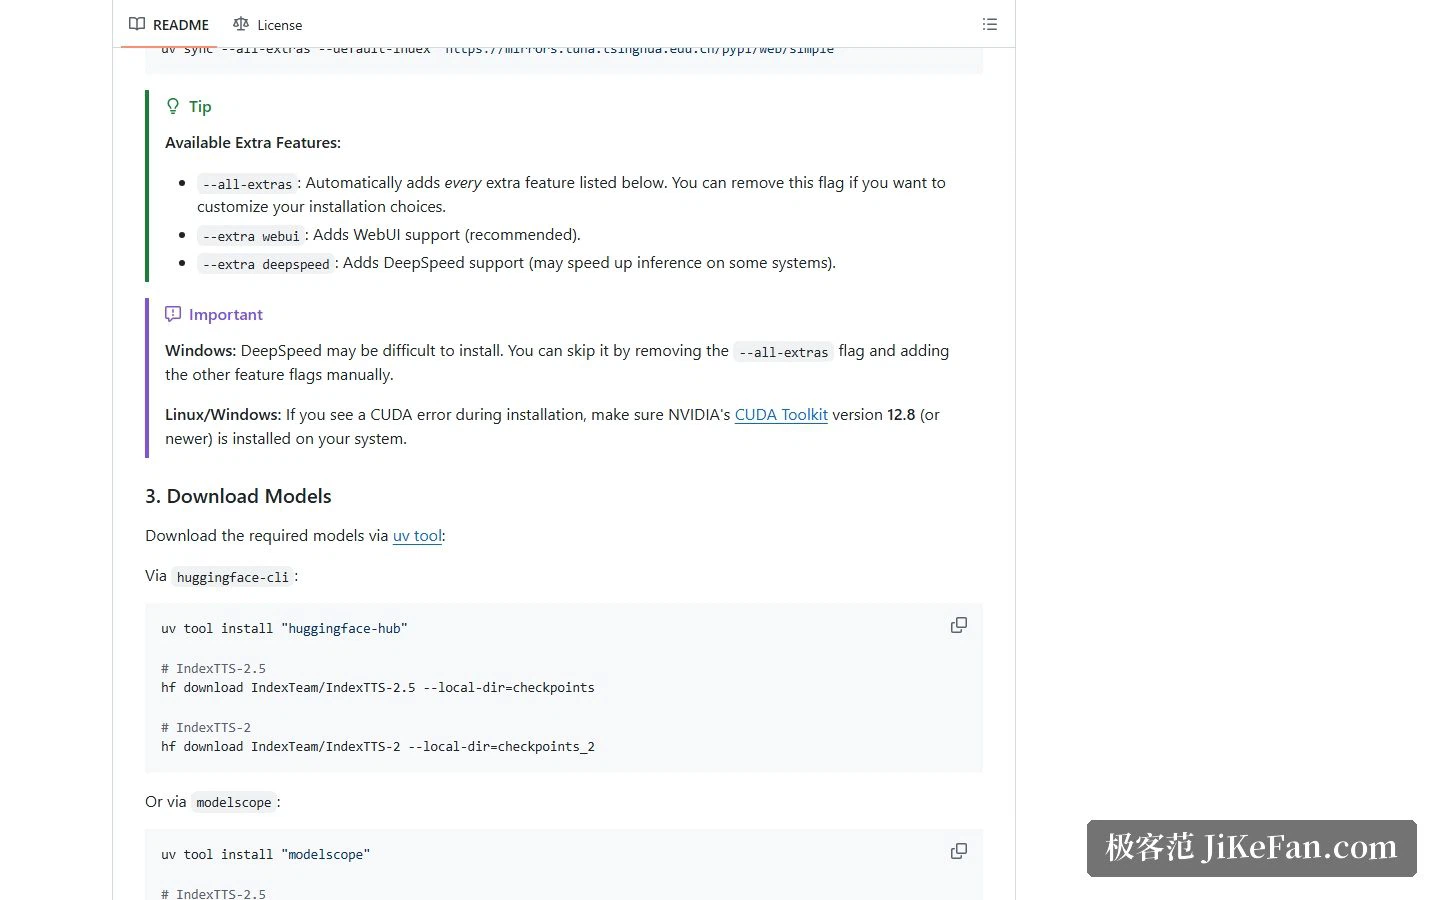
L'installation recommandée sort un peu de l'ordinaire. On installe uv avec pip, puis on synchronise tout le projet avec uv. La raison : uv crée lui-même l'environnement virtuel et verrouille à la fois la version de Python et celles des dépendances, ce que la documentation présente comme la condition d'une installation fiable. La même documentation déconseille d'activer l'environnement à la main, parce que c'est ainsi que naissent les conflits de dépendances.
Les composants sont optionnels à l'installation. On ajoute l'entrée webui pour l'interface dans le navigateur, l'entrée DeepSpeed pour l'accélération. Deux réserves accompagnent cela. DeepSpeed peut être pénible à compiler sous Windows ; dans ce cas on retire l'option qui installe tout d'un coup et on choisit à la main. Et si l'installation renvoie une erreur CUDA, il faut vérifier que la machine dispose du kit CUDA 12.8 ou plus récent.
Poids, contrôle matériel, premier lancement
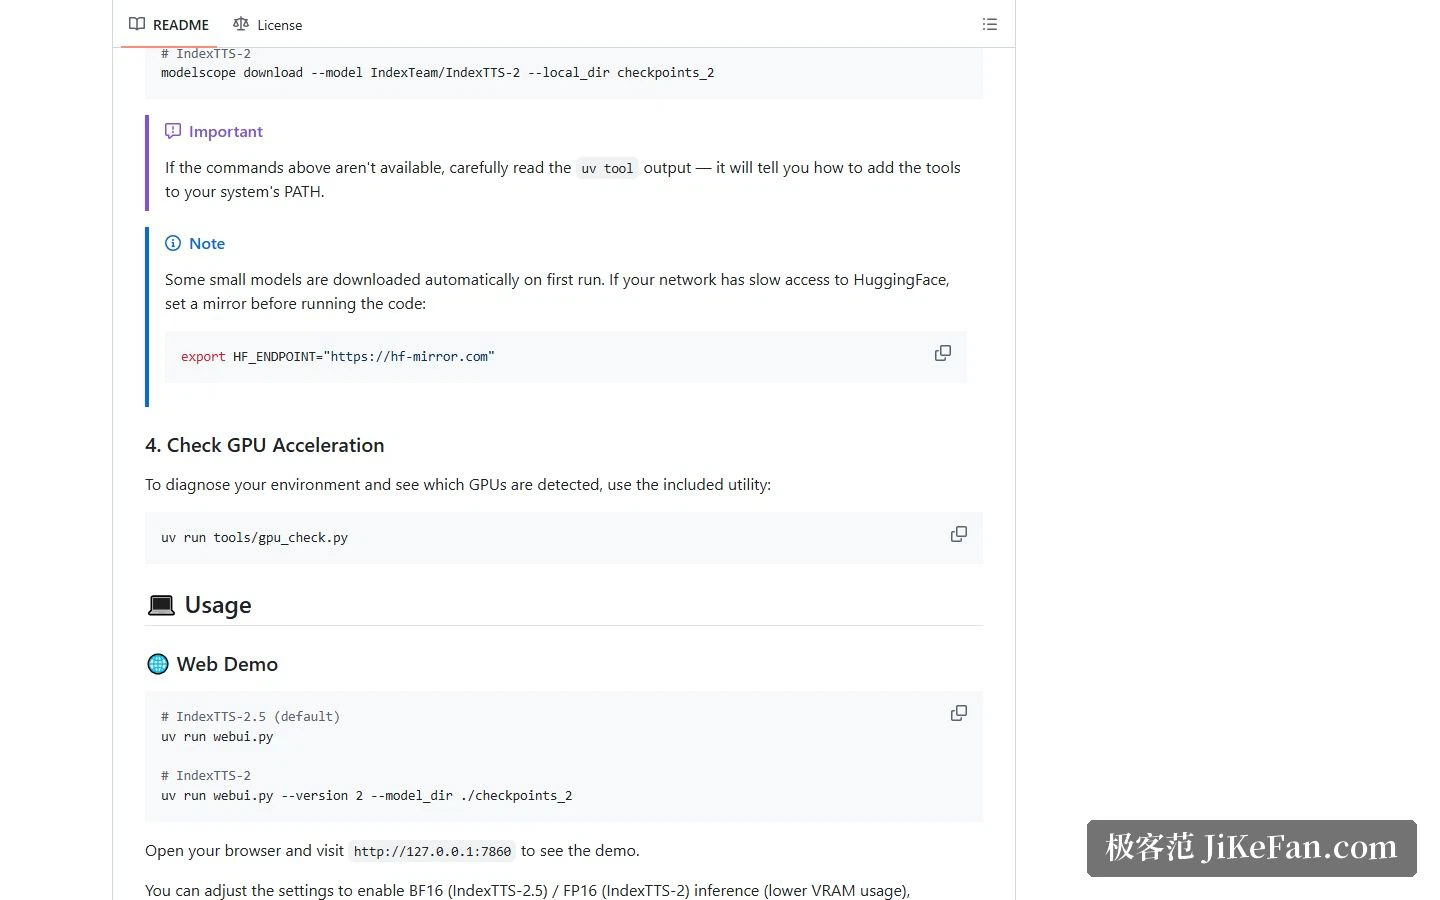
Les poids se téléchargent séparément, depuis HuggingFace ou ModelScope, et se déposent dans un dossier local que le programme lira. L'audio d'exemple est récupéré à la demande au premier démarrage de l'interface, ce qui rend Git LFS inutile : une étape de moins quand le réseau est capricieux.
Avant de lancer, exécutez le script de détection graphique pour savoir quels GPU l'environnement voit. Démarrez ensuite l'interface et ouvrez la page locale dans un navigateur. L'inférence en demi-précision se bascule depuis cette page ; le projet indique que BF16 ou FP16 est plus rapide, consomme moins de mémoire vidéo et ne perd que très peu en qualité.
La licence mérite un détour
Le code est public, mais la licence n'est ni MIT ni Apache : c'est la licence d'usage des modèles bilibili, et le dépôt en contient une version chinoise et une version anglaise. Conséquence pratique, le périmètre autorisé est défini par ce document et non par une concession open source générique. Si l'usage commercial ou la redistribution sont au programme, lisez-la d'abord et vérifiez que votre cas tombe dans ce qu'elle permet.
À qui cela convient
Si le besoin est d'intégrer de la parole synthétique dans un vrai produit tout en gardant la main, la densité de contrôle est élevée : émotion par vecteur ou par texte, débit mis à l'échelle avec précision, prononciation corrigée caractère par caractère, plus une voie de service via vLLM. Ce n'est pas la liste d'équipement d'un projet jouet.
Le coût d'entrée est réel lui aussi. Il faut une carte NVIDIA, le kit CUDA 12.8 ou plus récent, et la chaîne uv pour les dépendances. Et comme pour tout outil de clonage vocal, fabriquer du contenu avec la voix d'autrui soulève une question de consentement, davantage encore pour les personnalités publiques. Plus le débit et l'émotion se règlent finement, plus il importe de savoir à quoi la sortie est destinée.
Un contrôle plus fin se paie en complexité. Quand la liste de paramètres s'allonge, ce qui décide de la qualité n'est plus le modèle mais la compréhension du contenu par celui qui s'en sert.