
RVC transforme une voix enregistrée en une autre, avec dix minutes d'audio
Résumé
Un cadre libre pour convertir le timbre d'une voix et la changer en direct. Il demande au moins dix minutes de parole propre pour l'entraînement, atteint 170 millisecondes de latence de bout en bout et fournit deux interfaces.
Recommander- Nom
- RVC
- Version
- 2.3.260718
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinux
- Mis à jour
- 2026-10-06 23:15
Un autre travail que la synthèse vocale
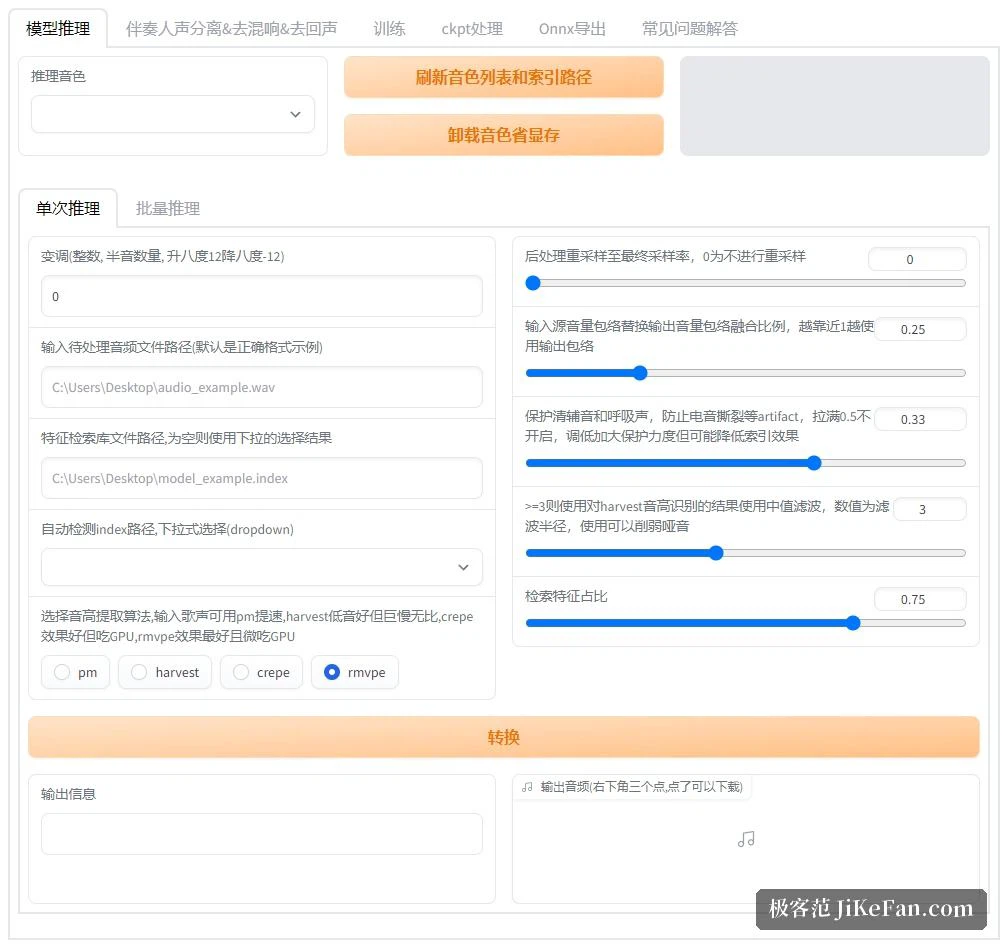
RVC signifie Retrieval-based-Voice-Conversion-WebUI, et le projet se décrit comme un cadre simple et facile pour la conversion de timbre et le changement de voix. Le travail diffère de la synthèse vocale : il ne produit pas de la parole à partir de texte, il prend un enregistrement existant et remplace son timbre par un autre.
Ces outils avaient autrefois un seuil élevé. RVC le ramène à deux nombres : au moins 10 minutes de parole pour l'entraînement, et 170 millisecondes de latence de bout en bout pour le changement de voix en direct.
L'entrée est la voix elle-même, pas un script. On remet un enregistrement et on récupère le même contenu dans le timbre d'un modèle cible. Ce qui change, c'est qui parle, pas ce qui est dit.
La première propriété citée par le projet est une étape de recherche top1 qui remplace les traits de la source par ceux du jeu d'entraînement, ce qui empêche le timbre de fuir. Ces traits viennent des données d'entraînement elles-mêmes, donc la sortie reste proche de la voix cible sans traîner l'accent ni la qualité d'enregistrement de la source.
S'entraîner sur dix minutes
La recommandation est de réunir au moins 10 minutes de parole à faible bruit de fond, le projet notant qu'une petite quantité de données donne déjà des résultats corrects. Cette échelle signifie qu'aucun studio n'est nécessaire : un enregistrement au calme dans une pièce suffit en gros.
L'exigence matérielle reste modeste de la même façon. Le projet indique que l'entraînement est rapide même sur une carte graphique relativement faible. Le modèle de base a été entraîné sur le corpus VCTK, ouvert et de bonne qualité, près de 50 heures, et le projet affirme qu'il n'y a pas de souci de droits. Une option ckpt-merge dans l'onglet des points de contrôle permet en outre de mélanger des modèles pour déplacer encore le timbre.
Installation : trois voies de dépendances
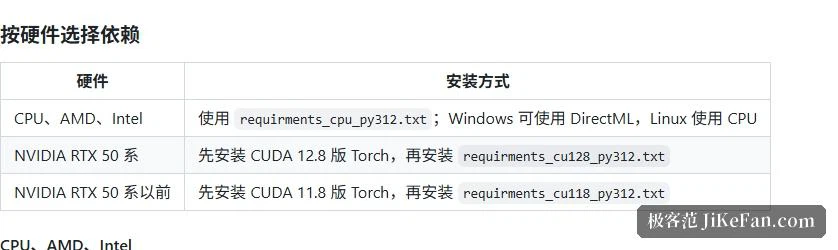
Cette branche vise Python 3.12 en 64 bits, avec Ubuntu 24.04 recommandé de ce côté. Les dépendances se répartissent en trois voies. CPU, AMD et Intel partagent un fichier. Nvidia se sépare par génération : la série RTX 50 installe d'abord la version de Torch pour CUDA 12.8, tout ce qui précède RTX 50 d'abord celle pour CUDA 11.8, puis le fichier de dépendances correspondant. L'ordre compte, Torch avant les dépendances. Une commande imprime ensuite les versions de Torch et CUDA, de quoi confirmer l'environnement avant d'aller plus loin.
Les cartes AMD et Intel suivent la voie CPU : DirectML sous Windows, CPU pur sous Linux. Cela tourne sur des plateformes non Nvidia, mais l'écart de puissance de calcul doit être accepté.
Les modèles doivent être au bon endroit
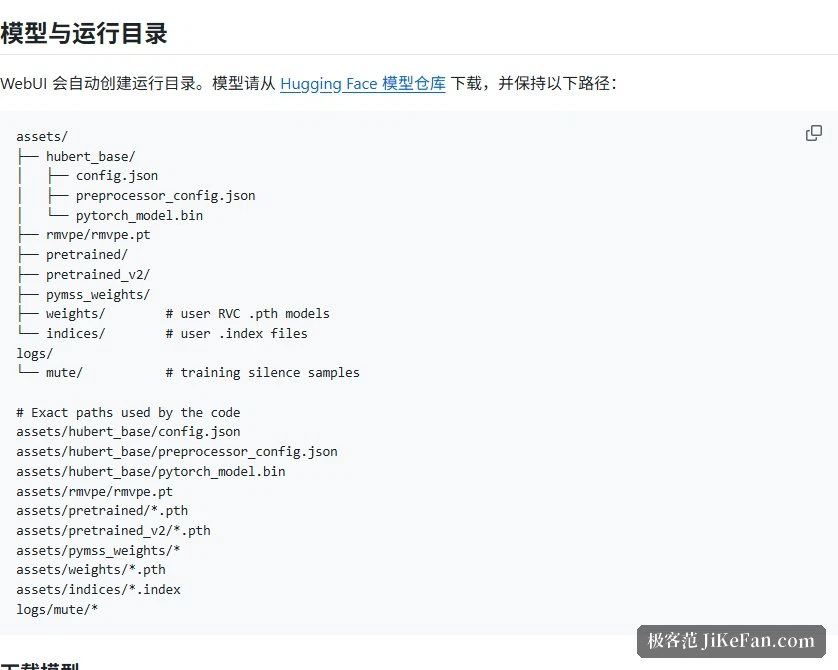
L'interface crée son dossier de travail toute seule, mais les modèles se téléchargent et se placent à la main. La structure exigée est fixe : hubert_base pour l'extraction des traits, les poids rmvpe pour la hauteur, pretrained et pretrained_v2 pour l'entraînement, pymss_weights pour la séparation des voix, weights pour les modèles personnels et indices pour les fichiers d'index.
Le téléchargement passe aussi par un outil en ligne de commande, groupé par usage. Un groupe est requis pour l'inférence et l'extraction, un autre pour l'entraînement v1 et v2, un troisième pour la séparation des voix reste optionnel, et un environnement DirectML sous Windows demande en plus des poids de hauteur au format onnx. Sous Windows, les deux exécutables FFmpeg doivent être déposés à la main à la racine du projet.
Changement de voix en direct et latence
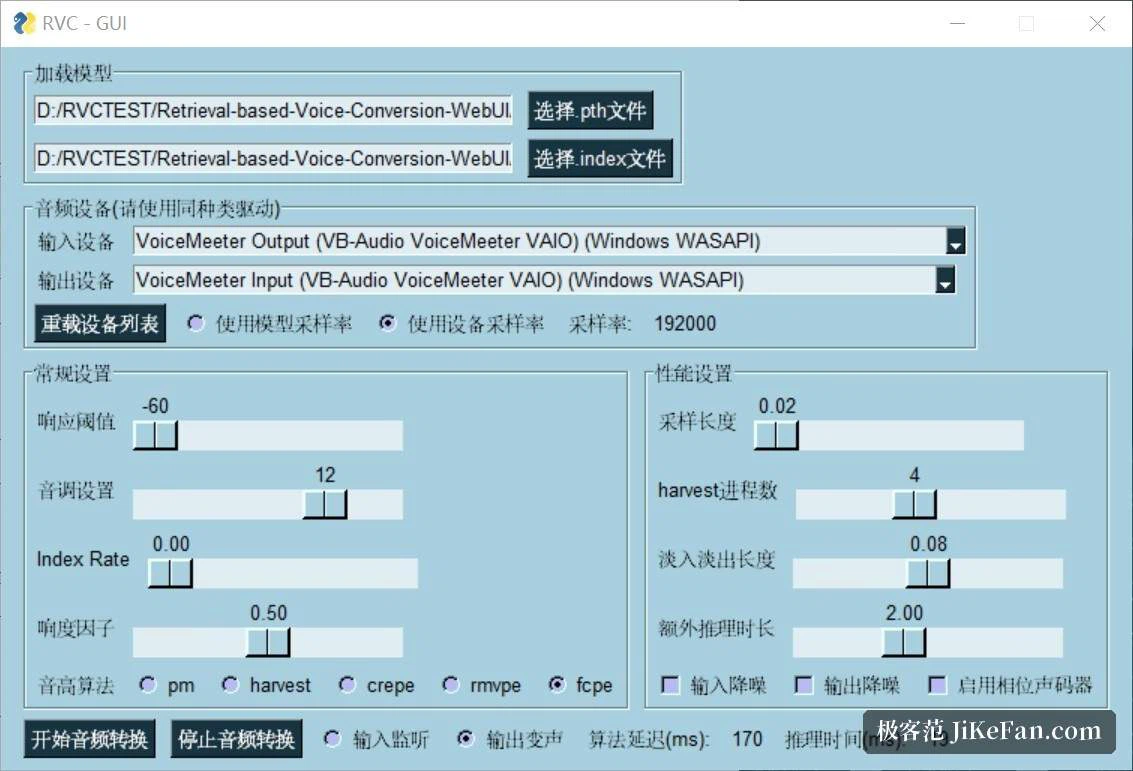
Deux entrées sont fournies, l'interface web et une interface dédiée au changement en direct. La latence est le chiffre à regarder : le projet annonce 170 millisecondes de bout en bout, et 90 millisecondes avec des périphériques ASIO en entrée et sortie, tout en reconnaissant que cela dépend fortement de la prise en charge par le pilote matériel.
L'extraction de hauteur est un maillon clé pour descendre à ce niveau. Le projet utilise l'algorithme RMVPE d'InterSpeech2023, décrit comme mettant fin au problème des voix étouffées, rapide et peu gourmand en ressources. L'interface permet aussi de revenir à pm, harvest ou crepe.
Lancement et licence
Le lancement tient en une commande, le port par défaut est 7865. Un serveur Ubuntu sans environnement graphique peut passer une option pour éviter l'ouverture automatique du navigateur. Les modèles personnels vont dans weights, les index dans indices.
La licence est MIT, et le modèle de base repose sur le jeu de données ouvert VCTK, que le projet juge sans souci de droits. Une chose reste de votre responsabilité : la conversion de timbre travaille sur la voix d'autrui, donc avant de publier le résultat, vérifiez que l'autorisation existe.