
F5-TTS livre du code MIT et des poids non commerciaux, installés en une ligne pip
Résumé
Un projet open source de synthèse vocale fondé sur le flow matching, avec paquet pip, inférence en ligne de commande et interface web Gradio. Le code est en MIT, les poids pré-entraînés sont non commerciaux à cause des données d'entraînement.
Recommander- Nom
- F5-TTS
- Version
- 1.1.22
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinuxmacOS
- Mis à jour
- 2026-10-06 20:44
F5-TTS est l'implémentation officielle d'un article, et l'article porte un titre espiègle : un conteur qui contrefait une parole fluide et fidèle grâce au flow matching. Le nom est léger, la voie technique ne l'est pas. La synthèse repose sur le flow matching, avec pour colonne vertébrale un Diffusion Transformer associé à ConvNeXt V2.
Le projet est open source, a publié plus de vingt versions, et le dépôt tient le modèle de base aux côtés du code d'inférence, d'entraînement et de déploiement.
Trois mots-clés : flow matching, ConvNeXt V2, Sway Sampling
Les notes du projet alignent trois points. Le premier est F5-TTS lui-même, qui associe un Diffusion Transformer à ConvNeXt V2 et que les auteurs décrivent comme plus rapide à entraîner comme à inférer. Le second est E2 TTS, une reproduction bâtie sur une structure Flat-UNet Transformer. Le troisième est Sway Sampling, une stratégie d'échantillonnage des pas de flux pendant l'inférence, dont les auteurs affirment qu'elle améliore visiblement le rendu.
Pour qui utilise l'outil, les deux premiers fixent le plafond de ce que le modèle sait faire, et le troisième fixe ce qu'un modèle donné produit réellement. Sway Sampling est le point intéressant parce qu'il agit au moment de l'inférence sans réentraînement, d'où sans doute sa ligne à part.
Installation : une ligne pip, ou passer à Docker
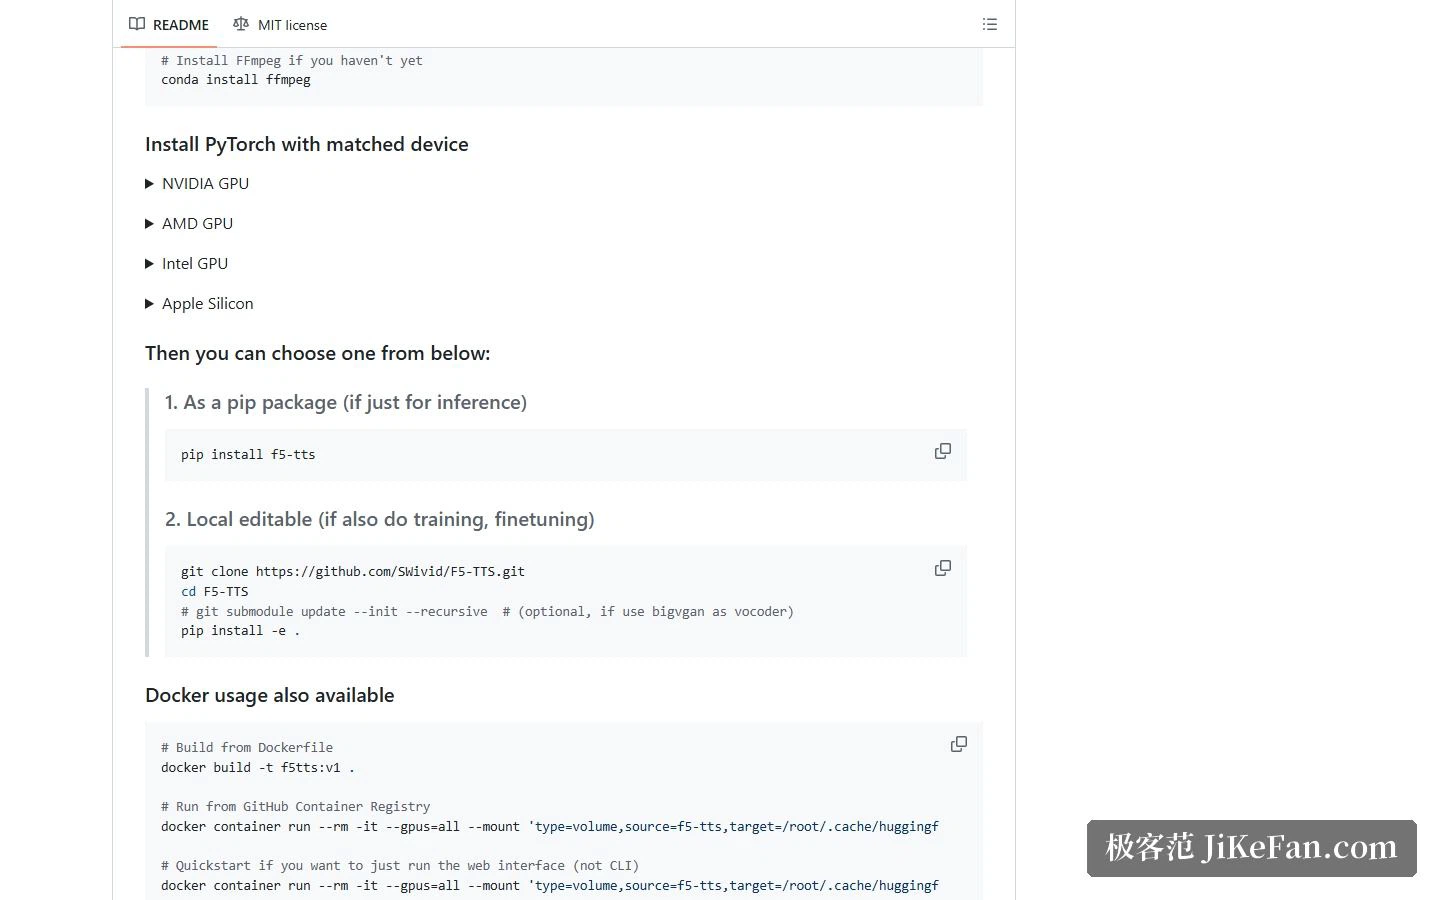
L'installation se sépare selon l'intention. Pour l'inférence seule, le paquet pip suffit. Pour entraîner ou affiner, il faut cloner le dépôt et faire une installation éditable. Avant de tirer PyTorch, on accorde la version au matériel ; les notes donnent des commandes distinctes pour NVIDIA, AMD, Intel et Apple Silicon.
Docker est l'autre voie : soit construire depuis le Dockerfile du dépôt, soit tirer l'image officielle et la lancer, et les notes incluent une commande raccourcie qui ne démarre que l'interface web.
Trois usages : terminal, page web, dialogue parlé
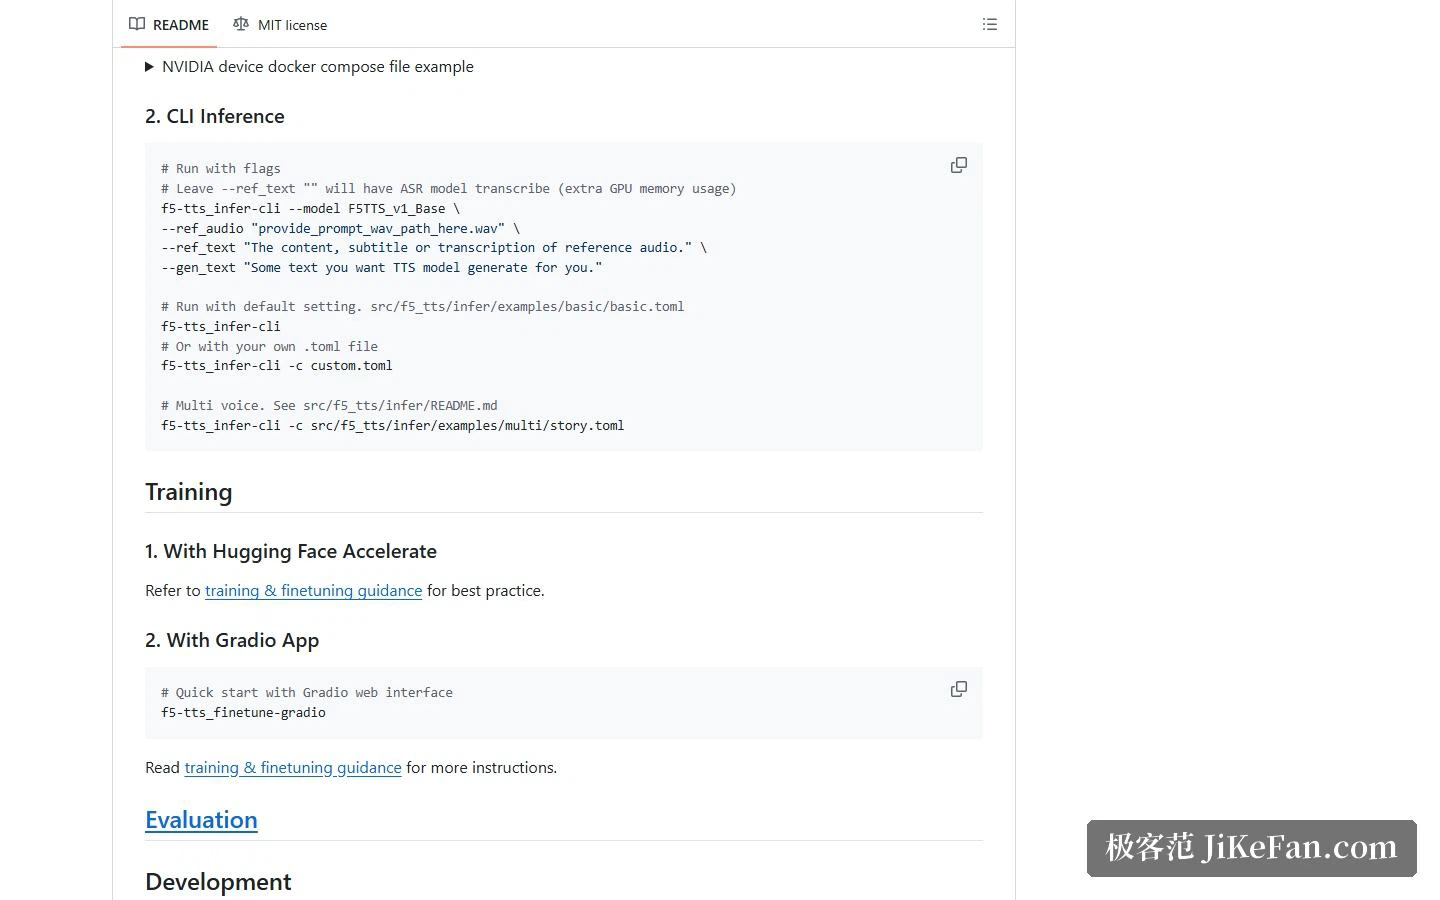
Les paramètres de la ligne de commande se suivent aisément : un extrait audio de référence, sa transcription, et le texte à prononcer ; le modèle lit le texte cible avec le timbre de la référence. Un détail mérite d'être connu : la transcription de référence peut rester vide, auquel cas un modèle de reconnaissance vocale la produit automatiquement, au prix d'un peu de mémoire supplémentaire.
Si le terminal rebute, démarrez l'interface Gradio. Les fonctions listées vont au-delà de la synthèse de base, jusqu'à la génération multi-styles et multi-locuteurs, plus un mode de dialogue parlé piloté par un modèle de langage affiné sur instructions de trois milliards de paramètres. La page ne se contente donc pas de transformer du texte en audio : elle peut tenir un tour de conversation en voix.
Les chiffres de performance, mesurés sur une seule L20
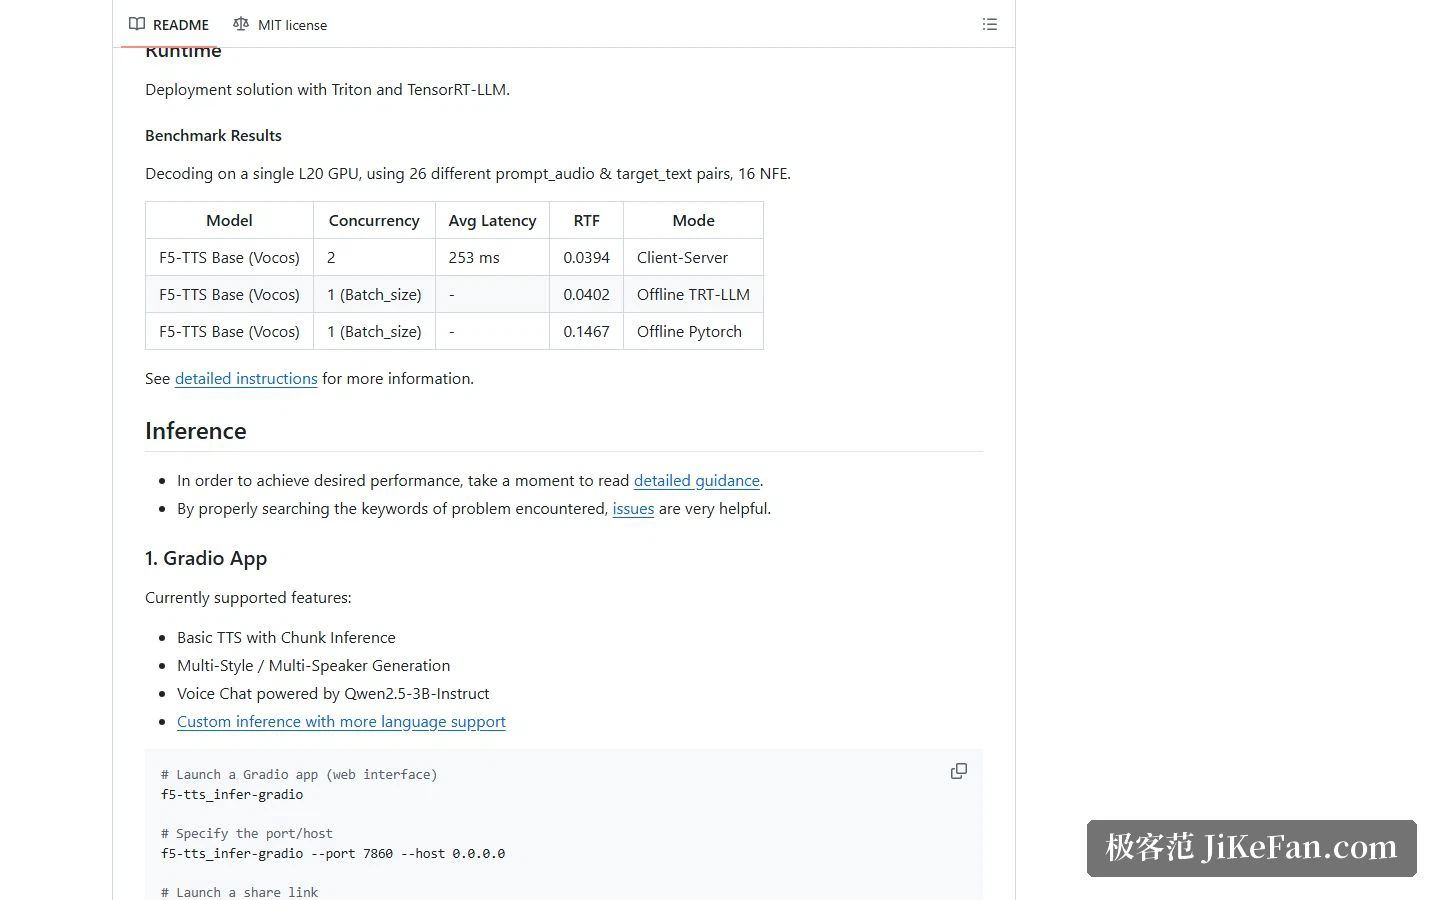
La section déploiement contient un benchmark : une carte L20, 26 paires d'audio de référence et de texte cible, 16 pas d'inférence. F5-TTS Base, en mode client-serveur avec une concurrence de 2, atteint 253 millisecondes de latence moyenne pour un facteur temps réel d'environ 0,0394 ; en TensorRT-LLM hors ligne, on obtient 0,0402, et en PyTorch hors ligne 0,1467. Plus le facteur est bas, plus la génération prend de l'avance sur la lecture, et l'écart entre ces trois valeurs montre le poids du choix de déploiement.
Entraînement et affinage
L'entraînement se sépare de la même façon, en deux chemins. L'un passe par Hugging Face Accelerate et convient à l'entraînement et à l'affinage ordinaires. L'autre est une page Gradio, et les notes fournissent une commande de démarrage pour une interface d'affinage dédiée, sans écrire de code. Pour qui veut simplement infléchir le modèle vers un timbre précis, le second chemin demande bien moins de travail.
La licence : code MIT, poids non commerciaux
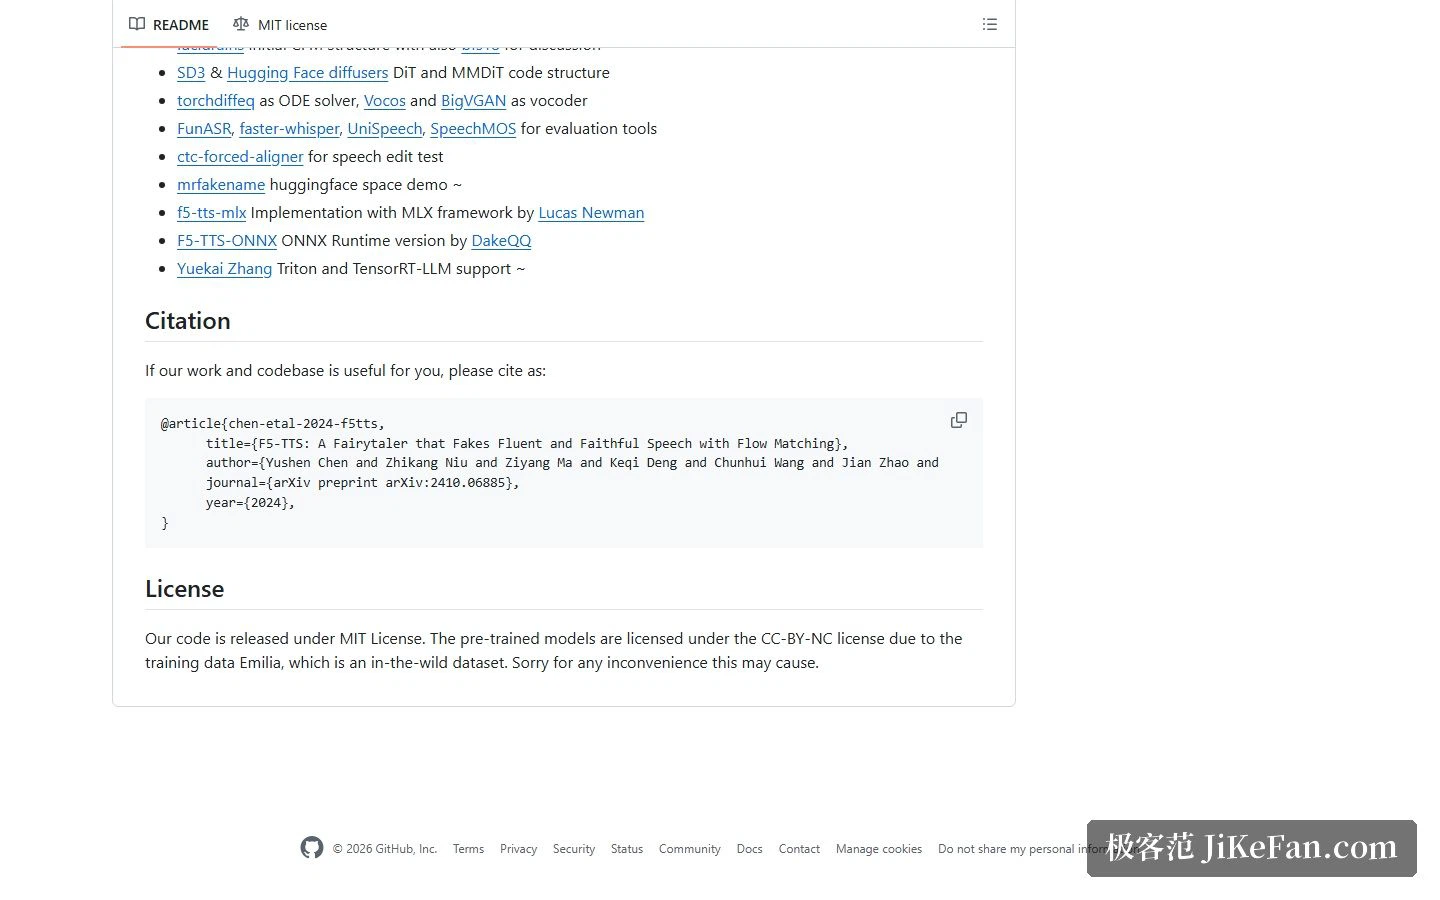
Cette partie mérite une lecture attentive. La section licence indique que le code est publié sous MIT, mais que les modèles pré-entraînés relèvent d'une autre licence : les données d'entraînement, Emilia, ayant été collectées en milieu ouvert, les poids sortent sous une licence Creative Commons non commerciale. Les auteurs s'en excusent dans le même paragraphe.
On est donc libre de bâtir sur le code, mais glisser les poids officiels tels quels dans un projet commercial se heurte à un mur de licence. Pour contourner, il faut généralement entraîner soi-même sur un jeu de données plus permissif, ce qui coûte du calcul et de la préparation.
Pour qui cela vaut
Pour un chercheur ou un développeur qui veut expérimenter sur un projet de synthèse vocale clairement structuré et activement itéré, la qualité du code et la complétude de la documentation tiennent : plusieurs voies d'installation, un déploiement couvrant Triton et TensorRT-LLM, et des entrées prêtes pour l'inférence comme pour l'entraînement.
Pour qui cherche simplement une synthèse vocale exploitable commercialement, il faut d'abord résoudre la licence, ou évaluer le coût d'un entraînement maison. Indépendamment du modèle, mieux vaut aussi établir d'abord l'autorisation autour du clonage de voix : produire des contenus avec la voix d'autrui, et surtout celle d'une personnalité publique, peut toucher au droit de la personnalité et au droit sur la voix.
Un projet ouvert pose la capacité sur la table et la restriction dans la section licence. Deux minutes de lecture avant de commencer coûtent en général moins qu'une reprise après coup.