
Whisper existe en six tailles, et la mémoire graphique tranche
Résumé
Un modèle de reconnaissance vocale généraliste qui enchaîne transcription, traduction vers l'anglais et détection de langue. Six tailles vont d'environ 39 millions à environ 1,55 milliard de paramètres, code et poids sous licence MIT.
Recommander- Nom
- Whisper
- Version
- 15.5
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinuxmacOS
- Mis à jour
- 2026-10-06 16:03
Un seul modèle à la place d'une chaîne
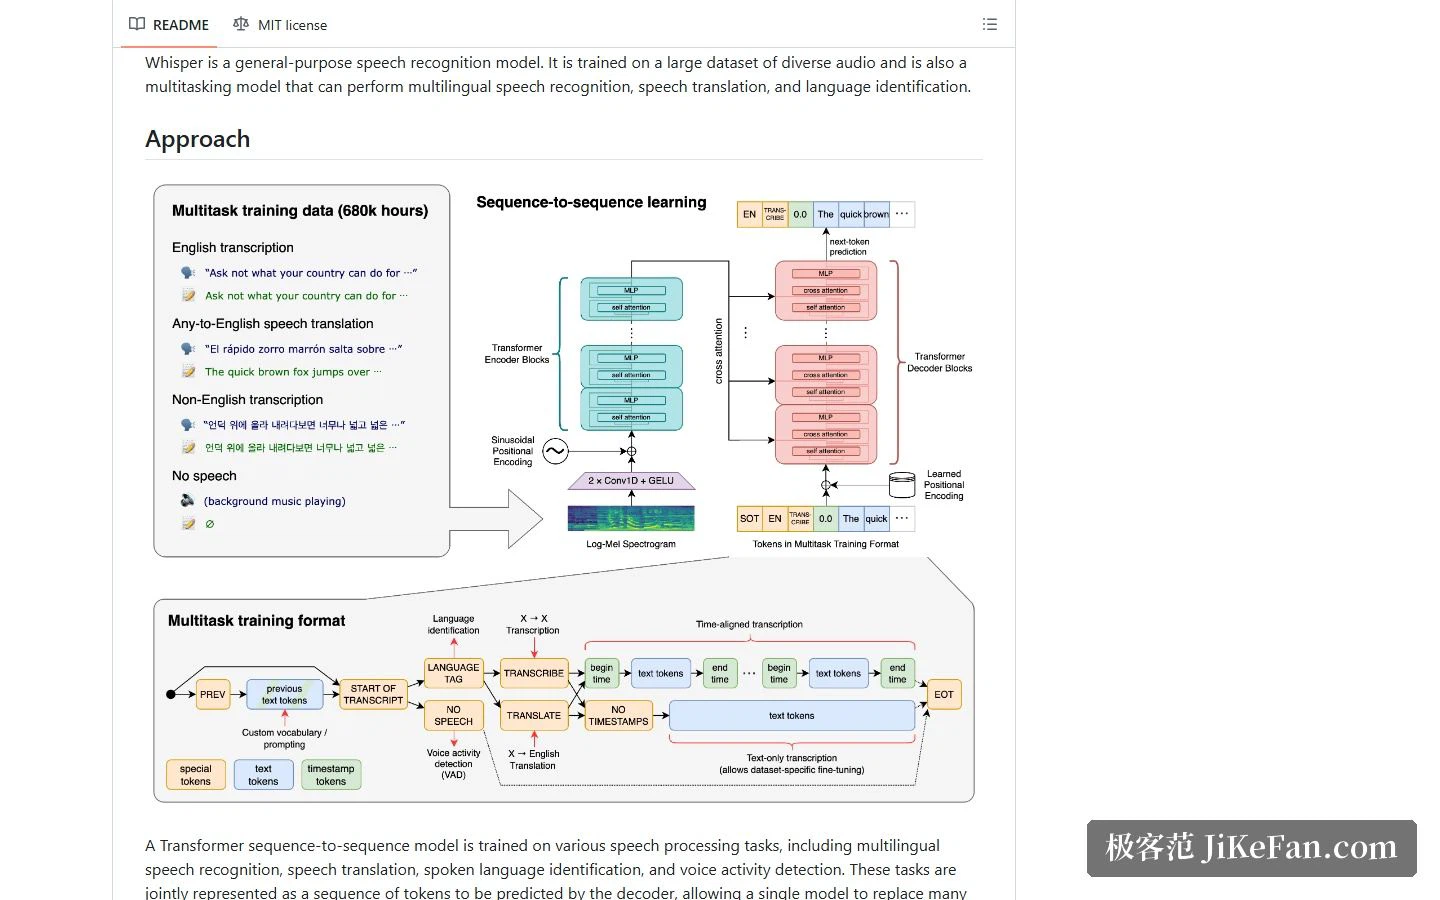
Whisper appartient à ces projets qui remplacent toute une chaîne par un seul modèle. Le traitement classique de la parole passe par plusieurs étapes : identifier la langue, puis transcrire, puis confier le résultat à un modèle de traduction distinct si besoin, la détection d'activité vocale restant souvent une étape à part. Whisper ramène ces tâches à une seule séquence de jetons que le décodeur prédit, apprise d'un bloc dans un unique transformeur encodeur-décodeur.
Le dépôt annonce 680 000 heures de données d'entraînement multitâche, collectées dans de nombreuses langues et des conditions d'enregistrement très variées. L'objectif affiché est simple : un modèle de reconnaissance vocale généraliste.
Quatre capacités, une seule direction de traduction
La liste officielle compte quatre entrées : transcription multilingue, traduction de la parole, identification de la langue parlée et détection d'activité vocale. Traduction signifie ici transformer directement de la parole non anglaise en texte anglais. Ce n'est pas une traduction entre paires de langues quelconques, et la nuance compte avant de bâtir un flux autour. Le chemin reste donc à sens unique, ce qu'il vaut mieux savoir avant de le prévoir.
Les longs enregistrements, par fenêtres de 30 secondes
L'audio long passe par une fenêtre glissante. La documentation explique que l'appel de transcription lit le fichier entier, puis prédit de façon autorégressive par fenêtres de 30 secondes. Un enregistrement d'une heure devient donc plus de cent fenêtres traitées à la suite, sans qu'il faille découper le fichier soi-même.
Choisir parmi six tailles
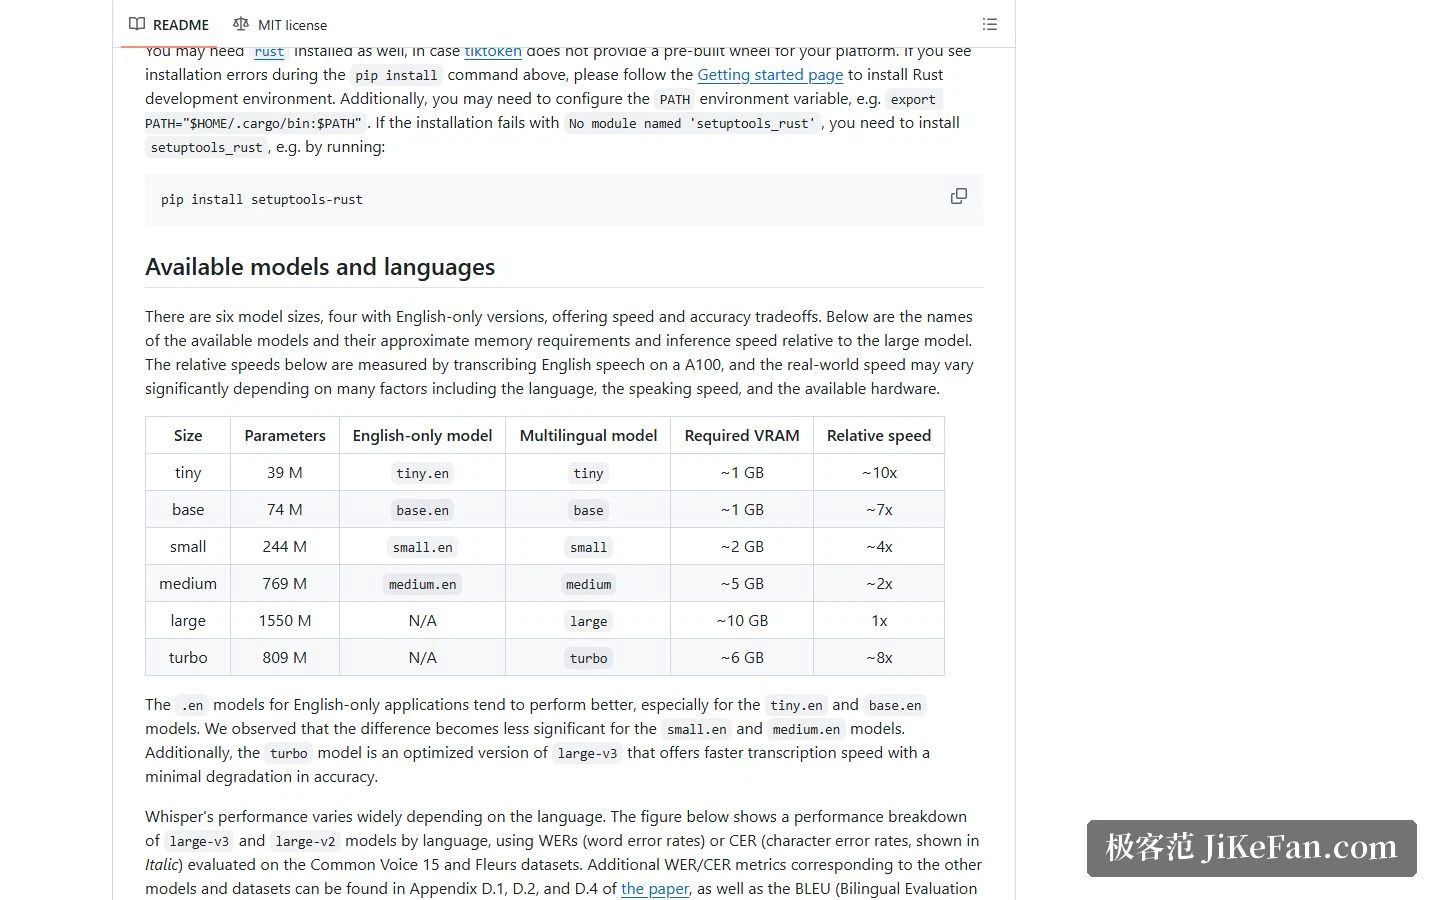
C'est le tableau à lire en premier. Six tailles existent, de tiny à environ 39 millions de paramètres jusqu'à large à environ 1,55 milliard, la mémoire requise montant d'environ 1 Go à environ 10 Go. La colonne de vitesse relative prend large comme référence : tiny tourne à environ 10 fois ce rythme, turbo à environ 8 fois. Vitesse et volume forment une courbe de compromis assez lisse.
Quand la mémoire manque, tiny et base tiennent tous deux dans environ 1 Go, ce qui reste jouable sur un portable ordinaire. Pour plus de précision, il faut monter vers medium et large. L'entrée turbo mérite un mot à part : le projet la décrit comme une version optimisée de large-v3 qui échange une très faible perte de précision contre une transcription nettement plus rapide, ce qui en fait le choix de compromis.
Quatre des tailles, tiny, base, small et medium, existent aussi en version anglaise uniquement. Le projet observe que ces variantes s'en sortent souvent mieux sur des tâches purement anglaises, l'écart se réduisant à mesure que le nombre de paramètres augmente.
Installation : pip et ffmpeg
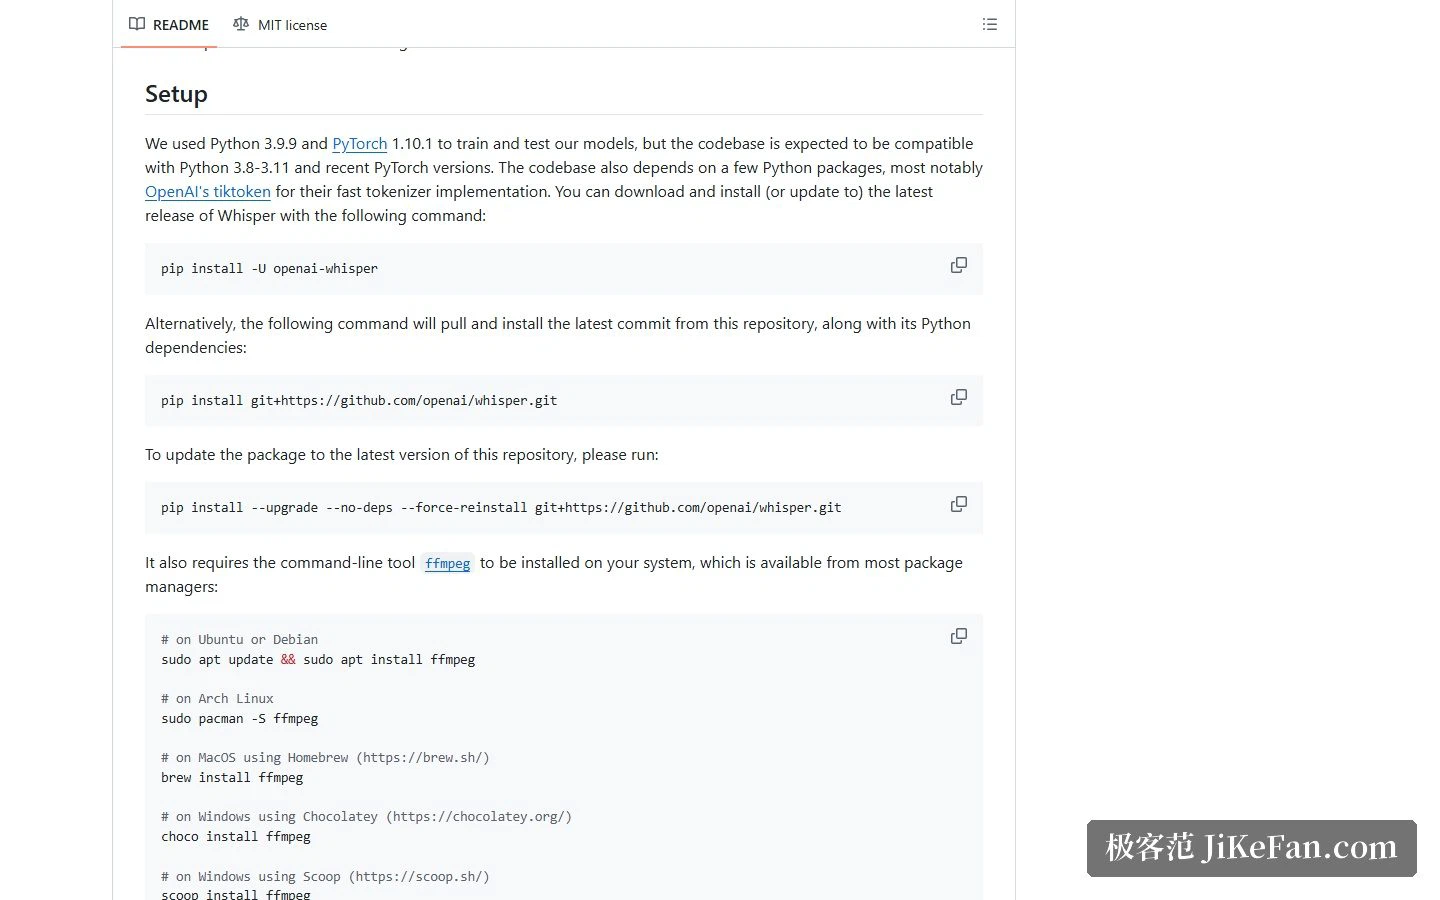
L'installation tient en une commande pip. Ce qui demande vraiment attention, c'est la dépendance système : Whisper appelle l'outil en ligne de commande ffmpeg pour décoder l'audio. Le projet liste les méthodes par système d'exploitation, et les gestionnaires de paquets courants sont couverts.
Un autre point. Le projet prévient que si la plateforme n'a pas de paquet de tokenisation déjà compilé, l'installation pip demandera un environnement Rust ; quand le message d'erreur signale un module introuvable, installer le paquet correspondant règle la question. Côté versions, la base de code prend en charge Python 3.8 à 3.11 et des versions de PyTorch assez récentes.
Deux entrées : shell et Python
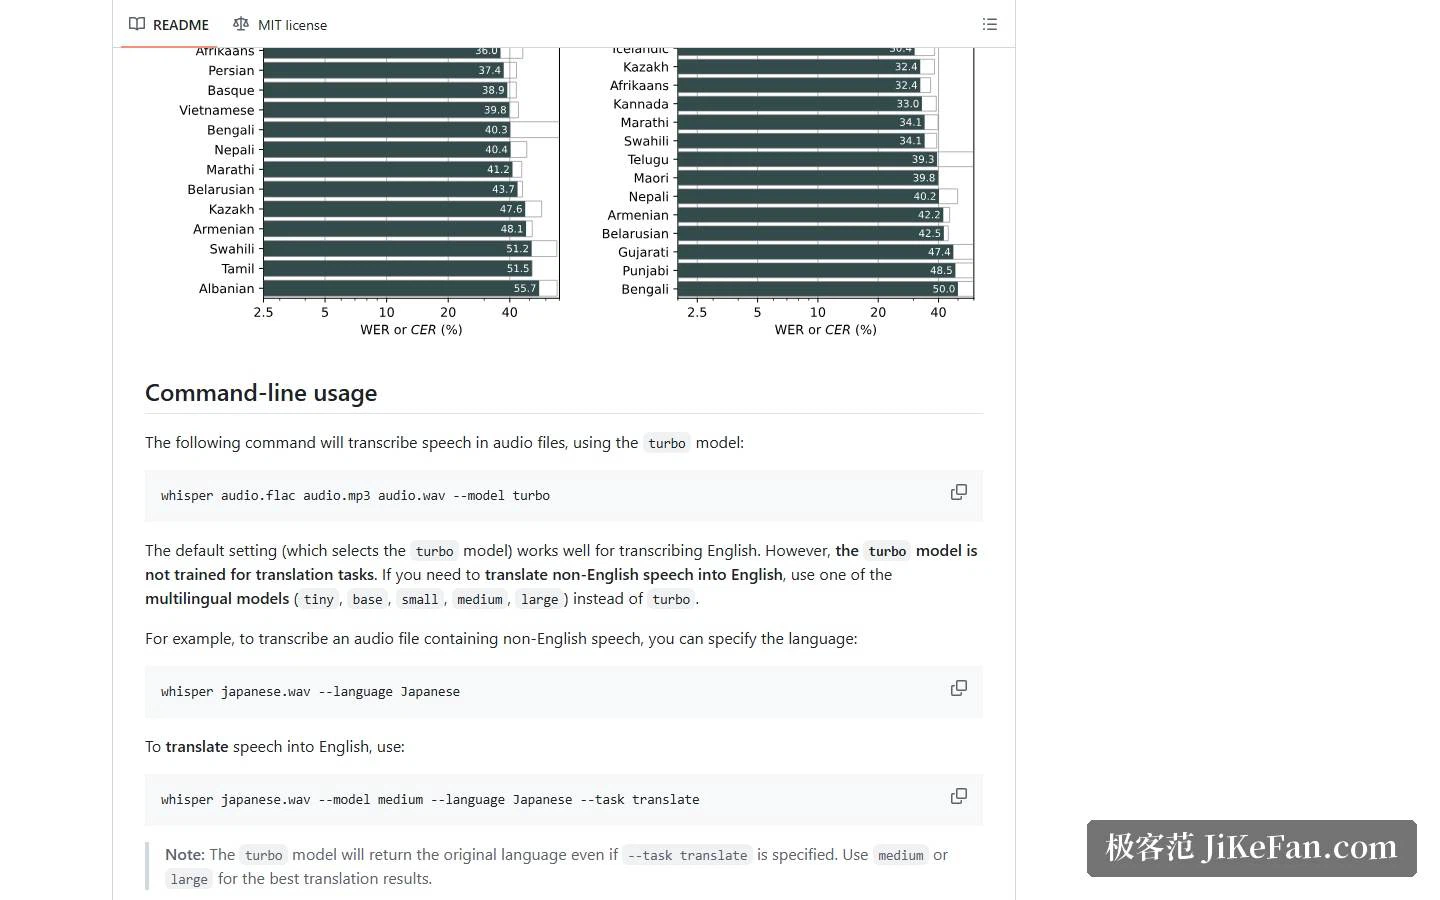
La ligne de commande est le test le plus rapide. Le fichier audio en argument, la taille désignée par l'option de modèle, l'option de langue ajoutée quand l'audio n'est pas en anglais, et l'option de tâche basculée sur la traduction quand c'est le but.
Une limite à retenir : le projet indique clairement que turbo n'a jamais été entraîné pour la traduction. Même avec la tâche de traduction sélectionnée, il renvoie la langue d'origine. Il faut alors revenir à tiny, base, small, medium ou large, et le projet recommande medium ou large pour de meilleurs résultats.
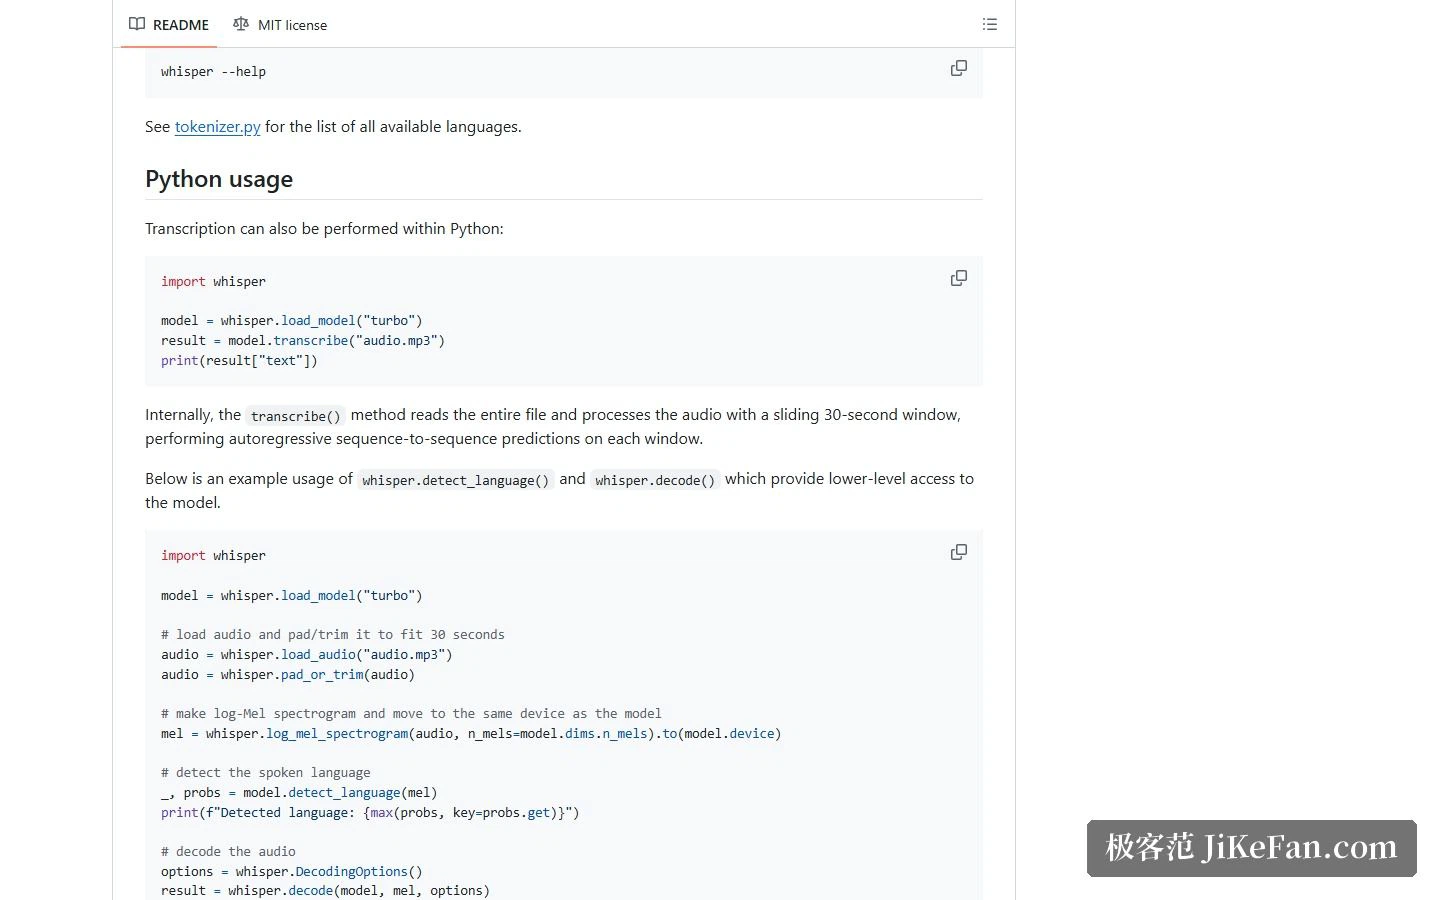
L'appel en Python est tout aussi court. Charger le modèle, passer le chemin de l'audio à la méthode de transcription, lire le champ texte du résultat. Une interface de plus bas niveau est également exposée, pour charger l'audio soi-même, calculer le spectrogramme log-mel et appeler la détection de langue ou le décodage séparément quand le travail doit s'insérer dans un traitement plus vaste.
La licence est un vrai atout
Le code et les poids sont tous deux publiés sous MIT, avec très peu de restrictions commerciales. Ce n'est pas la norme en reconnaissance vocale, où beaucoup de modèles attachent un accord distinct et plus strict à leurs poids. Si l'objectif est d'intégrer la transcription à son propre produit, cela évite pas mal d'échanges juridiques.
À qui cela convient
S'il s'agit de sous-titrer des vidéos en série, de transformer des enregistrements de réunion en texte, ou d'ajouter une transcription locale à une application, le coût d'entrée est faible : une commande pour installer, une pour lancer, et six tailles à essayer en partant du bas. Avec la licence MIT, la paperasse ne revient pas une fois l'intégration en marche.
Ce n'est pas universel. La traduction ne va que vers l'anglais. Les cas exigeant du temps réel demandent d'abord une évaluation du matériel. Et la précision en milieu bruyant suit directement la qualité de l'enregistrement. Vu comme un outil de transcription hors ligne fiable, les attentes tiennent.
Un code ouvert sous licence permissive, voilà pourquoi tant de projets prennent Whisper comme choix par défaut. L'outil lui-même n'est plus l'obstacle ; la différence restante tient souvent à la propreté de l'audio qu'on lui donne.