
WhisperX ajoute l'horodatage au mot et l'étiquette du locuteur
Résumé
Une chaîne qui comble deux manques de Whisper : l'horodatage s'arrête à la phrase et le traitement par lots n'existe pas. WhisperX aligne de force pour dater chaque mot, étiquette les locuteurs et annonce 70 fois le temps réel sur large-v2.
Recommander- Nom
- WhisperX
- Version
- 3.8.7
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinuxmacOS
- Mis à jour
- 2026-10-06 19:53
Deux choses que Whisper laisse de côté
WhisperX naît d'un reproche très concret. Whisper transcrit avec précision, mais ses horodatages s'arrêtent à la phrase. Qui fabrique des sous-titres découvre vite que le texte et l'image dérivent, quelques secondes de décalage étant la norme. Et Whisper n'apporte aucun traitement par lots de lui-même.
La réparation tient en deux étapes ajoutées. D'abord le transcript est aligné de force sur l'audio, ce qui fait descendre l'horodatage jusqu'au mot. Ensuite l'audio est découpé par locuteur, et chaque ligne reçoit l'indication de qui parle. Le projet réunit cela en une chaîne et l'expose par une ligne de commande et une interface Python.
Une chaîne en quatre étapes
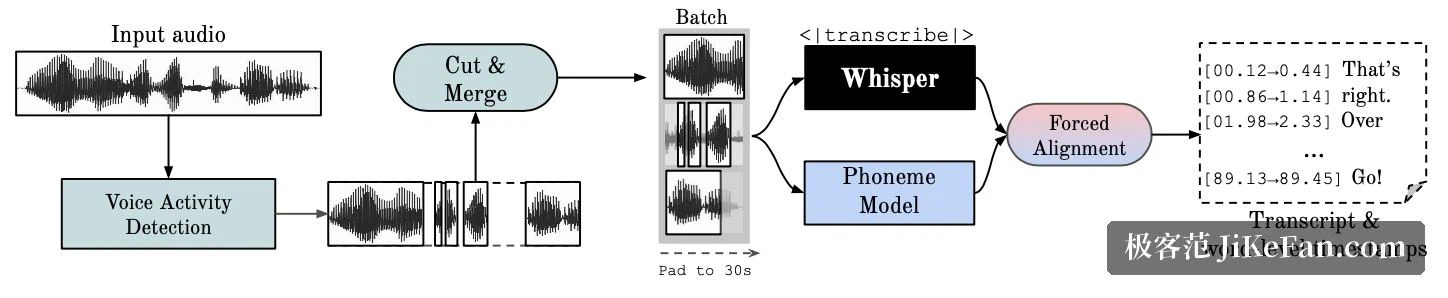
Le schéma du dépôt découpe le travail en quatre. La détection d'activité vocale passe d'abord et filtre les plages silencieuses. Le modèle de transcription produit ensuite le texte par lots. Un modèle de reconnaissance au niveau du phonème réalise l'alignement forcé et fournit les horodatages par mot. Enfin un modèle de séparation des locuteurs distingue les voix.
Les chiffres clés figurent dans la description. L'inférence par lots sur large-v2 atteint 70 fois le temps réel. Le moteur de transcription est faster-whisper, et large-v2 avec une taille de beam de 5 demande moins de 8 GB de mémoire graphique. Les horodatages par mot viennent de l'alignement forcé wav2vec2. La séparation des locuteurs vient de pyannote-audio et sort des identifiants de locuteur. L'article derrière la chaîne est paru à INTERSPEECH 2023, sur la transcription d'audio long précise dans le temps.
L'étape de détection d'activité vocale a un effet secondaire à signaler. Le projet indique qu'elle réduit les hallucinations sans perdre en précision de reconnaissance, et qu'elle facilite le traitement par lots, ce qui compte parmi les conditions de la vitesse atteinte.
Installation : une ligne pip
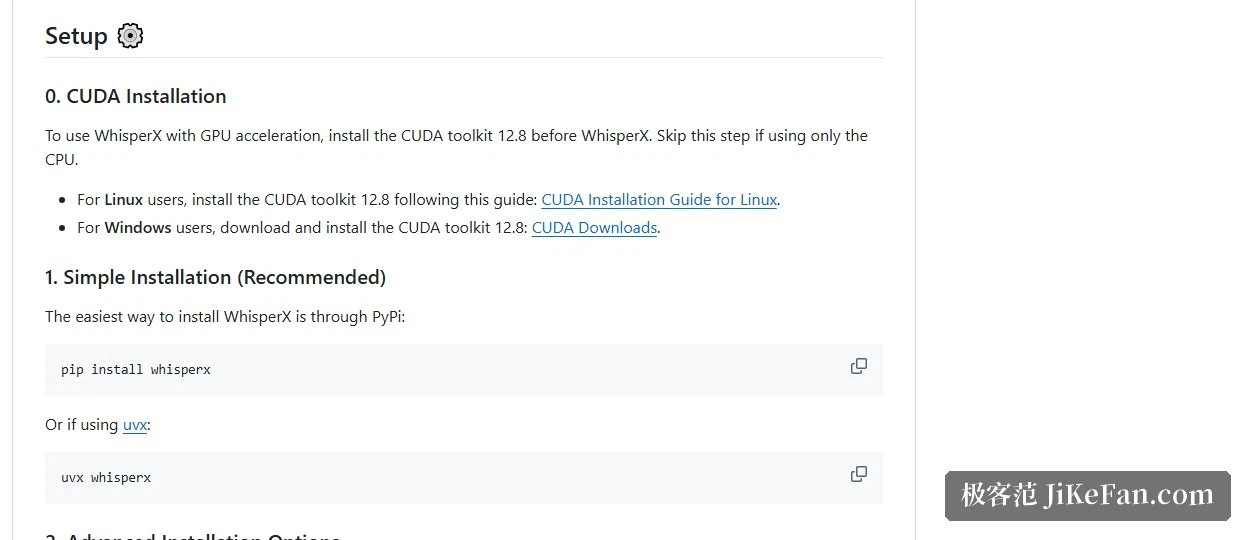
L'installation recommandée est courte : une commande pip. Sur une machine qui possède déjà uv, uvx lance l'outil sans l'installer d'abord dans un environnement. L'accélération GPU suppose CUDA 12.8 en place. En CPU seul, cette étape se saute.
La séparation des locuteurs demande davantage. Un jeton d'accès Hugging Face doit être passé en ligne de commande, et les conditions d'utilisation acceptées d'abord sur la page du modèle. La transcription et l'alignement tournent sans réseau ; c'est à la séparation qu'entrent le téléchargement du modèle et l'autorisation.
La ligne de commande en pratique
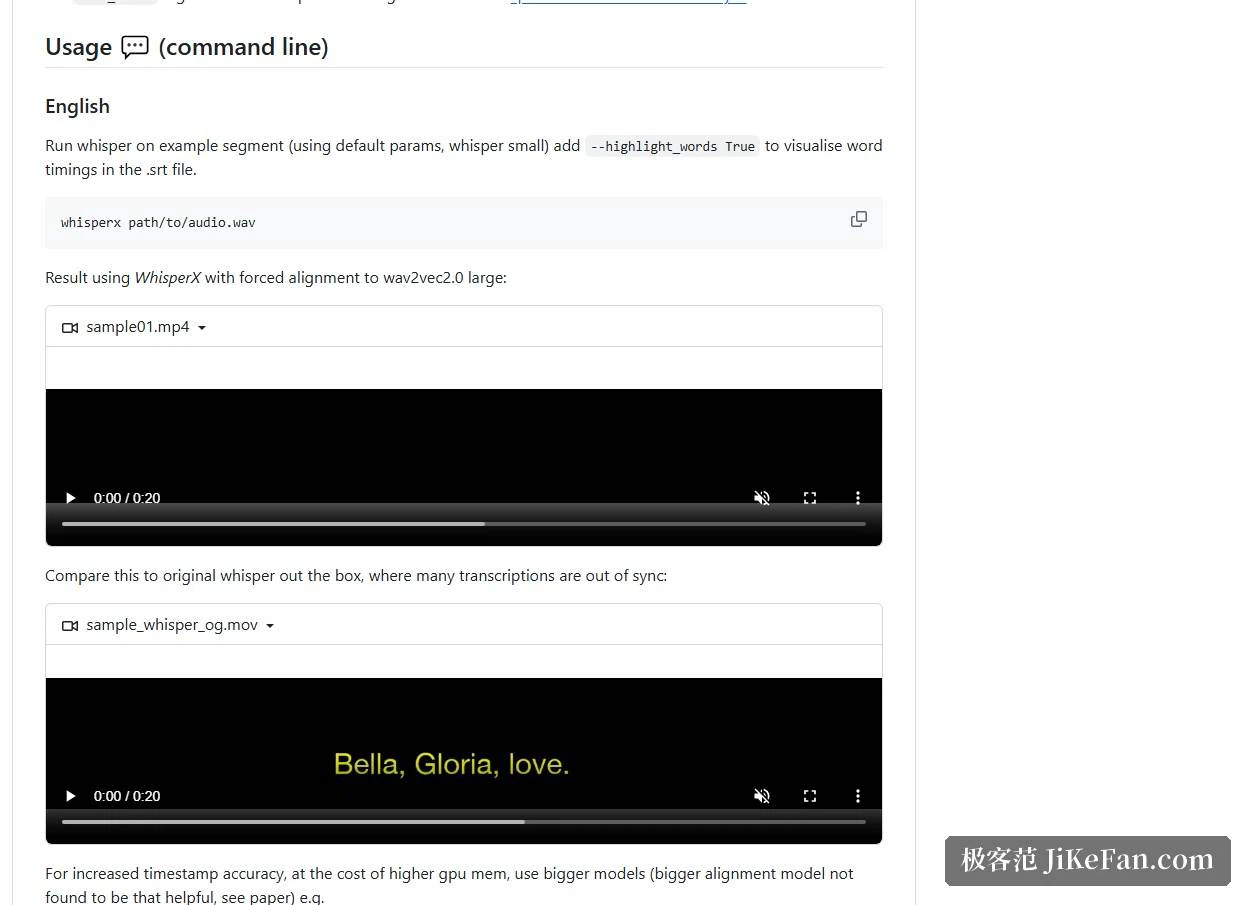
L'appel de base prend un chemin audio et tourne avec un modèle plus petit et les réglages par défaut. Des horodatages plus serrés supposent un modèle plus gros plus un modèle d'alignement nommé explicitement, payés en mémoire graphique. Un audio à plusieurs voix prend l'option de séparation, et la mise en évidence mot par mot s'active pour vérifier chaque instant séparément.
Aucune carte graphique n'est requise. Deux options déplacent le calcul sur le CPU, ce qui couvre aussi, selon le projet, l'exécution sur un Mac. Une réserve : le modèle de phonèmes servant à l'alignement est préparé par langue. L'anglais, le français, l'allemand, l'espagnol et l'italien ont des réglages prêts ; les autres langues demandent de trouver un modèle adapté et de le tester.
faster-whisper de son côté
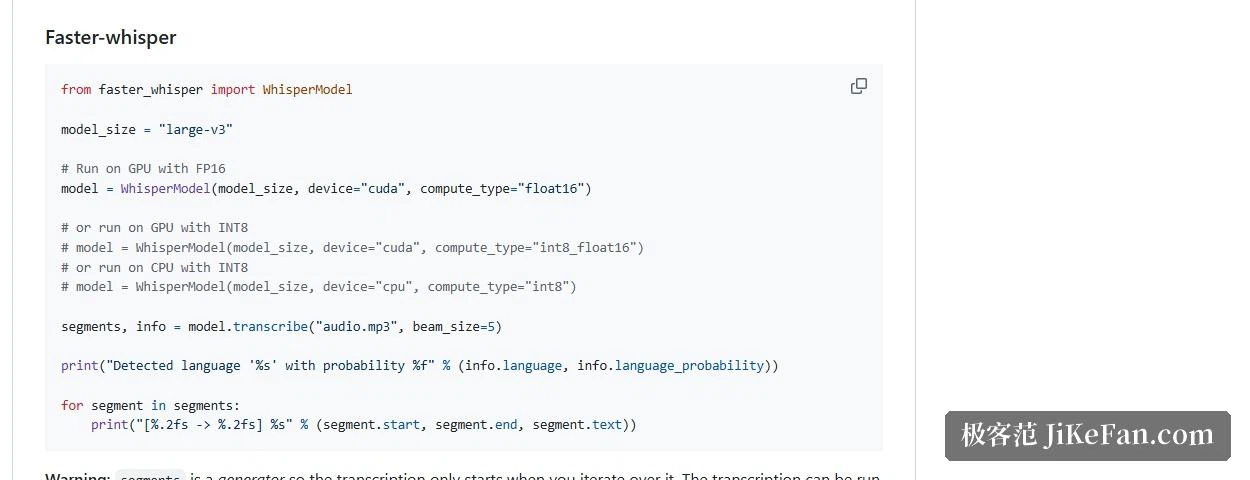
L'étape de transcription appartient à faster-whisper, une implémentation libre distincte qui réécrit Whisper sur le moteur d'inférence CTranslate2. Le projet l'annonce jusqu'à 4 fois plus rapide que l'original à précision égale, avec une empreinte mémoire plus faible, et la quantification en 8 bits sur CPU comme sur GPU ajoute un cran.
Si la transcription suffit, sans alignement par mot ni séparation des locuteurs, l'employer seul est plus léger. L'installation est de nouveau une commande pip, et il est plus accommodant côté dépendances système : contrairement à l'original, il n'exige pas FFmpeg installé sur la machine, le décodage audio passant par PyAV, qui embarque les bibliothèques FFmpeg dans son propre paquet. Python 3.9 ou plus est requis.
Les mesures publiées
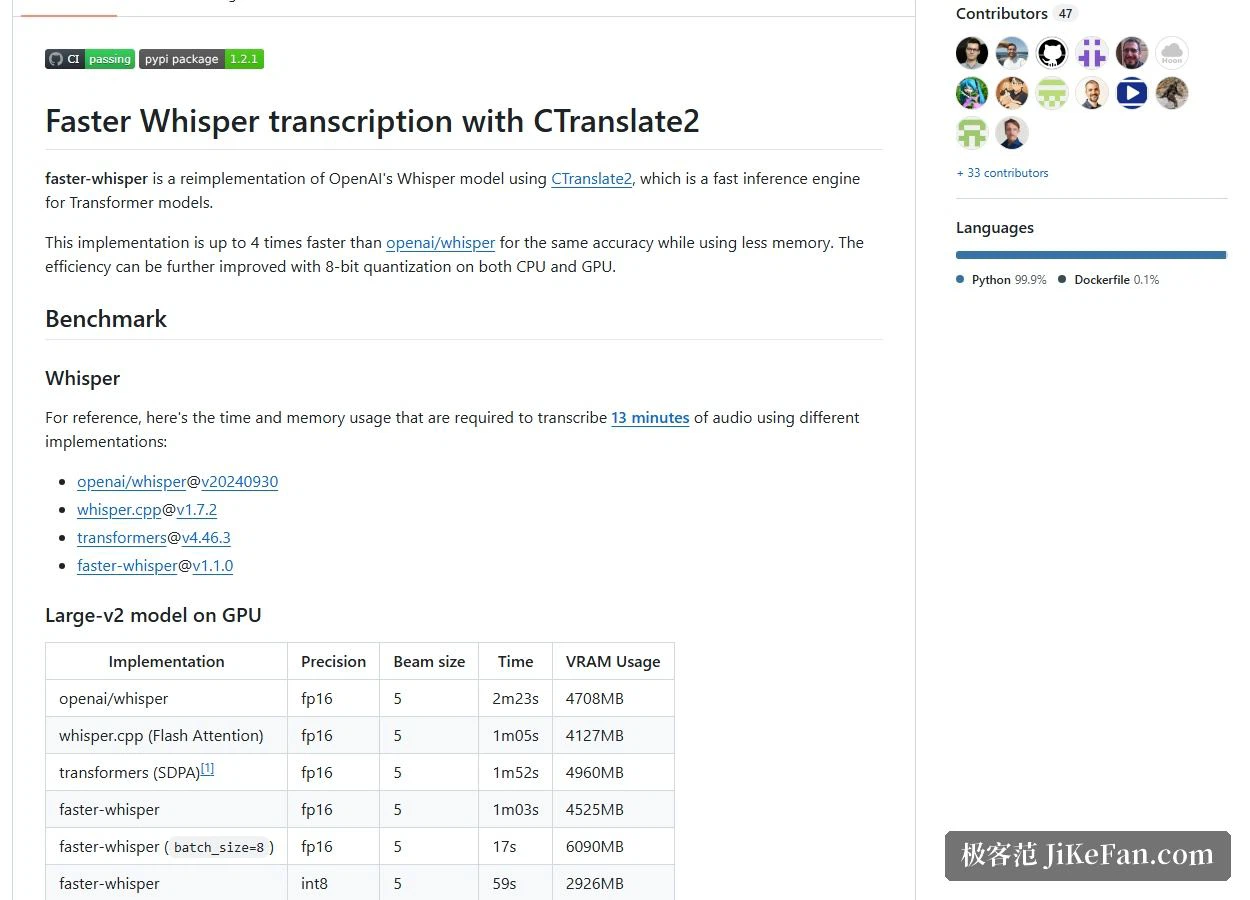
Une comparaison reproductible est fournie : 13 minutes d'audio, une RTX 3070 Ti de 8 GB, le modèle large-v2, fp16, taille de beam 5.
L'implémentation d'origine a demandé 2 minutes 23 secondes à 4708 MB. whisper.cpp avec Flash Attention est à 1:05 pour 4127 MB. faster-whisper simple : 1:03 pour 4525 MB. Avec une taille de lot de 8, faster-whisper tombe à 17 secondes pour 6090 MB. En int8, 59 secondes pour 2926 MB, et int8 avec lots de 8 boucle en 16 secondes pour 4500 MB.
La ligne à regarder est celle des lots. À précision fp16 identique, un fichier à la fois prend 1:03 et le mode par lots 17 secondes. Si la mémoire manque, int8 ramène l'empreinte à 2926 MB. Il existe aussi des chiffres CPU : un petit modèle sur un processeur de bureau à huit fils demande 6 minutes 58 secondes dans l'original, contre 51 secondes pour faster-whisper en int8 par lots.
Le projet prévient également qu'une comparaison exige des paramètres alignés : même taille de beam, précision comparable, même nombre de fils en CPU. Sinon les chiffres ne se comparent pas. L'original se règle par défaut sur un beam de 1, faster-whisper sur 5.
L'appel depuis Python
Dans un script, l'interface de faster-whisper tient en quelques lignes : nommer la taille du modèle, le périphérique et la précision de calcul, puis appeler transcribe. Un détail à retenir : le résultat est un générateur. Le calcul réel a lieu quand on commence à le parcourir, donc il faut le convertir en liste ou boucler dessus, sinon on croit que rien n'a tourné. Le traitement par lots est une autre interface : envelopper le modèle et donner une taille de lot. Les horodatages par mot viennent d'une option, ensuite début et fin arrivent mot par mot. Pour filtrer les longs silences, activer le filtre VAD ; par défaut tout ce qui dépasse 2 secondes est retiré, et ce seuil se change.
Des limites à connaître d'avance
L'alignement par mot n'est pas universel. Le projet liste les cas clairement. Les années abrégées et les montants portant un symbole monétaire ne peuvent pas être situés, donc ils n'obtiennent aucun horodatage. La parole qui se chevauche est mal traitée par Whisper comme par WhisperX. La séparation des locuteurs elle-même est loin d'être parfaite. Et les modèles d'alignement sont par langue : changer de langue, c'est changer de modèle.
BSD et MIT
WhisperX est libre sous BSD, faster-whisper sous MIT, et les deux placent un fichier de licence à la racine du dépôt. Des conditions permissives signifient que l'intégration à une chaîne de sous-titrage, ou un développement par-dessus, ne rencontre guère d'obstacle d'autorisation.
À qui cela convient
Si le but est de transformer de longs audios en fichiers de sous-titres directement utilisables, la valeur tient à cette chaîne : horodatage au mot, locuteurs séparés sur du matériel à plusieurs voix, et une ligne de commande comme une interface Python pour s'insérer dans un processus existant. À 70 fois le temps réel sur large-v2, du matériel compté en heures sent la différence.
Ce n'est pas une application de bureau qu'on installe et qu'on oublie. L'environnement est à monter soi-même, les modèles et les langues à choisir soi-même, et pour la plupart des gens le vrai obstacle n'est pas la commande mais l'arbitrage entre la carte et la taille du modèle. Si le besoin se limite à sortir des mots d'un enregistrement, sans horodatage au mot, faster-whisper seul est moins encombrant.