
CosyVoice couvre 9 langues et 18 dialectes chinois, avec clonage zéro-shot
Résumé
Un modèle de synthèse vocale open source dont la dernière génération gère le clonage zéro-shot interlangue, 9 langues étrangères et plus de dix dialectes et accents chinois, publié sous licence Apache 2.0.
Recommander- Nom
- CosyVoice
- Version
- 3
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinuxmacOS
- Mis à jour
- 2026-10-06 19:49
La plupart des modèles vocaux open source vendent la même idée : à quel point cela sonne humain. CosyVoice prend un autre angle et met la couverture en avant — 9 langues, 18 dialectes et accents chinois, plus le clonage zéro-shot interlangue. Le dépôt se décrit simplement comme un grand modèle multilingue de génération vocale, avec une chaîne complète d'inférence, d'entraînement et de déploiement.
Le code est sous licence Apache 2.0, et la génération actuelle s'appelle Fun-CosyVoice 3.0. Officiellement, c'est un système de synthèse vocale bâti sur un grand modèle de langage, qui progresse sur trois fronts face à CosyVoice 2.0 : cohérence du contenu, similarité du locuteur et naturel de la prosodie.
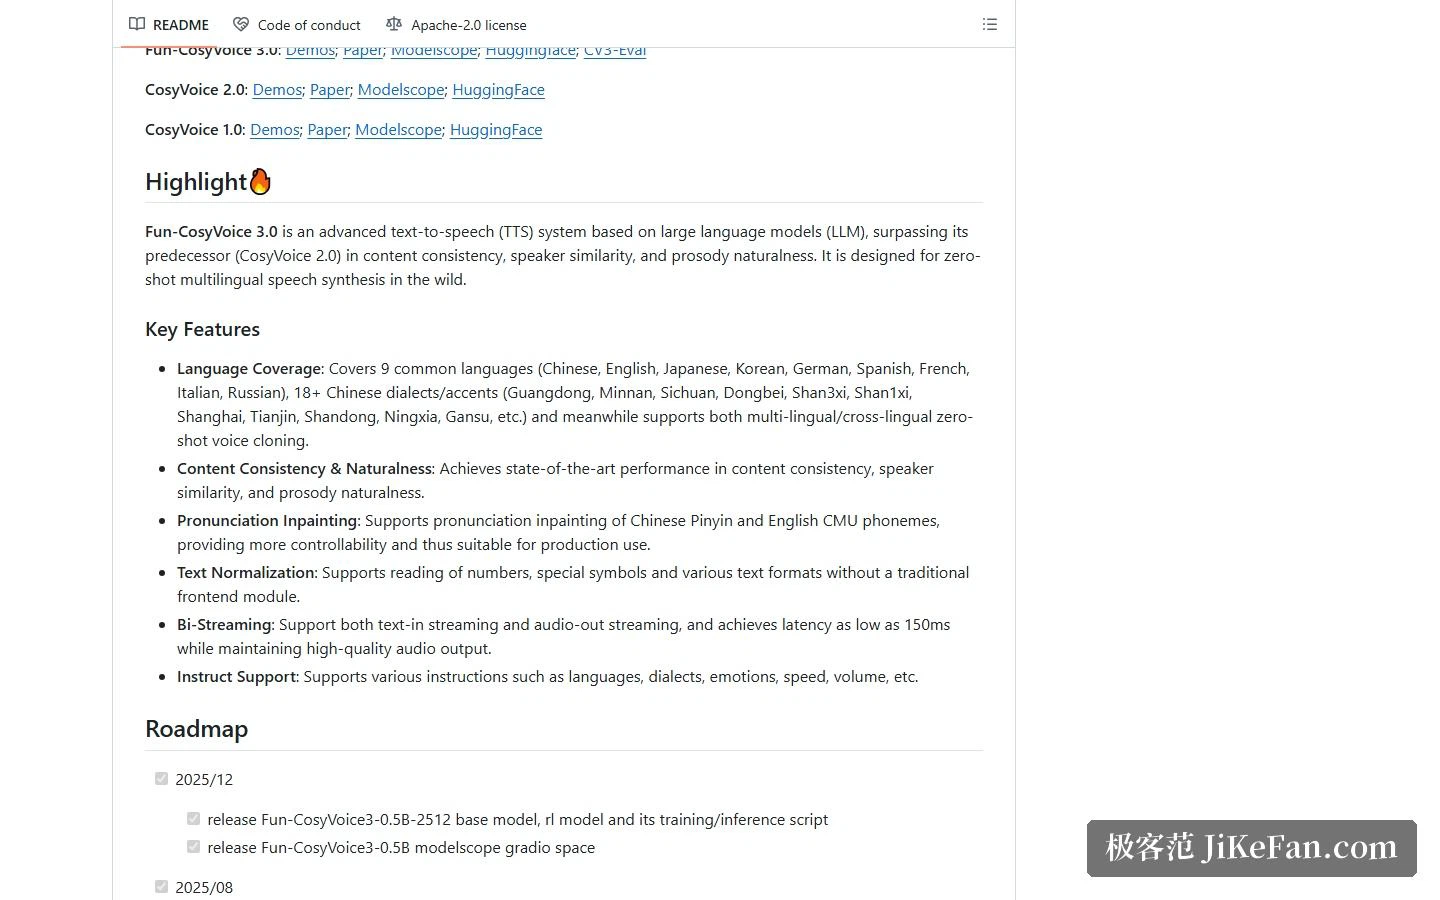
Commencer par la couverture : 9 langues, 18 dialectes chinois
Les neuf langues annoncées sont le chinois, l'anglais, le japonais, le coréen, l'allemand, l'espagnol, le français, l'italien et le russe. Pour qui travaille en chinois, la ligne des dialectes compte davantage : plus de 18 dialectes et accents chinois, les exemples officiels citant le Guangdong, le Minnan, le Sichuan, le Nord-Est, le Shaanxi, le Shanxi, Shanghai, Tianjin, le Shandong, le Ningxia et le Gansu.
La difficulté d'un dialecte n'est pas de savoir si le modèle peut prononcer les mots. Elle tient à des corpus rares et à un système phonétique très éloigné du mandarin standard. Inscrire les dialectes parmi les caractéristiques principales indique que l'investissement dans la matière chinoise était délibéré et non accessoire.
Clonage zéro-shot, et pilotage du ton par instruction
Sur le clonage, la description officielle réunit multilingue et interlangue dans la même phrase : un échantillon enregistré dans une langue peut piloter la synthèse dans une autre, sans nouveau jeu de données par langue.
L'autre fonction pratique est le contrôle par instruction : langue, dialecte, émotion, débit et volume se spécifient à l'avance. Pour qui produit des contenus parlés, c'est bien plus maîtrisable que de régénérer jusqu'à ce que quelque chose tombe juste. La correction de prononciation est listée à part, avec intervention par pinyin chinois et phonèmes CMU anglais, de quoi réparer à la main un caractère polyphonique ou un nom propre étranger.
Inférence en flux : une latence descendue à environ 150 millisecondes
La liste des caractéristiques promet un flux bidirectionnel — texte entrant, audio sortant — avec une latence aussi basse que 150 millisecondes tout en maintenant la qualité audio. Ce chiffre décide du temps réel. Si la synthèse doit entrer dans un robot de support ou un assistant vocal, la latence trace la frontière entre utilisable et inutilisable.
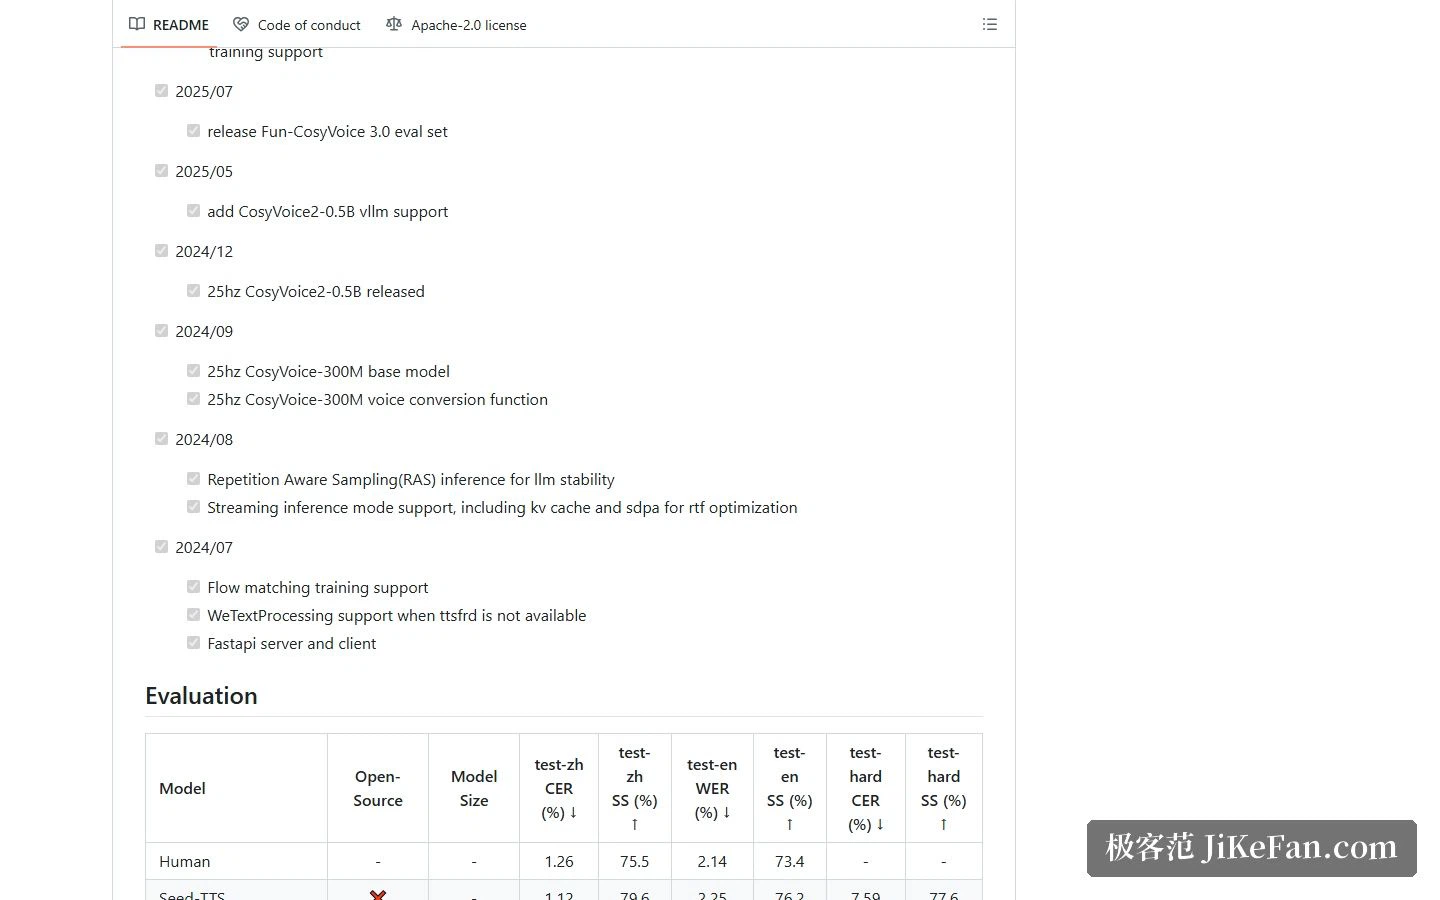
Quelle version, quel modèle
Trois générations existent à ce jour : CosyVoice 1.0, CosyVoice 2.0 et Fun-CosyVoice 3.0, chacune avec un article et une entrée de dépôt de modèle. Les points de contrôle téléchargeables sont plus nombreux : CosyVoice-300M à environ trois cents millions de paramètres, sa variante affinée 300M-SFT et sa variante à instructions 300M-Instruct, puis CosyVoice2-0.5B et le tout dernier Fun-CosyVoice3-0.5B.
La documentation recommande explicitement Fun-CosyVoice3-0.5B, au motif qu'il performe mieux. Si le travail repose sur le contrôle par instruction, prenez une version portant Instruct dans son nom ; s'il s'agit seulement de faire tourner la chaîne, la version à trois cents millions est plus petite et pèse bien moins sur la mémoire.
Installation : un environnement Conda et un téléchargement de modèle
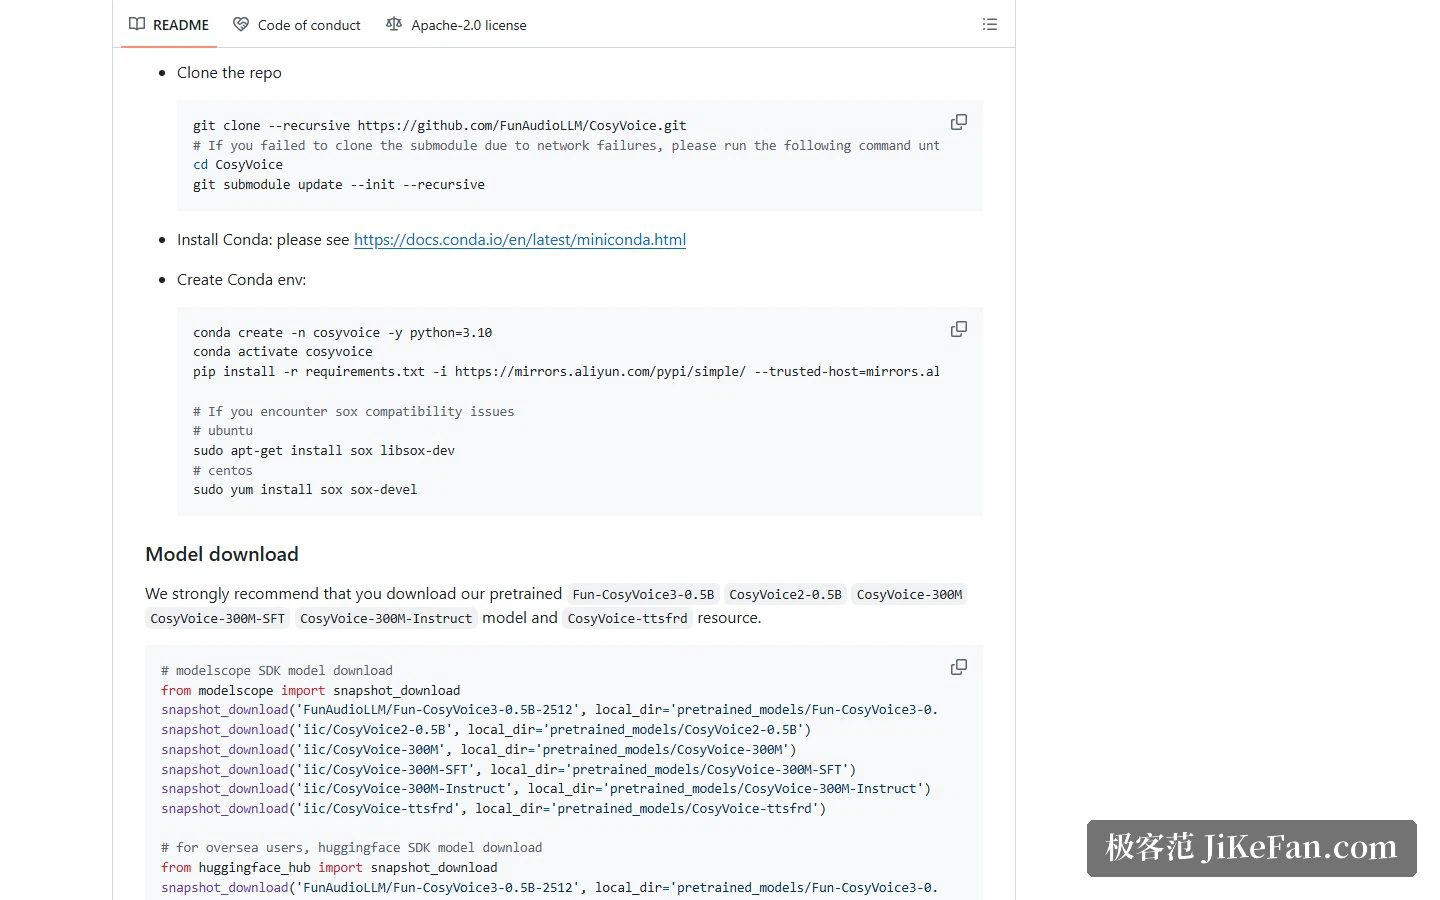
Le chemin officiel consiste à cloner le dépôt avec ses sous-modules, à construire un environnement Python 3.10 avec Conda, à installer les dépendances, puis à récupérer le modèle pré-entraîné voulu. Les points de contrôle viennent de ModelScope ou de HuggingFace, et les utilisateurs en Chine trouveront le premier plus fluide.
Un détail mérite l'attention. La normalisation du texte passe par wetext par défaut ; si vous décompressez et installez en plus le paquet de ressources ttsfrd, les nombres et les symboles se lisent mieux. La documentation précise que cette étape est facultative et peut être sautée.
Le faire tourner, et quand il faut plus de vitesse
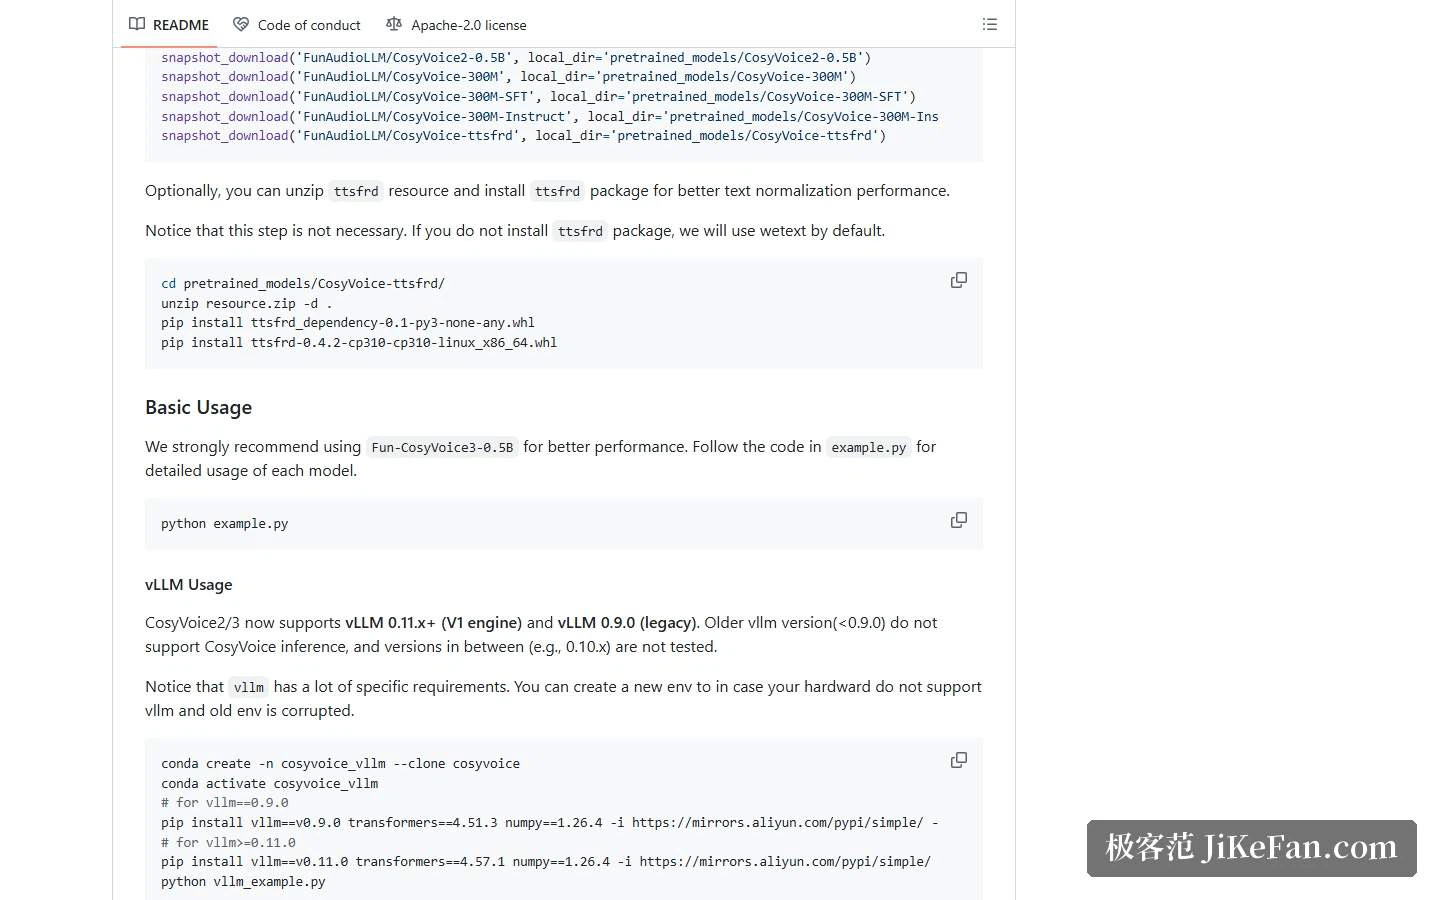
Le contrôle le plus rapide consiste à lancer les scripts d'exemple officiels, ou à démarrer la démo web en indiquant un répertoire de modèle et un port, puis à écouter dans le navigateur. Si le débit ou la latence devient la contrainte, CosyVoice 2 et 3 prennent en charge l'accélération par vLLM, avec une réserve de version : la documentation couvre le moteur récent à partir de 0.11 et l'ancien 0.9.0, les versions sous 0.9.0 ne peuvent pas inférer du tout, et celles entre les deux n'ont pas été validées.
Pour qui cela vaut
Si le besoin est en chinois — surtout des dialectes, un ton maîtrisable et des corrections de prononciation —, cette combinaison tombe mieux qu'une synthèse générale orientée anglais. Ajoutez le code ouvert et l'exécution locale, et l'ensemble convient aussi à qui ne peut pas laisser sortir ses données du réseau interne.
Deux points restent à vérifier d'abord. Le premier est la licence des poids du modèle : le code du dépôt est en Apache 2.0, mais avant d'exploiter l'audio généré commercialement, relisez les conditions d'autorisation attachées aux poids eux-mêmes. Le second est la légalité. Produire des contenus avec la voix d'autrui, et surtout celle d'une personnalité publique, peut toucher au droit de la personnalité et au droit sur la voix, et l'origine de ces droits mérite d'exister par écrit plutôt que par supposition.
Les modèles vocaux ouverts ont beaucoup avancé en deux ans, et la liste des langues et dialectes couverts continue de se remplir. Les choix techniques se sont multipliés ; ce qui reste est une question pour celui qui tient l'outil — de quelle voix la machine doit-elle se servir, et que doit-elle dire.