
Elicit mène la revue de littérature et rend des preuves citées jusqu'à la phrase
Résumé
Chercher dans 138 millions d'articles et 545 000 essais cliniques, puis laisser l'agent assembler un rapport, un tableau ou un support où chaque affirmation porte une citation qui remonte à sa phrase d'origine.
Recommander- Nom
- Elicit
- Version
- 1.38
- Tarif
- Gratuit
- Open source
- Propriétaire
- Système
- Web
- Site
- https://elicit.com/
- Mis à jour
- 2026-10-06 10:22
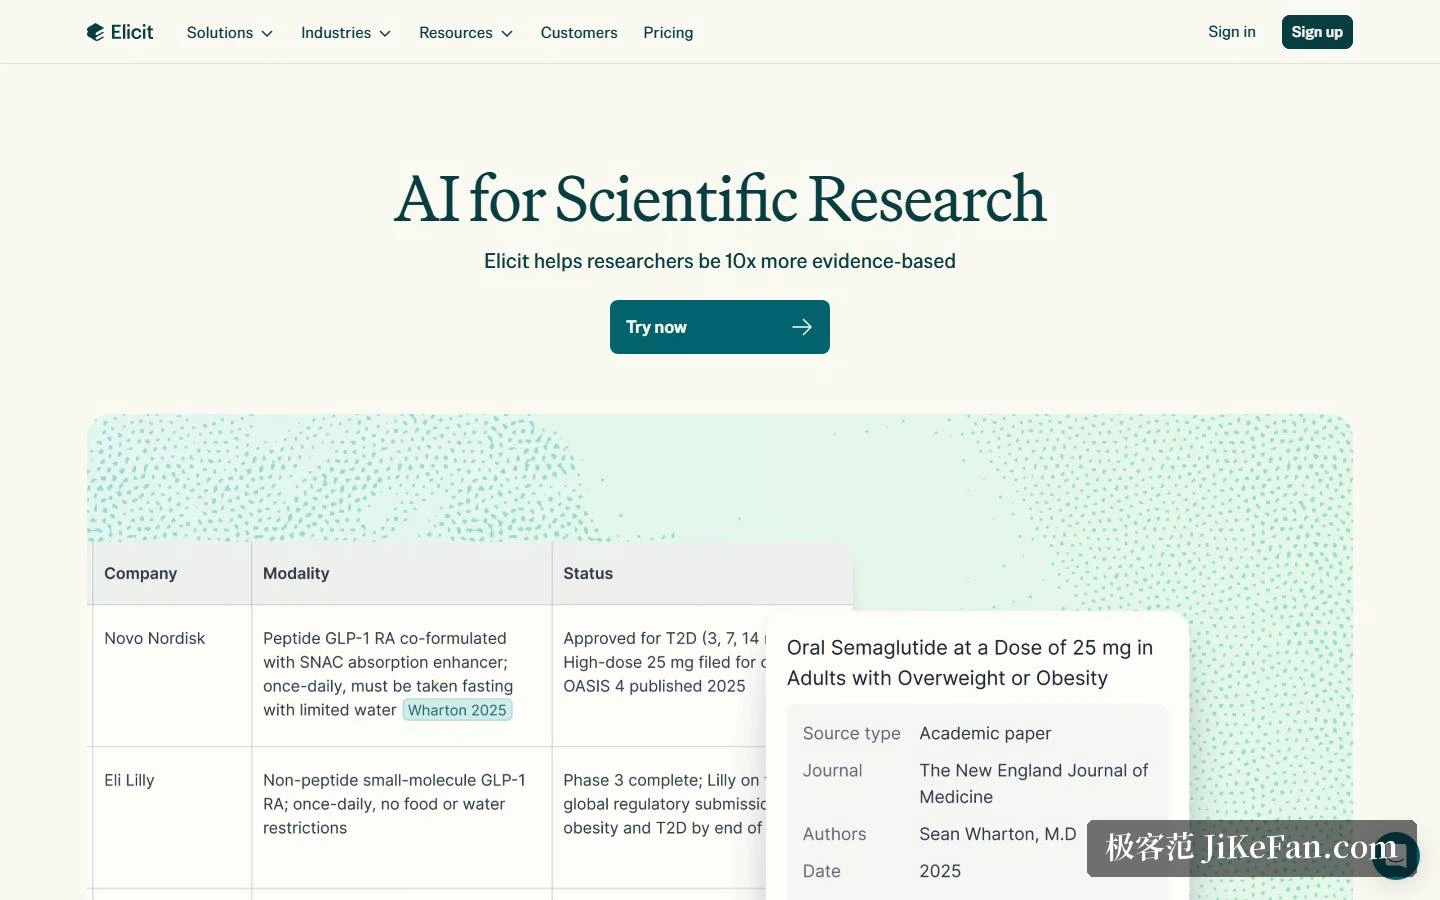
La page d'accueil ouvre sur une ligne en sérif : l'IA pour la recherche scientifique. Le sous-titre promet de rendre les chercheurs dix fois plus soucieux des preuves. Sous la navigation trône un exemple de tableau de recherche pharmaceutique — entreprise, type de molécule, statut d'autorisation — avec une citation d'article accrochée à chaque cellule. Le pied de page porte la mention de copyright, et la page revendique plus de 5 millions de chercheurs utilisateurs.
Un agent qui rassemble les preuves et fabrique le livrable
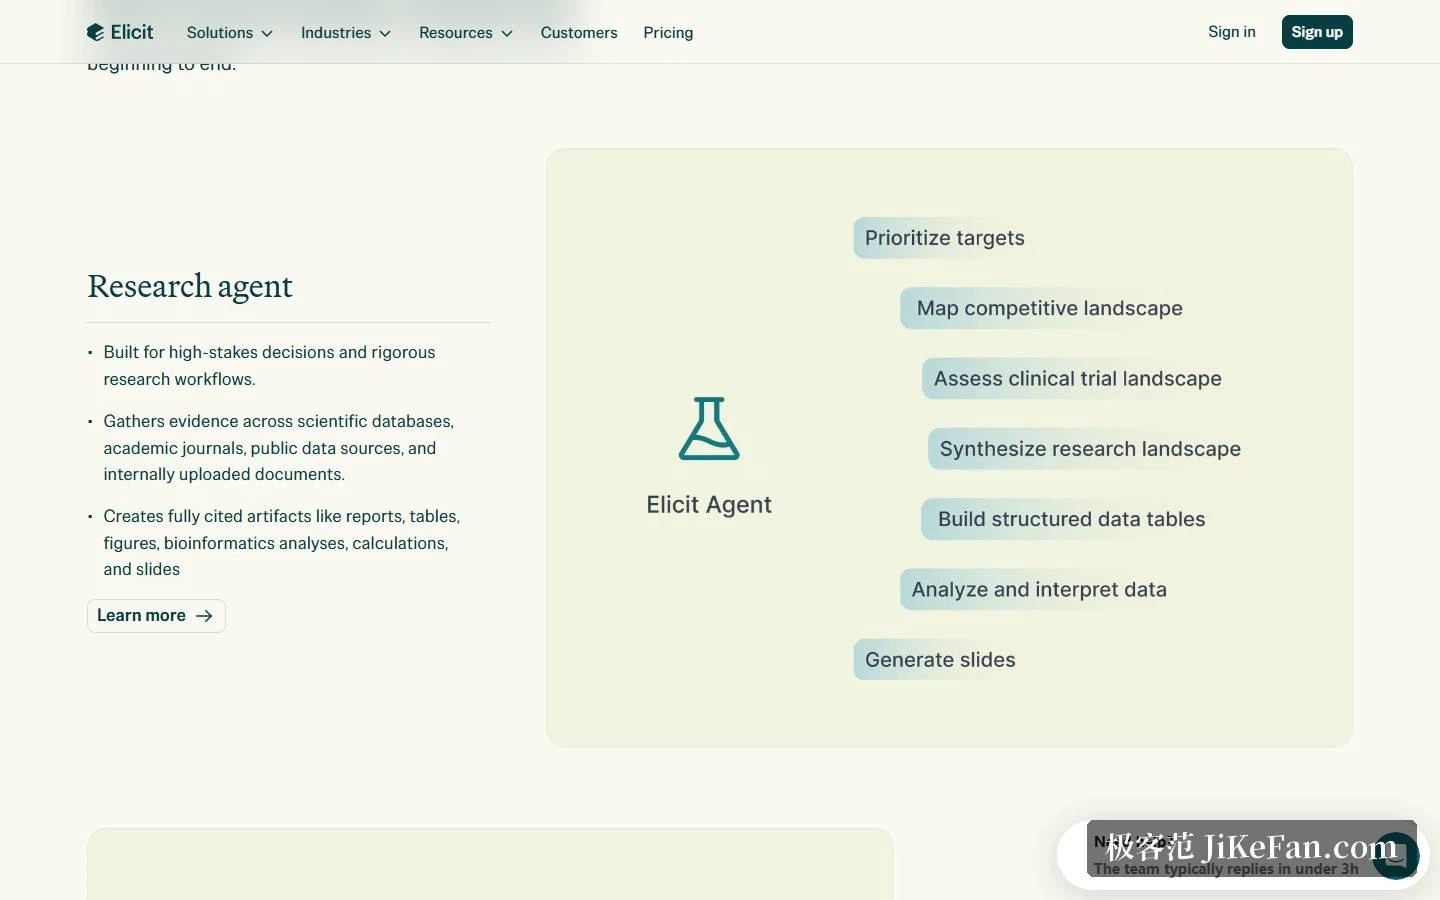
L'agent de recherche est destiné aux décisions à fort enjeu et aux flux de travail rigoureux. Il rassemble des preuves dans les bases scientifiques, les revues, les jeux de données publics et les documents que vous envoyez, puis construit des livrables cités de bout en bout : rapports, tableaux, figures, analyses bio-informatiques, calculs et supports de présentation. Dans l'exemple, les étiquettes de tâche vont de la priorisation des cibles au paysage concurrentiel puis aux essais cliniques, jusqu'à la génération des diapositives.
Ampleur, exactitude et la promesse de transparence
Les chiffres de recherche sont énoncés nettement : plus de 138 millions d'articles et 545 000 essais cliniques, interrogés sémantiquement pour n'avoir pas à deviner chaque mot-clé ; le blog de l'éditeur note avoir battu cinq autres systèmes de recherche sur une évaluation biomédicale de questions-réponses. Trois différences sont ensuite listées. L'ampleur : jusqu'à 1,000 articles pertinents et jusqu'à 20,000 points de données en une passe. L'exactitude : un processus validé derrière l'extraction. La transparence : chaque affirmation générée par l'IA porte une citation au niveau de la phrase, tirée de la source d'origine.
L'étape la plus lente d'une revue systématique
Le tri et l'extraction de données s'automatisent, et des chercheurs rapportent jusqu'à 80% de temps gagné. Sur 994 revues Cochrane, l'évaluation publiée annonce 95% de rappel à la recherche, 97% au tri des résumés, 99% au tri du texte intégral et 96% à l'extraction. Les cas sont plus précis : la revue d'un organisme de normalisation a extrait correctement 1,502 points de données sur 1,511, soit 99.4% d'exactitude avec onze fois plus de preuves, tandis qu'une société de biotechnologie a tiré des données de 1,600 articles dix fois plus vite. La bibliothèque et les alertes transforment une recherche ponctuelle en collection permanente et en veille.
Le prix suit l'usage
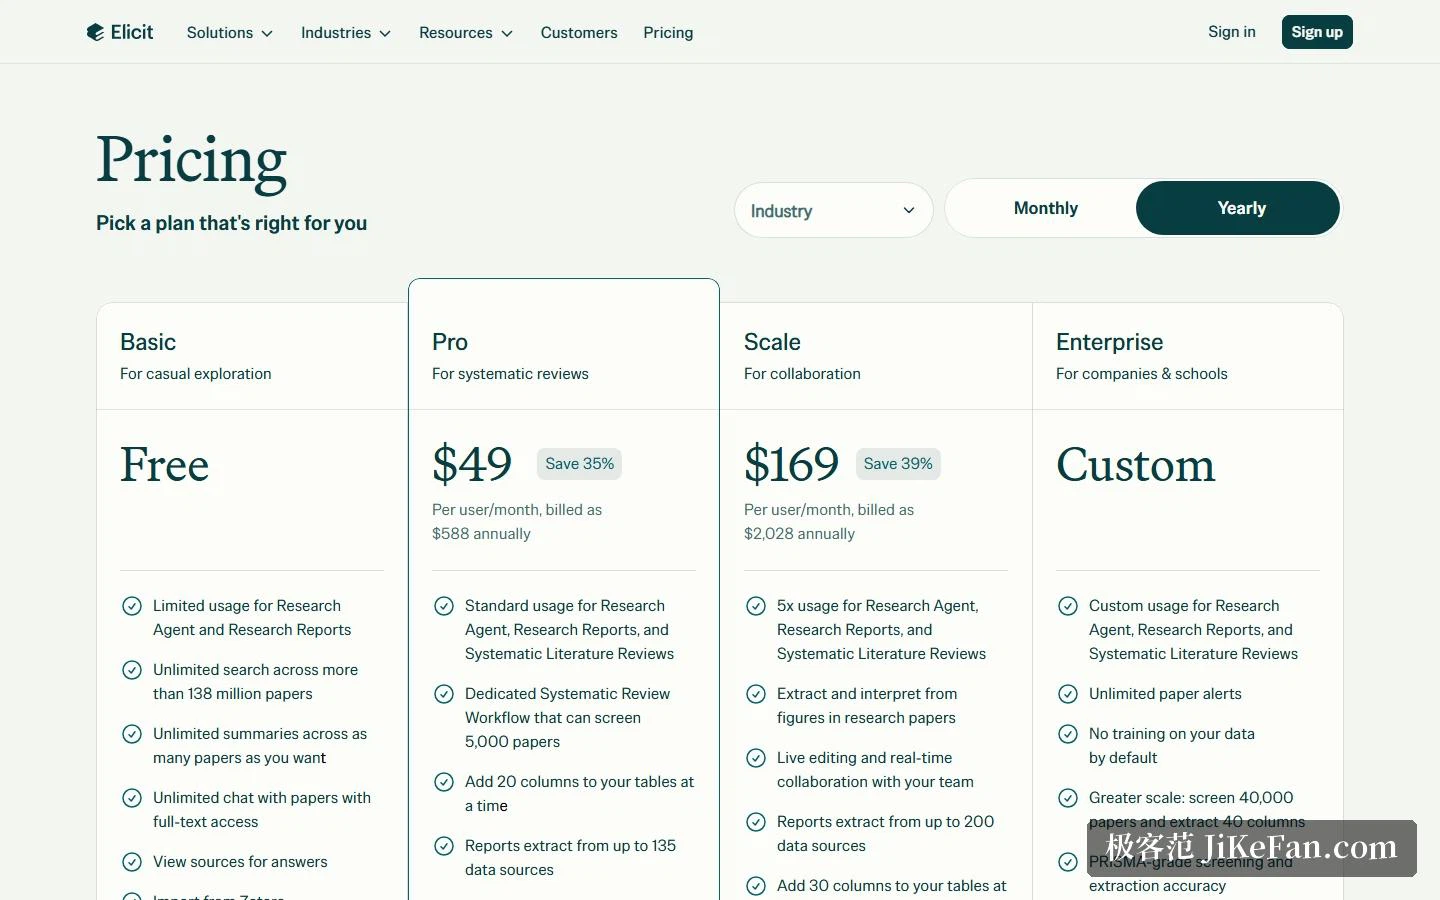
Quatre paliers. Basic est gratuit : usage limité de l'agent et des rapports, recherche illimitée sur tout le corpus, résumés illimités, conversation illimitée avec les articles en texte intégral, consultation des sources et import depuis un gestionnaire bibliographique. Pro coûte 49 par utilisateur et par mois, ou 588 en annuel pour 35% d'économie, et ajoute un flux de revue systématique triant 5,000 articles, des tableaux de 20 colonnes, 135 sources de données et l'accès à l'API. Scale est à 169 par mois avec collaboration en temps réel et 200 sources. Enterprise est sur devis, n'entraîne pas sur les données clients par défaut et prend en charge le SSO et SAML.
Pour qui c'est fait
Trois publics. Les chercheurs menant des revues de littérature et des revues systématiques, pour qui tri, extraction et la déclaration PRISMA 2020 ont une position officielle. Les chercheurs d'industrie devant transformer des preuves en rapports et en diapositives, avec des pages sectorielles pour le médicament, le dispositif médical, les politiques publiques et la grande consommation. Et les grands lecteurs voulant surveiller un domaine, la bibliothèque servant au réemploi et les alertes à l'abonnement.
Deux réserves honnêtes. D'abord, le site renvoie un 403 au simple moissonnage par script alors que la navigation normale fonctionne : les faits cités ici viennent des pages officielles et de la grille tarifaire. Ensuite, la plupart des chiffres de capacité sont des évaluations maison et des cas clients — dont les 99.4% d'exactitude d'extraction — donc citez-les avec leur source, puis vérifiez à petite échelle sur votre propre tâche.
Là où le gratuit ne suffit plus
Lus ensemble, les quatre paliers disent où le produit situe sa valeur. Recherche, résumés et conversation avec les articles en accès ouvert restent illimités même dans l'offre gratuite : le corpus est l'appât. Ce qui est compté, c'est la partie qui fabrique un livrable — l'agent, les rapports, le tri de milliers d'articles, les tableaux larges, les sources de données. Le gratuit suffit donc à explorer un champ et pas à terminer une revue, une frontière honnête pour qui se demande si l'outil mérite sa place.
Sur la finesse des citations, une chose mérite d'être dite : un lien au niveau de la phrase prouve que l'affirmation est traçable, pas que l'étude derrière était bonne. Juger le design, les biais et la pertinence reste le travail du relecteur — c'est précisément pourquoi la promesse de transparence porte sur la vérifiabilité et non sur l'exactitude.
Quand les citations descendent jusqu'à la phrase, une revue écrite par une IA ressemble enfin à quelque chose qu'on peut contrôler ligne par ligne.