
GPT-SoVITS affine un modèle vocal avec une minute d'audio, cinq secondes en zéro-shot
Résumé
Une interface Web de synthèse vocale open source. Cinq secondes d'une voix humaine suffisent en zéro-shot, une minute de données d'entraînement permet d'affiner un timbre plus proche, et l'inférence traverse cinq langues dont le mandarin, l'anglais, le japonais, le coréen et le cantonais.
Recommander- Nom
- GPT-SoVITS
- Version
- 20260917
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinuxmacOS
- Mis à jour
- 2026-10-06 18:49
Apprendre à une machine à parler d'une voix précise coûte de moins en moins cher. GPT-SoVITS ramène le prix à deux nombres : cinq secondes et une minute. Cinq secondes, c'est le plancher pour un échantillon de voix, assez pour synthétiser en mode zéro-shot. Une minute, c'est le plancher pour les données d'entraînement, assez pour qu'un affinage rapproche visiblement le timbre. Le projet est open source, et le titre du dépôt le dit sans détour : une minute d'audio suffit à entraîner un modèle de synthèse utilisable.
Deux entrées : sans entraînement, ou avec un peu d'entraînement
L'équipe découpe la capacité en deux chemins, et chacun répond à un besoin différent.
La synthèse zéro-shot est le chemin sans friction. On lui donne un échantillon de cinq secondes et le texte devient voix immédiatement. Cela convient à qui veut d'abord voir si le résultat tient, ou qui a besoin d'une voix de temps en temps. Pas de file d'entraînement, pas de jeu de données à assembler.
La synthèse few-shot est le chemin qui sonne le mieux. Une minute de données d'entraînement achète une similarité plus élevée et un débit plus naturel. La vraie portée de ce seuil tient à ce qu'il supprime : entraîner son propre modèle vocal cesse d'être un travail de spécialiste exigeant des heures de studio pour devenir une chose que l'on tente après avoir enregistré un paragraphe au téléphone.
Quelles langues il parle
La liste officielle mentionne l'anglais, le japonais, le coréen, le cantonais et le chinois. Le plus intéressant est l'inférence interlangue : la langue employée à la synthèse n'a pas à correspondre à celle du jeu d'entraînement. Un échantillon enregistré dans une langue peut, en principe, en faire parler une autre, sans jeu de données séparé par langue.
L'interface Web embarque la préparation des données
Quiconque a réellement cloné une voix sait que le difficile est rarement le modèle. C'est la préparation : que faire d'une musique de fond qui déborde dans l'enregistrement, comment découper un fichier long, et qui rédige les transcriptions ensuite. GPT-SoVITS place ces étapes dans l'interface : séparation de la voix et de l'accompagnement, découpage automatique du jeu d'entraînement, reconnaissance vocale multilingue avec étiquetage, et annotation du texte.
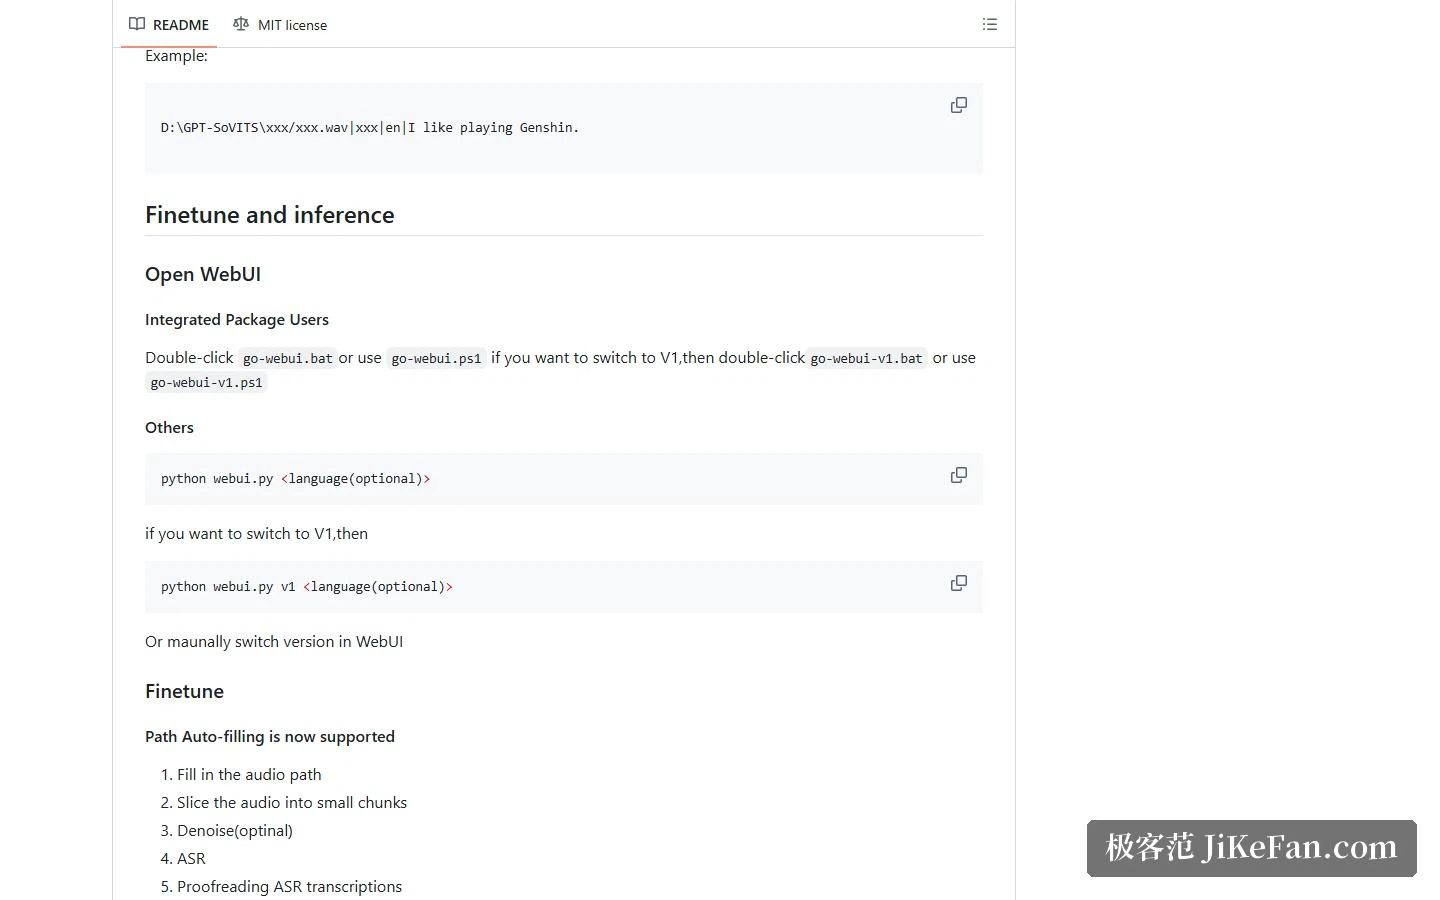
La séquence réelle est donc celle-ci : indiquer un chemin audio, découper, débruiter si besoin, lancer la reconnaissance vocale, corriger la transcription, puis passer à l'onglet d'affinage et entraîner. La reconnaissance regroupe plusieurs moteurs, dont Fun-ASR, SenseVoice et FunASR, pour qu'un débutant n'ait pas à assembler cette chaîne lui-même.
Beaucoup de versions, laquelle prendre
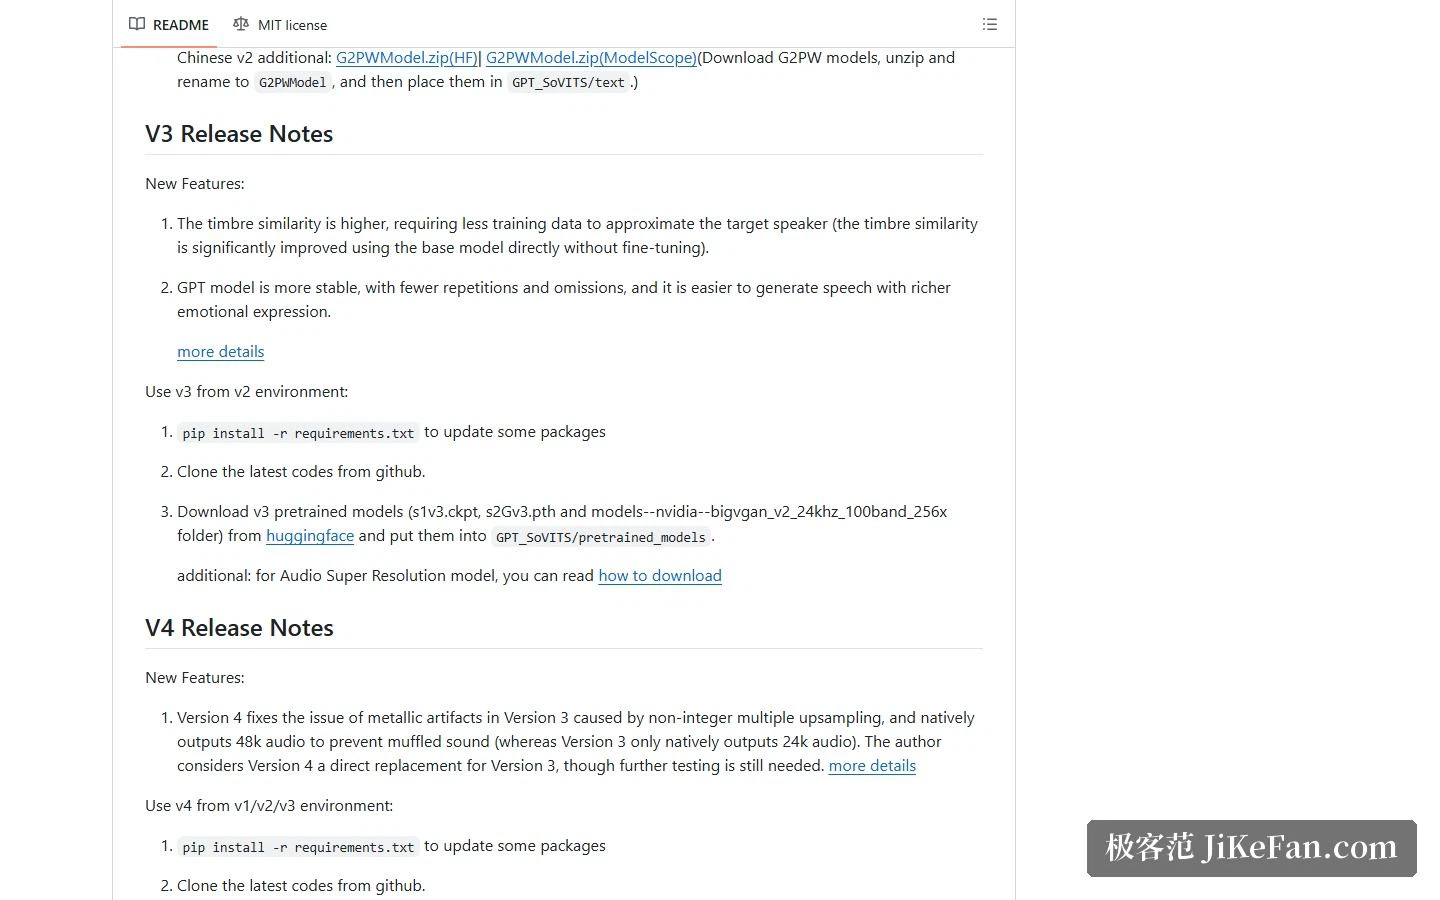
Le dépôt porte plusieurs versions — V1, V2, V2Pro, V3 et V4 — commutables par un paramètre au lancement, avec les scripts de démarrage correspondants dans le paquet Windows. Quelques différences comptent. V2 a porté le modèle pré-entraîné de 2000 à 5000 heures de données et ajouté le coréen et le cantonais. V3 a nettement relevé la similarité du timbre même sans affinage, et rendu le module GPT plus stable et plus riche en émotions. V4 a corrigé le bruit métallique que V3 produisait à cause d'un suréchantillonnage non entier, et sort nativement en 48kHz là où V3 travaille en 24kHz.
L'installation est-elle pénible
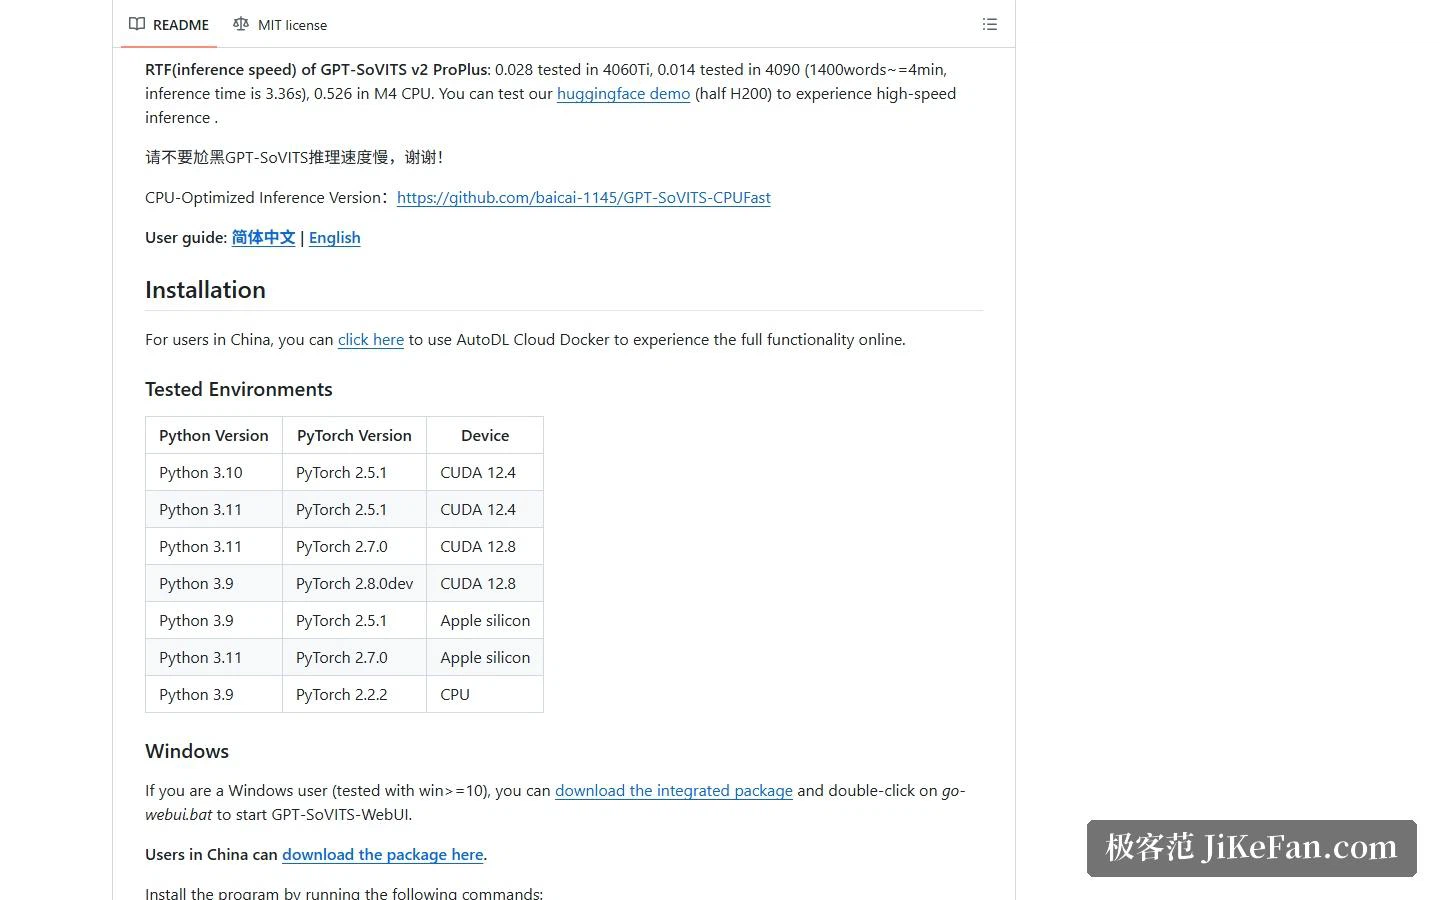
Plusieurs voies existent. La plus simple est le paquet Windows : télécharger, décompresser, double-cliquer le script de démarrage, et l'interface s'ouvre. Pour qui préfère gérer l'environnement en ligne de commande, il y a un script PowerShell sous Windows et des scripts shell sous Linux et macOS, tous deux capables de préciser le type de périphérique et la source de téléchargement des modèles. En dessous viennent l'installation manuelle, où il faut régler soi-même les dépendances et FFmpeg, et Docker, où les notes officielles préviennent que l'image légère est livrée sans les modèles de reconnaissance vocale et de séparation des voix, à télécharger séparément.
Côté environnement, les combinaisons testées couvrent Python 3.9 à 3.11 et PyTorch 2.2 à 2.7, avec des configurations de bureau sur carte graphique dédiée et des configurations légères sur processeur seul. Un point à connaître d'avance : sur certaines plateformes, les modèles entraînés sur GPU sortent nettement moins bons que sur d'autres matériels, et le projet y bascule donc provisoirement sur un entraînement processeur, sensiblement plus lent.
Pour qui cela vaut
Si l'objectif est un modèle vocal pour soi ou pour un timbre précis, avec les données qui restent sur sa propre machine, le positionnement tombe juste : peu de données nécessaires, chaîne d'outils complète, et une licence MIT qui laisse peu de restrictions.
Il faut en revanche une carte graphique utilisable, ou accepter la lenteur de l'inférence sur processeur. Sur certaines plateformes, l'étape d'entraînement s'allonge visiblement, et cela mérite d'être intégré au calcul. Séparément, la vraie limite du clonage vocal n'est pas technique mais juridique : utiliser la voix d'autrui, et surtout celle d'une personnalité publique, peut toucher au droit de la personnalité et au droit sur la voix. Mieux vaut établir l'origine des droits avant de toucher à l'outil.
Entraîner un modèle de synthèse avec une minute de données aurait paru impossible il y a quelques années. Plus l'outil est puissant, plus c'est à l'utilisateur de tenir la ligne — pouvoir et avoir le droit restent deux questions distinctes.