
Cherry Studio : plusieurs modèles dans une fenêtre, une base de connaissances à côté
Résumé
Cherry Studio est un client de bureau multiplateforme pour dialoguer avec des modèles : poser la même question à plusieurs et comparer, garder ses propres documents dans une base locale, générer images et traductions.
Recommander- Nom
- Cherry Studio
- Version
- 20250525
- Tarif
- Gratuit
- Open source
- Open source
- Mis à jour
- 2026-10-06 18:47
Poser deux fois la même question est une méthode, pas un gadget
Cherry Studio est un client de bureau multiplateforme pour dialoguer avec des modèles, doublé d'une base de connaissances, et il tourne sous Windows, macOS et Linux. Son idée organisatrice est si simple qu'on la manque : une question peut être envoyée à plusieurs modèles à la fois, et les réponses reviennent côte à côte. Lu comme une liste de fonctionnalités, cela ressemble à une nouveauté. Lu comme une méthode, c'est le contrôle qualité le moins cher dont dispose quiconque utilise ces modèles pour un vrai travail — non parce qu'un modèle serait meilleur, mais parce que leur désaccord est une information.
Ce désaccord a une forme qu'il vaut la peine d'apprendre à lire. Quand plusieurs modèles convergent vers la même réponse, c'est une preuve faible, mais c'en est une. Quand ils divergent, la divergence désigne en général la partie ambiguë de la question, et l'ambiguïté se loge plutôt dans la formulation de celui qui demande que dans les modèles. Bien utiliser la fonction, c'est lire les différences au lieu de compter les voix ; quatre réponses sans moyen de les comparer ne font que multiplier le bruit.
Le vrai travail se passe dans la base de connaissances
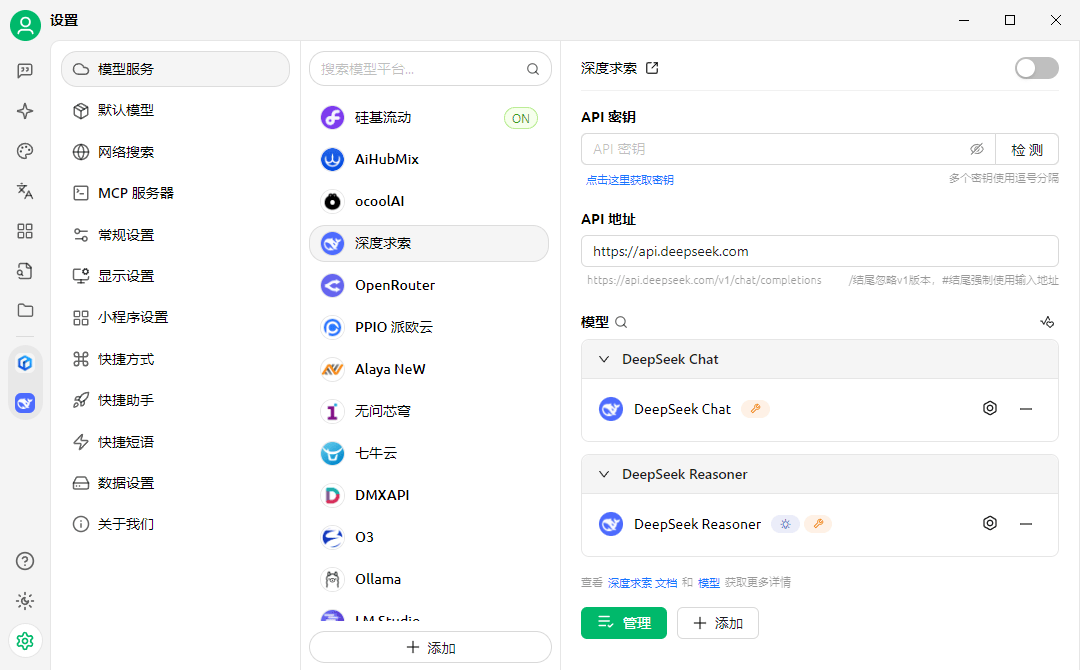
L'autre moitié du programme est une base de connaissances : importer des documents, les faire découper en passages et indexer, puis poser des questions dont les réponses doivent sortir de ce corpus. Les entrées acceptées comprennent le PDF, le texte brut, les fichiers de présentation et de traitement de texte, ainsi que des pages capturées sur le web. La partie intéressante n'est pas l'import, c'est la découpe. La façon dont un texte long est divisé détermine ce qui sera retrouvable, et une découpe au mauvais endroit produit un système qui répond à partir d'un demi-paragraphe avec une assurance complète.
La recherche sémantique est l'autre moitié de cela. La recherche par mots-clés échoue quand la question et le passage ne partagent aucun vocabulaire — le cas classique où l'on demande quels comptes expirent alors que le texte parle de sessions qui se terminent. La recherche sémantique réduit cet écart et apporte sa propre panne : des passages proches par le sens mais hors du sujet, renvoyés avec beaucoup d'aplomb. La réponse pratique est de lire les sources plutôt que la réponse, ce qui explique pourquoi un client qui montre les passages utilisés fait ce qu'il faut.
Le stockage local, et ce que la promesse couvre vraiment
Garder les données sur la machine est l'argument avancé, et il mérite d'être examiné, car le mot recouvre plusieurs dispositions. L'historique des conversations et les documents importés dans un stockage local : voilà la première. Un modèle qui tourne sur la même machine : la deuxième, et c'est celle où rien ne sort. Un modèle distant atteint depuis un client local : la troisième, et là le texte de votre question voyage bel et bien. Les trois sont légitimes ; les confondre ne l'est pas. Se servir honnêtement d'un tel outil, c'est savoir laquelle des trois est en jeu dans la conversation qu'on a devant soi.
Images et traduction, comme commodités attachées
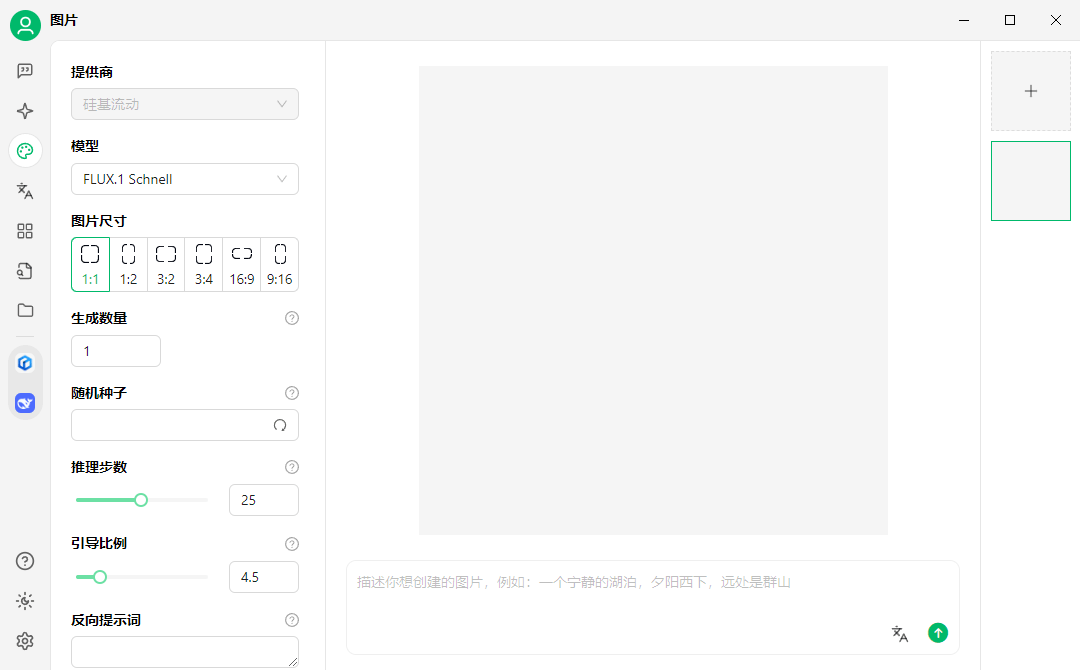
Générer une image à partir d'une description et traduire entre langues sont tous deux présents, et tous deux se comprennent mieux comme des commodités attachées à l'espace de travail principal que comme des raisons de le choisir. Leur qualité est celle du service qui se trouve derrière, ce qui est justement l'argument pour les réunir dans la même fenêtre : l'alternative, c'est un second programme, un second compte et un second jeu d'habitudes pour une chose utilisée quelques fois par semaine.
Quand la réponse doit être actuelle
L'entraînement d'un modèle a une date de fin, et les questions sur des prix, des sorties ou des événements postérieurs sont volontiers traitées à partir de l'imagination du modèle. Les versions récentes du programme ajoutent une recherche web, passée par des services tiers, qui place des pages actuelles devant le modèle avant qu'il réponde. C'est réellement utile pour la recherche et le travail de marché, et cela change le mode de défaillance plutôt que de le supprimer : la réponse vaut désormais ce que valent les pages récupérées, et une page fausse produit une réponse fausse, affirmative, avec une citation en pièce jointe.
Pour qui c'est
Quatre publics, quatre usages différents de la même fenêtre. Qui construit avec ces modèles veut comparer les sorties et garder les consignes qui ont marché. Qui fait de la recherche veut un dossier d'articles qu'on puisse interroger au lieu de le parcourir. Qui conçoit ou écrit veut les images et les textes générés à côté du matériel de référence plutôt que dans une autre application. Une équipe veut une bibliothèque interne avec une seule interface devant. Ce que les quatre ont en commun, c'est que la valeur vient de l'accumulation — les conversations archivées, les documents indexés — et non d'un échange isolé.
Les coûts qui ne figurent pas sur la boîte
Trois méritent d'être nommés. L'accès aux modèles est généralement facturé par celui qui les fournit : un client qui rend facile l'essai de quatre modèles rend donc facile une dépense quadruple. Une base de connaissances ne vaut que ce que vaut son entretien : les imports vieillissent, et une réponse bâtie sur un passage périmé est pire que pas de réponse, parce qu'elle arrive avec une source et un air de chose réglée. Et la commodité d'une fenêtre unique est une forme douce d'attachement, puisque conversations et documents indexés s'accumulent dans un programme précis — à retenir au moment où c'est précisément ce programme qui change.
Le mobile : annoncé, pas livré
Les trois plateformes de bureau sont couvertes ; une version mobile est annoncée comme direction et non comme fonction présente. Cela vaut d'être dit clairement, parce que cela définit ce qu'est l'outil : un espace de travail qui vit sur une machine et aura peut-être un compagnon, pas un service joignable de partout. Tout ce que le programme réussit dépend de cette accumulation locale, et c'est aussi ce qui le limite.
Où il se situe
Pris dans son ensemble, c'est un espace de travail plutôt qu'un outil : un lieu où plusieurs modèles, un corpus de documents et la production des deux sont gardés ensemble. Jugée ainsi, la question n'est pas de savoir si l'interface est agréable, mais si l'accumulation vaut plus que les changements de contexte qu'elle remplace. Pour qui pose à ces modèles plus que quelques questions par semaine et qui a du matériel à placer à côté, la réponse penche vers oui.