
Jimeng AI fasst Bild, Video und Leinwand in einem Eingang zusammen
Zusammenfassung
Bilderzeugung, Videoproduktion und eine Leinwand, die das Ergebnis bearbeitbar hält, teilen sich einen Eingang, Anfangs- und Endbild lassen sich festlegen, und der Ablauf ist um chinesische Prompts herum gebaut.
Empfehlen- Name
- Jimeng AI
- Version
- seedance-2
- Preis
- Kostenlos
- Open Source
- Proprietär
- Betriebssystem
- WindowsmacOSiOSAndroid
- Webseite
- https://jimeng.jianying.com/
- Aktualisiert
- 2026-10-06 21:41
Werkzeuge für Bilder und Werkzeuge für Filmmaterial sind meist zwei getrennte Anschaffungen, und wer das Ergebnis ändern will, öffnet eine dritte Anwendung. Jimeng AI geht einen anderen Weg. Die eigene Positionierung lautet Ein-Stopp-Plattform für kreatives Arbeiten: Bilderzeugung, generative Videoproduktion und eine Leinwand, auf der sich das Ergebnis weiter bearbeiten lässt, liegen hinter einem einzigen Eingang, dazu kommt eine Community-Galerie für Anregungen.
Bilder: nicht nur Text zu Bild
Die Erzeugung nimmt Text oder ein Bild als Ausgangspunkt, ein kurzer Prompt genügt. Nützlicher ist, was mit einem vorhandenen Bild geschieht. Man kann festlegen, dass das Aussehen einer Person oder eines Motivs erhalten bleibt, und das Modell dann den Hintergrund tauschen, einen Stil übertragen, die Bildsprache halten oder die Pose bewahren lassen. Bei Routinearbeiten wie einem neuen Hintergrund für eine Produktaufnahme oder einem neuen Look für ein Profilbild spart das, das Motiv jedes Mal neu beschreiben zu müssen.
Filmmaterial: beide Enden gehören dir
Auf der Videoseite dienen Text und Bild gleichermaßen als Eingabe: ein Skript oder ein Standbild hinein, ein Clip heraus. Zugesagt werden zusammenhängende Bewegung, natürlicher Fluss, steuerbare Kamerafahrt und veränderbares Tempo. Die Kontrollfunktion, die eine eigene Erwähnung verdient, sind die beiden Bildplätze: ein Anfangsbild und ein Endbild vorgeben, beide Enden festnageln und das Modell dazwischen füllen lassen. Das kommt der Einstellung im Kopf deutlich näher als ein einzelner beschreibender Satz. Der zweite Punkt betrifft die Sprache: Das System ist auf chinesische Prompts hin gebaut und versteht sie besser, was bei festen Wendungen, Eigennamen und dem Tonfall eines Textes hilft.
Die zweite Generation und ihre Referenzen
Das Video hinter dem Dienst stammt aus der Seedance-Reihe. Die Veröffentlichung des Entwicklungsteams hält fest, dass die zweite Generation live ist und gegenüber der vorigen bei komplexen Interaktionen und schnellen Bewegungen besser trägt, mit deutlich verbesserter physikalischer Genauigkeit, Realismusnähe und Steuerbarkeit — näher an dem, was industrielle Produktion verlangt.
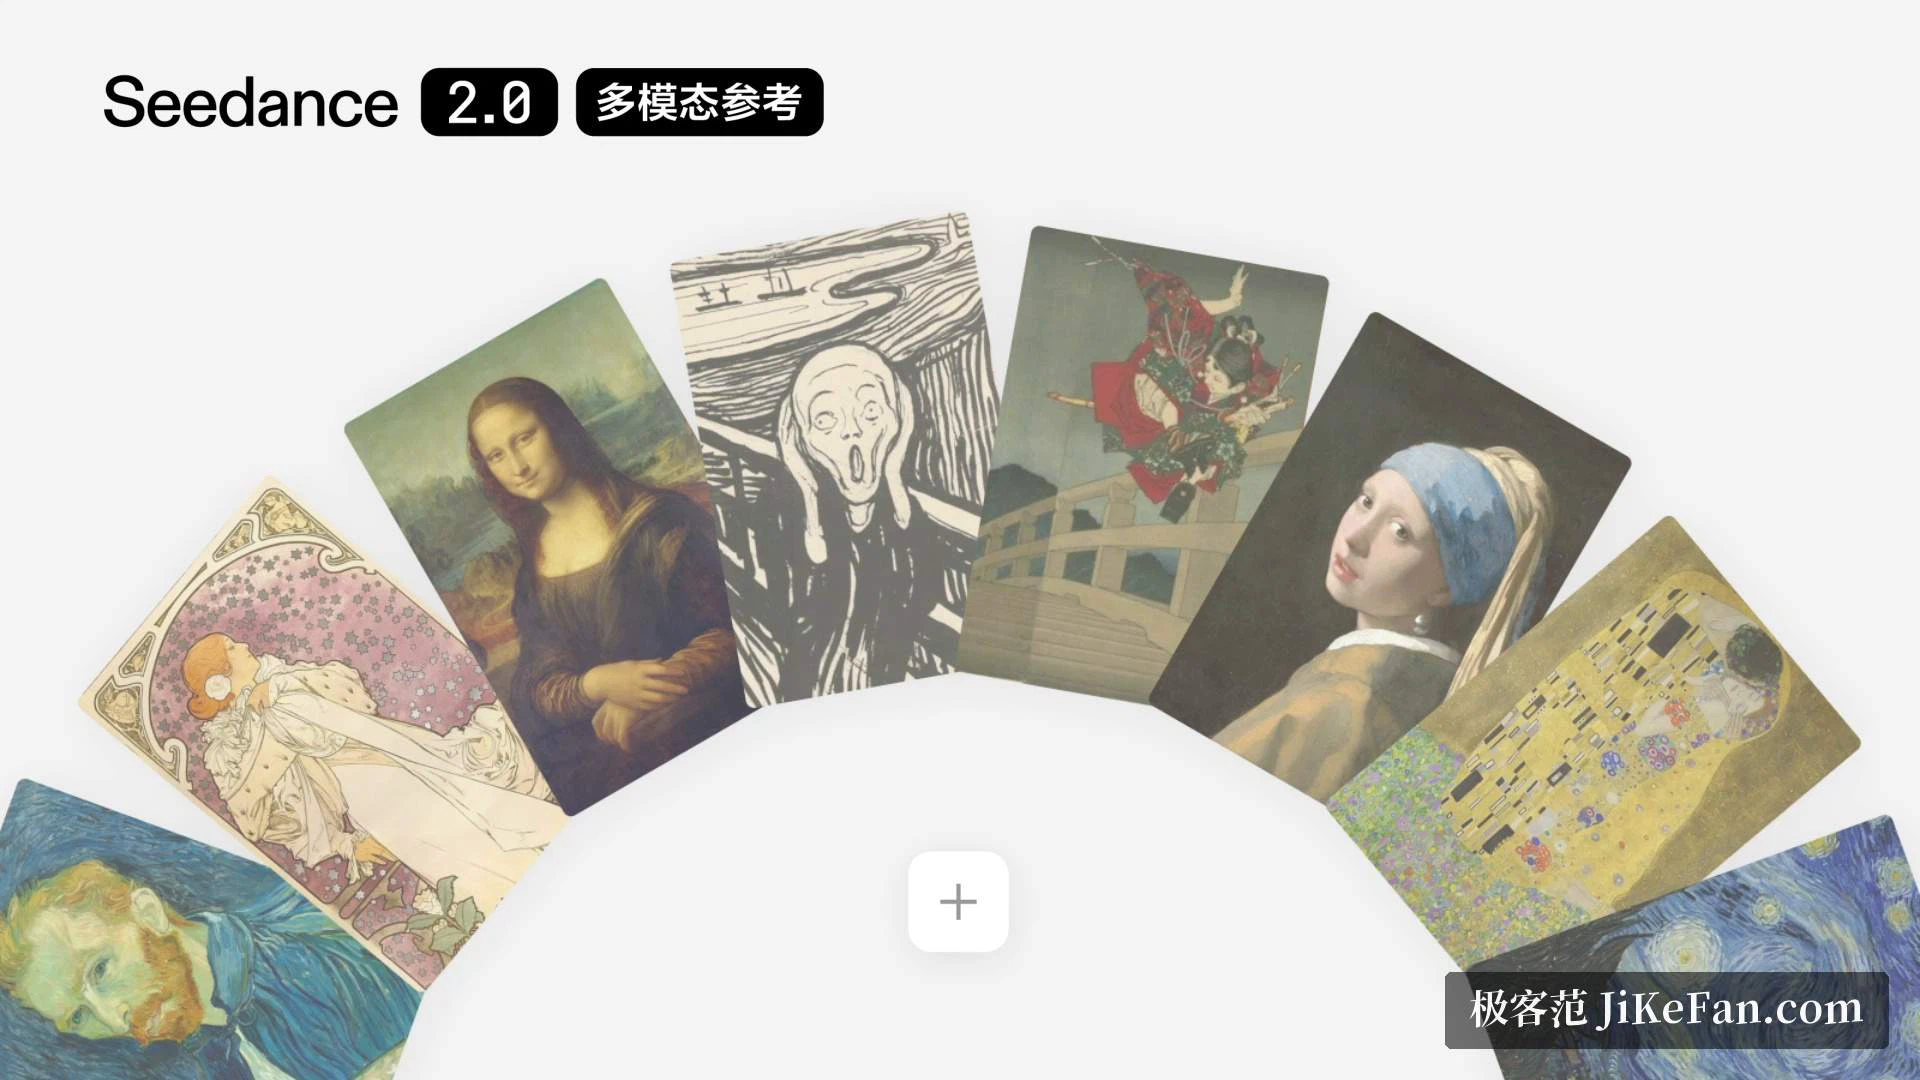
Der Kernpunkt sind multimodale Referenzen. Text, Bilder, Audio und Video lassen sich gleichzeitig liefern, bis zu neun Bilder, drei Videoclips und drei Tonspuren in einer Anfrage, und das Modell zieht Bildaufbau, Bewegung, Kameraführung, Effekte und Klang aus diesem Material. Ein Storyboard hineinzugeben und die Szene zu verlangen, wird damit zu einer ausführbaren Anweisung statt zu einem blossen Bild. Bei der Ausgabe sind fünfzehn Sekunden mehrteiliges Video mit Ton möglich, mit zwei Kanälen, sodass Musik, Atmosphäre und Erzählstimme in parallelen Spuren laufen und am Schnitt ausgerichtet bleiben.
Es lässt sich ändern und fortsetzen
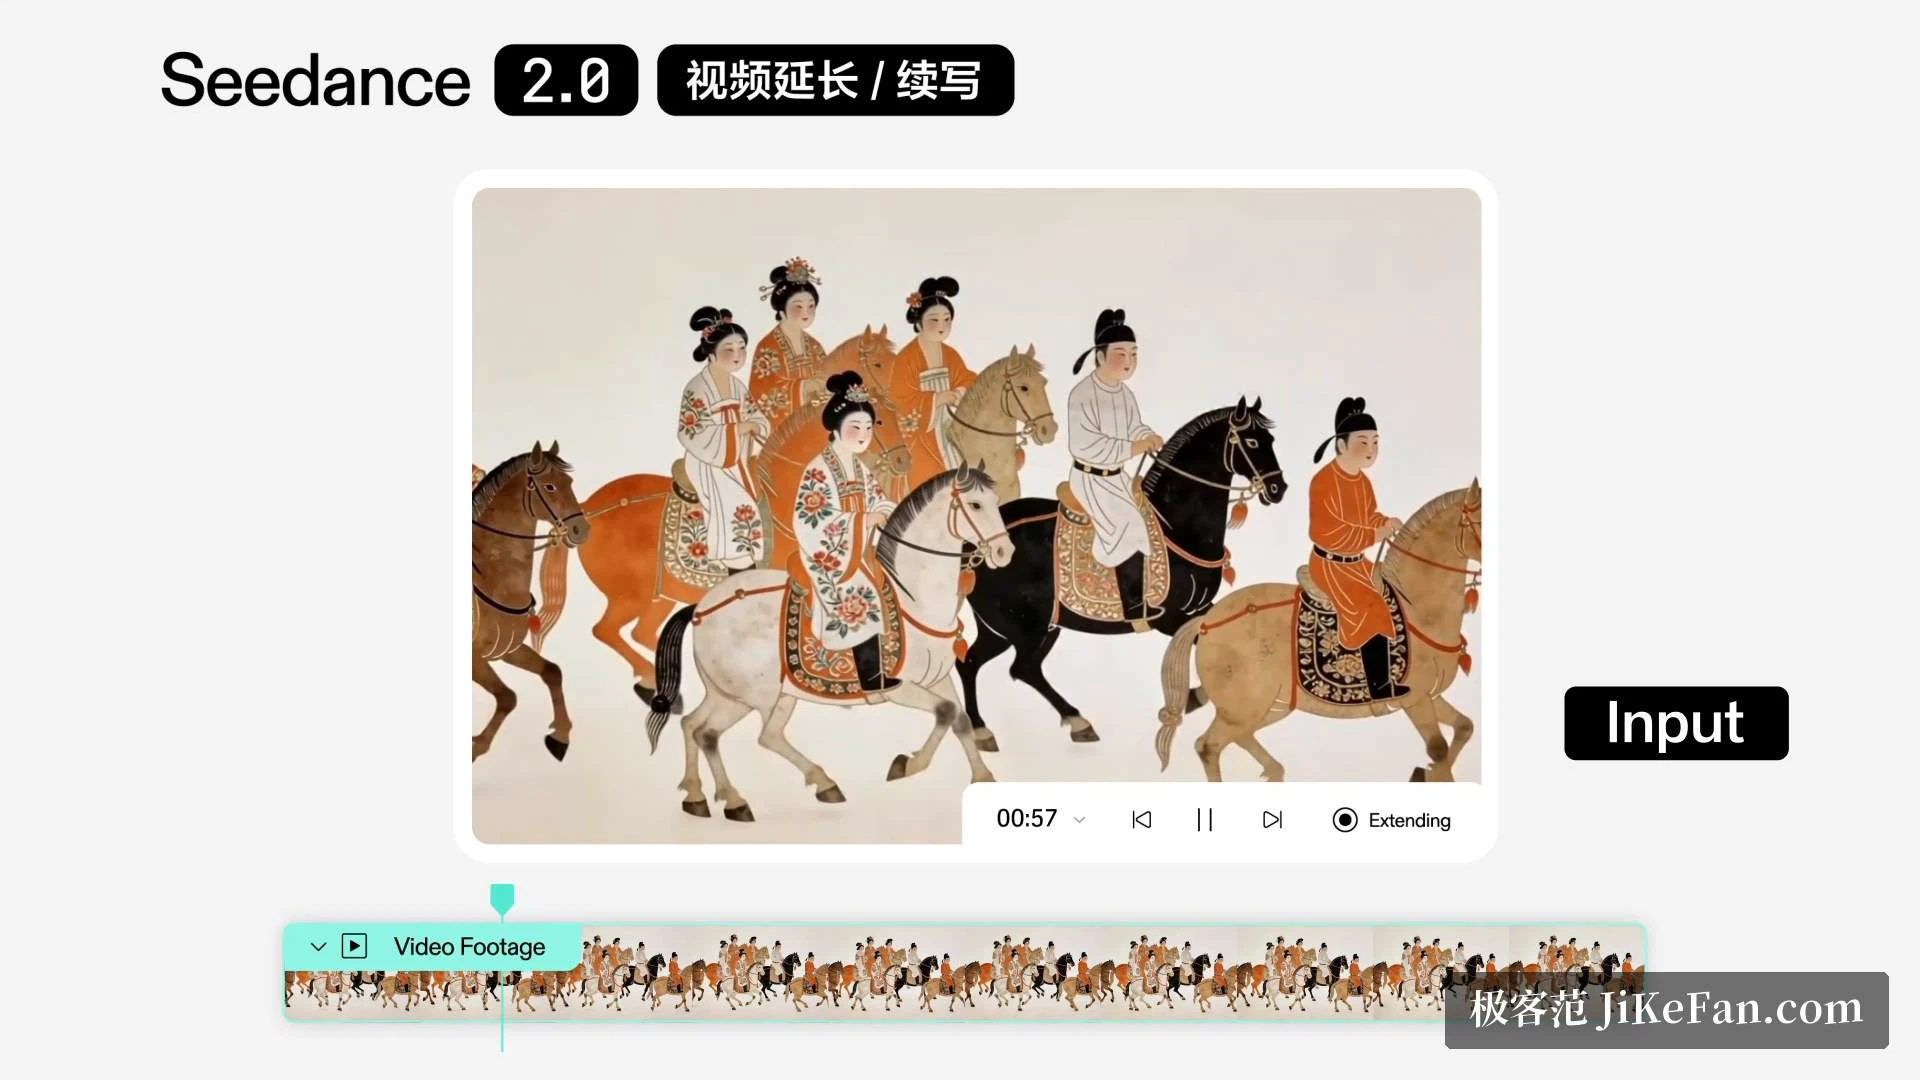
Die Erzeugung ist nur der erste Schritt. Die Veröffentlichung ergänzt eine Bearbeitung, die einen bestimmten Abschnitt, eine Figur, eine Bewegung oder einen Handlungspunkt gezielt überarbeitet, sowie eine Verlängerung, die aus einem Prompt fortlaufendes Material wachsen lässt — die Formulierung lautet, es erzeuge nicht nur, es drehe weiter. Zusammen mit den beiden Bildplätzen liegt der Grad der Kontrolle in dieser Werkzeugklasse ziemlich weit vorn.
Die Leinwand behält das Korrigieren an einem Ort
Die Leinwand ist das Modul, über das seltener gesprochen wird. Sie bringt einen Generator für Bildaufbau mit, dazu lokales Neuerzeugen, Erweitern mit einem Klick, Entfernen von Objekten und Freistellen. Mehrere Elemente lassen sich auf einer Fläche nahtlos zusammenfügen, sodass das Ergebnis eine einheitliche Bildsprache behält, und eine Bearbeitung mit mehreren Ebenen erlaubt feinere Kontrolle. Anders gesagt: Was nicht gefällt, lässt sich dort korrigieren, wo es entstanden ist, ohne Dateien zwischen einem Generator und einer Retuscheanwendung hin und her zu schieben.
Die Grenzen, offen benannt
Die eigene Bewertung des Teams weicht den Problemen nicht aus. Detailstabilität, Realismusnähe und Lebendigkeit der Bewegung brauchen weiter Arbeit, die Mundbewegung bei mehreren Personen ist noch nicht verlässlich, und der Ton verzerrt gelegentlich. Das sind Dinge, die man vor der Wahl wissen sollte, statt sie hinterher zu entdecken. Dazu kommt ein ausdrücklicher Hinweis zur Verwendung einer echten Person als Referenz: Die betreffende Person im Material muss entweder KI-erzeugt oder bereits lizenziert sein, und ein echtes Porträt verlangt die Bestätigung der Person selbst oder eine vorherige rechtliche Erlaubnis.
Zusammengefasst: Die Stärke liegt nicht in einer einzelnen Fähigkeit, sondern darin, dass Bilderzeugung, Videoproduktion, Korrektur und Modellwahl in einem Ablauf liegen, mit ausdrücklicher Unterstützung für Chinesisch als Arbeitssprache. Wer ein chinesischsprachiges Studio sucht, das sofort arbeitet, sollte es zuerst versuchen. Wer nur gelegentlich ein Bild braucht, wird das meiste davon als Überschuss empfinden.