
不連網也能認字:Umi-OCR 2.1.5 解壓即用
摘要
線上辨識的代價是把檔案傳給別人的伺服器。Umi-OCR 2.1.5 把引擎裝在本機,截圖、整批圖檔與掃描 PDF 都能辨識,結果可劃選可搜尋,過程中檔案不離開本機。
推薦- 軟體名稱
- Umi-OCR
- 版本
- 2.1.5
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinux
- 更新時間
- 2026-11-14 23:00
掃描件、截圖、別人傳來的圖片,裡面明明有字,卻只能一個字一個字敲進檔案——這種活幹過一次就記得。線上辨識能省事,代價是把檔案傳給別人的伺服器;斷網、涉密,或者只是嫌麻煩,這條路就走不通。Umi-OCR 換了個位置:辨識引擎裝在本機,不連網也能跑。它是一個用 Python 與 Qt 寫的開源專案,MIT 協議,發布包解壓即可使用,不必另裝執行環境。官方按系統分別出包,Windows 與 Linux 各有對應版本,介面語言也覆蓋了十多種。
免費、開源、可批次的離線 OCR 軟體——專案首頁把自己的定位寫得很克制,沒有形容詞,只列了三個屬性。
截圖之後,字就能劃選
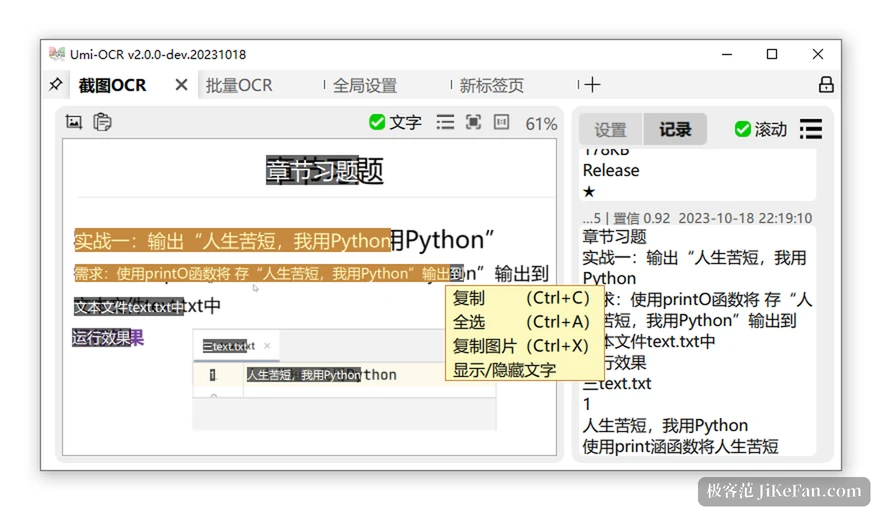
主介面是索引標籤結構,截圖辨識、批次辨識、全域設定各佔一頁,還可以再開新索引標籤。截圖頁左邊是剛抓下來的畫面,右邊一欄分設定與紀錄:辨識完成後,左邊的圖裡可以直接用滑鼠劃選文字,右邊紀錄區按時間倒序列出每次結果,每條都標著信賴度——0.92 這種數字算不上好看,但它誠實地告訴你這一行辨識得有多大把握,需要人工複核的地方一眼就能找到。
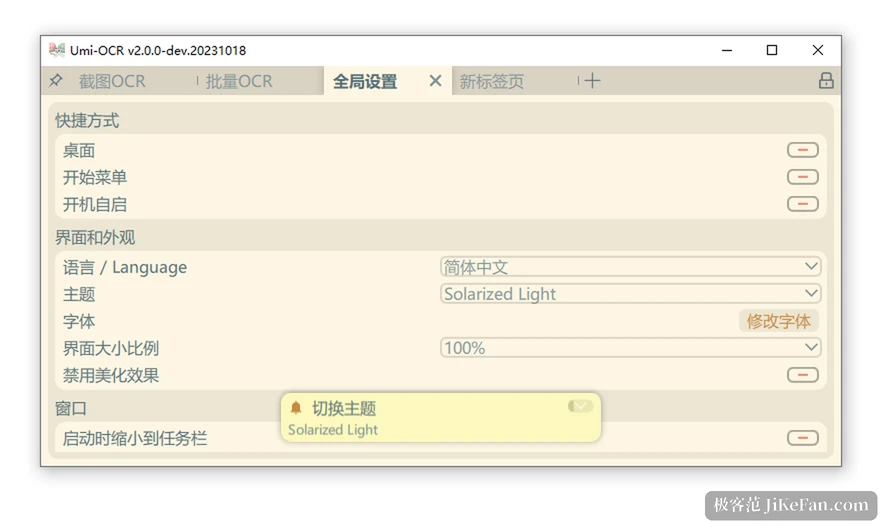
2.1.5 之後多數索引標籤能切成左右或上下雙欄,螢幕窄的時候把紀錄壓到下方,圖的顯示面積能多出一截;按 Esc 直接隱藏主視窗,是給頻繁截圖的人留的快捷鍵。
排版解析:把亂序的方塊排回人話
辨識的原罪不是認錯字,而是把兩欄的段落按辨識順序堆成一鍋粥。Umi-OCR 在文字後處理裡放了排版解析,可以按多欄、單欄、單行幾種方案重排結果,讓輸出的文字順序貼近原文的閱讀順序。單欄單行方案還處理了另一種常見情況:在兩個相隔較遠的文字區塊之間補一個空格,避免句子被黏在一起。
這類細節不出現在功能列表裡,但你複製一大段文字出來、發現不必再手動斷句的時候,能感覺到差別。
批次那一頁,是一個小型流水線
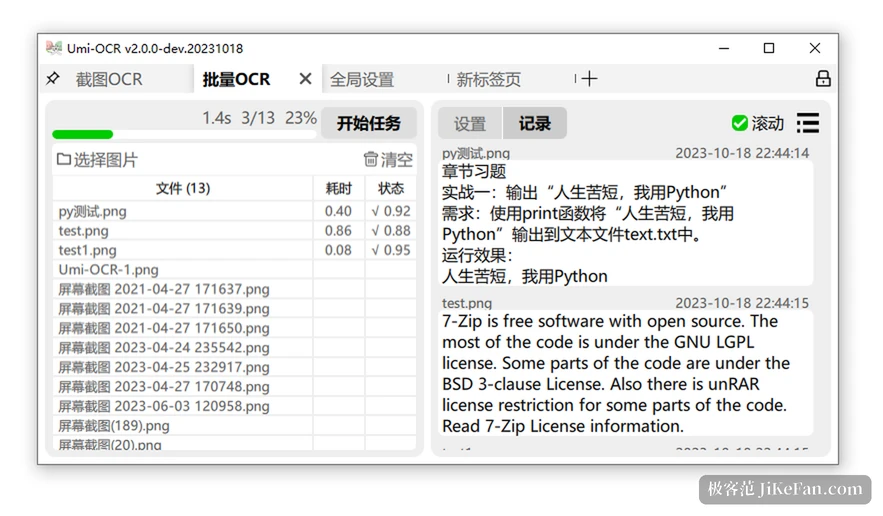
批次辨識頁左邊是檔案清單,每列給出檔名、耗時與狀態,狀態欄裡那個勾後面跟著的同樣是信賴度;頂部一條進度條,跑起來會顯示已完成張數與百分比。右邊紀錄區按檔案分組,點哪張圖就看哪張的結果,往下捲能看到同一批裡其他檔案辨識出來的內容。
真正省時間的不是並行,而是可以一邊跑一邊翻——辨識完的檔案先進清單,不必等整批結束。2.1.5 把圖片與檔案的載入改成非同步,幾萬個子檔案的資料夾也能流暢展開,進度條跟著走。同一個頁面還有忽略區域:框出一塊矩形,那塊裡的字就不參與辨識,截圖自帶的角標、浮水印、時間戳可以被整片跳掉。
掃描版 PDF 也能讀
檔案辨識處理的是 PDF:一類是掃描件,頁面裡根本沒有文字層,只能靠辨識補出來;另一類本身就帶文字層,可以直接擷取,省掉辨識的功夫。輸出有兩種去向:擷取成純文字,或者產生一份雙層可搜尋 PDF——原件樣子不動,底下壓一層看不見的文字,之後用閱讀器搜尋、複製都正常。
2.1.5 修了兩個與這相關的毛病:頁面旋轉時自帶文字被漏掉,以及產生單層 PDF 時原文字沒寫進去。對需要歸檔的合約、說明書這類檔案來說,這兩處比新功能重要。
能給別的程式呼叫,才是它真正的用法
介面之外,它留了兩個入口。命令列可以在啟動時帶指令,也能在執行時遠端下達任務;HTTP 介面則把它變成一個本機服務,截圖、圖片、PDF 都能透過請求提交,回傳結果裡帶每行的座標與信賴度。Linux 版本還能以容器方式跑起來,接在自己的流程裡。
2.1.5 補上的日誌機制就是為這條路準備的:帶命令列參數啟動可以看到即時日誌,指定等級以上的紀錄落到日誌目錄,排查一次辨識失敗不必再靠猜。2.1.5 還加了重新載入設定的指令,改完參數不必重啟整個程式。
兩個需要提前知道的邊界
辨識引擎是外掛形式,發布時按引擎分成兩個包:效能好的那個對處理器指令集有要求,奔騰、賽揚、凌動這類老處理器跑不起來,遇到初始化失敗要換成相容版。這不是缺陷,是推論框架本身的限制,專案說明裡寫得很直接。
另一條邊界是它只做辨識,不做版面還原——表格辨識出來是文字流,想要保結構得自己再排。介面語言覆蓋十多種,透過社群翻譯平台維護,中文與英文都在裡面。
它解決的問題很窄
把 Umi-OCR 2.1.5 放回使用場景裡看,它解決的問題很窄:把圖片和掃描件裡的字,變成可以複製、可以搜尋、可以餵給別的程式的文字,而且這個過程不出本機。截圖劃選、批次排隊、忽略區域、雙層 PDF、命令列與介面,這幾件事湊在一起,夠覆蓋從偶爾用一次到接進自動化流程的全部距離。免費開源、不要帳號、不連網,對需要處理敏感材料的場景來說,這三點本身就構成了選擇理由。