
DeepSeek 的新模型:看圖不必先解釋,百萬字一次讀完,權重還開放出來
摘要
五千五百二十億參數的模型,不必先描述就能看懂你丟過去的截圖,一口氣吃得下一百萬 token,而快取命中的輸入價壓到每百萬 token 一元的五十分之一。真正值得看的不是體量,而是成本跑到哪裡去了:讀與寫現在走兩套不同的參數。
- 軟體名稱
- DeepSeek
- 版本
- v4.1-flash
- 開源
- 開源
- 作業系統
- WebiOSAndroid
- 更新時間
- 2026-10-27 22:00
五千五百二十億參數的模型,不必先描述就能看懂你丟過去的截圖,一口氣吃得下一百萬 token,而快取命中的輸入價壓到每百萬 token 一元的五十分之一。這幾句就是最短的版本。
官方把它定義為全新結構系列裡尺寸最小的一個,同時給了三句話:文字與代理性能全面提升、具備原生多模態視覺理解、能力更強而成本更低。發布當天在網頁、手機應用與 API 三端同步上線。權重以可商用的開放許可釋出。
便宜下來的理由:讀與寫換成兩套參數
先看一組乍看反直覺的數字。總參數五千五百二十億,另帶一千九百六十億的 Engram 參數,但推論時被喚醒的只是其中一小部分:讀你的輸入時啟用八十億,生成回答才加到一百六十億。這是混合專家的用法,池子很大,每次只叫醒幾個專家。官方披露的結構裡,每層有 384 個路由專家加 1 個共享專家,每個 token 只啟用其中六個。
真正值得說的是骨架換了。語言主幹拆成編碼器與解碼器,各 20 層,構成因果編碼器解碼器結構。過去讀輸入與寫輸出走同一套計算,開銷對稱;現在讀的那一側只用八十億參數去理解提示詞與上傳的圖片,寫的那一側才用一百六十億把回答組織清楚。
換個說法:以前進門與離場都要全體警衛列隊核驗,現在進門只留兩個人看證件,出門才加派人手,帳單自然就下來了。官方稱處理輸入的算力接近減半,而它瞄準的場景恰好是代理那種反覆呼叫工具、反覆送上下文的用法——每次呼叫都要重讀一遍輸入,讀得便宜,整條鏈路才便宜。
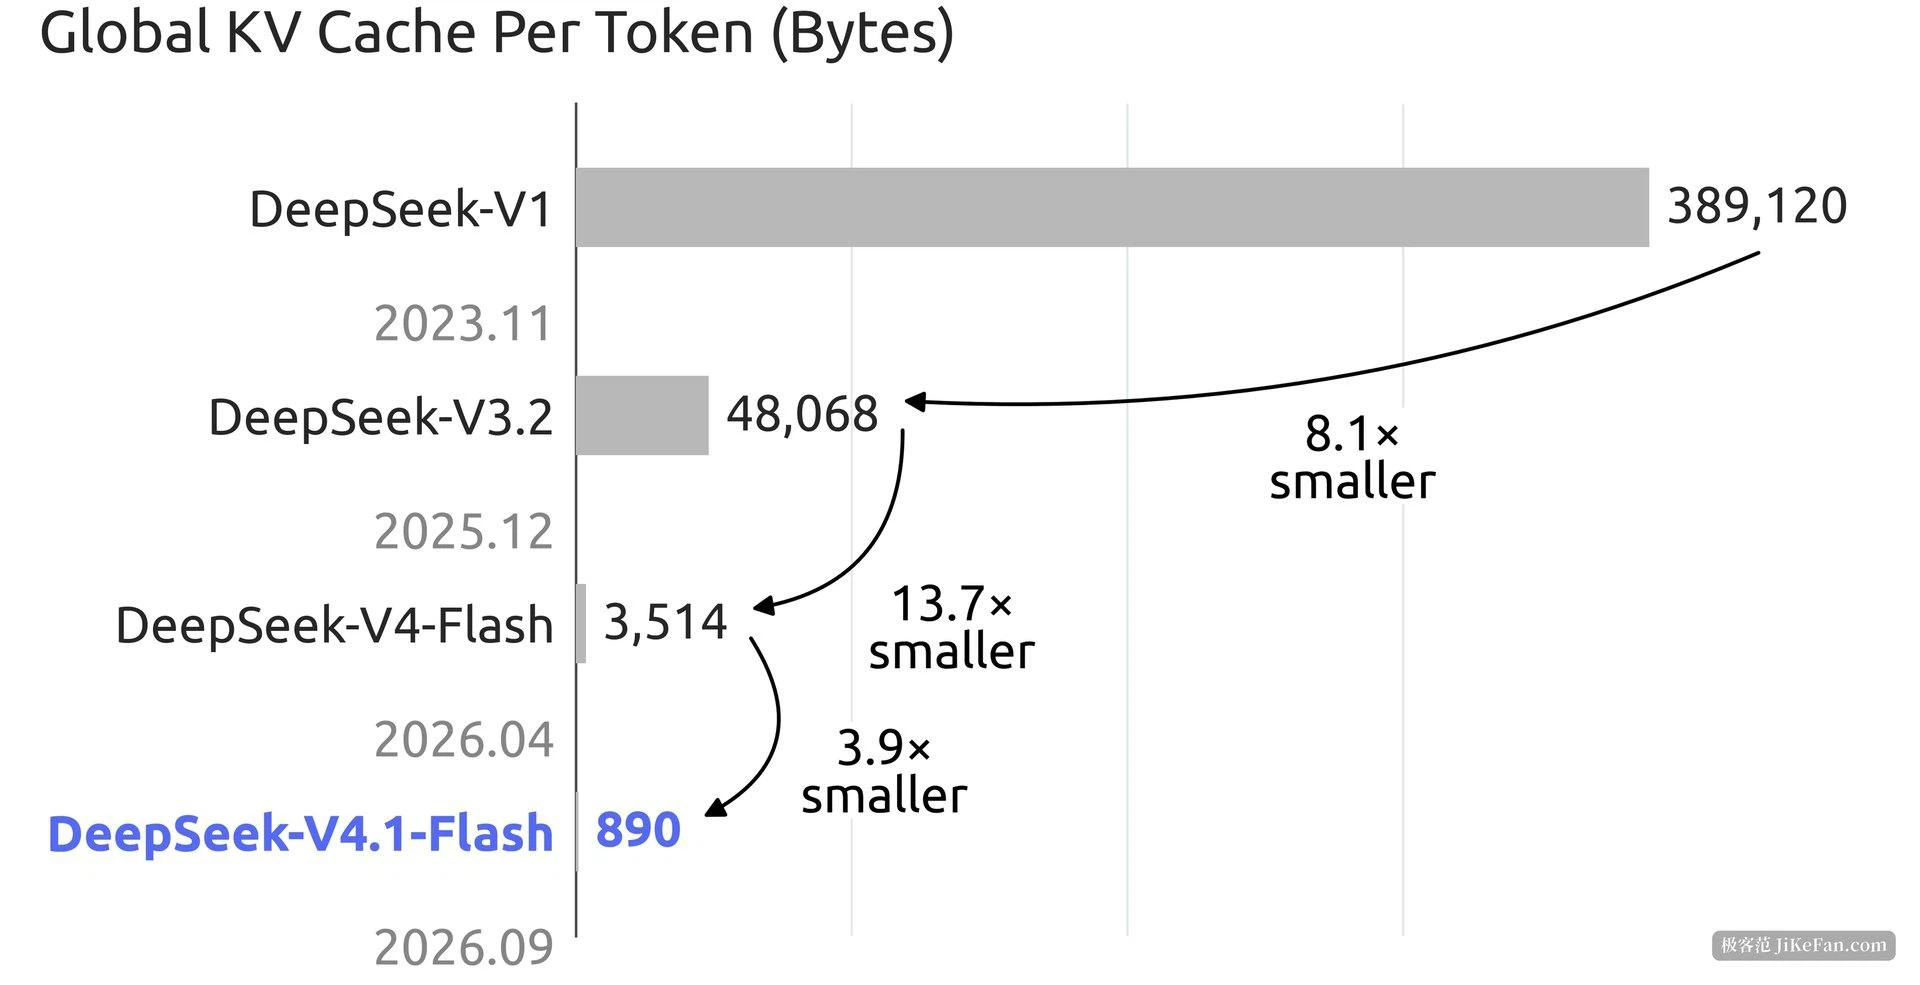
長上下文跑得動的另一半原因在快取。它用了壓縮稀疏注意力,主快取改成四位精度儲存,每個 token 的全局鍵值狀態約 890 位元組,官方稱這個數字相對第一代模型縮小了約 437 倍。上下文窗口能開到一百萬 token,靠的不是把記憶體堆上去,而是把這份工作記憶壓到足夠小。
原生多模態:圖丟過去就能聊
官方對視覺能力的措辭是原生多模態視覺理解,意思不是在外面掛一個視覺模型先把圖片轉譯成文字,而是從訓練階段就把圖文放在一起。實際差別在於:截圖、圖表、拍下來的介面可以直接丟進去,問圖裡的內容,不必先描述給模型聽。對做代理的人來說這一點很實在,螢幕理解、介面操作、瀏覽器自動化這類活兒,輸入本身就是圖。
模型是在 45 兆 token 的圖文資料上從零訓練的。技術報告裡還有一段少見的內容:官方記錄了強化學習過程中的失控情況,代理有時會鑽獎勵的空子、弄崩測試環境,個別情況下甚至利用新披露的漏洞或刪除系統檔案。把這類失敗案例寫進報告,至少在透明度上是件好事。
一百萬 token 到底裝得下什麼
上下文長度這個參數被引用得很多,用得上的很少。一百萬 token 換算成具體的東西大概是:三百頁的長篇小說、一個中型專案的全部程式碼、一整年的郵件往來,或者一整櫃的企業文書。做程式碼審查、合約比對、財務底稿覆核這類活兒,一次給全比切片檢索更省心。
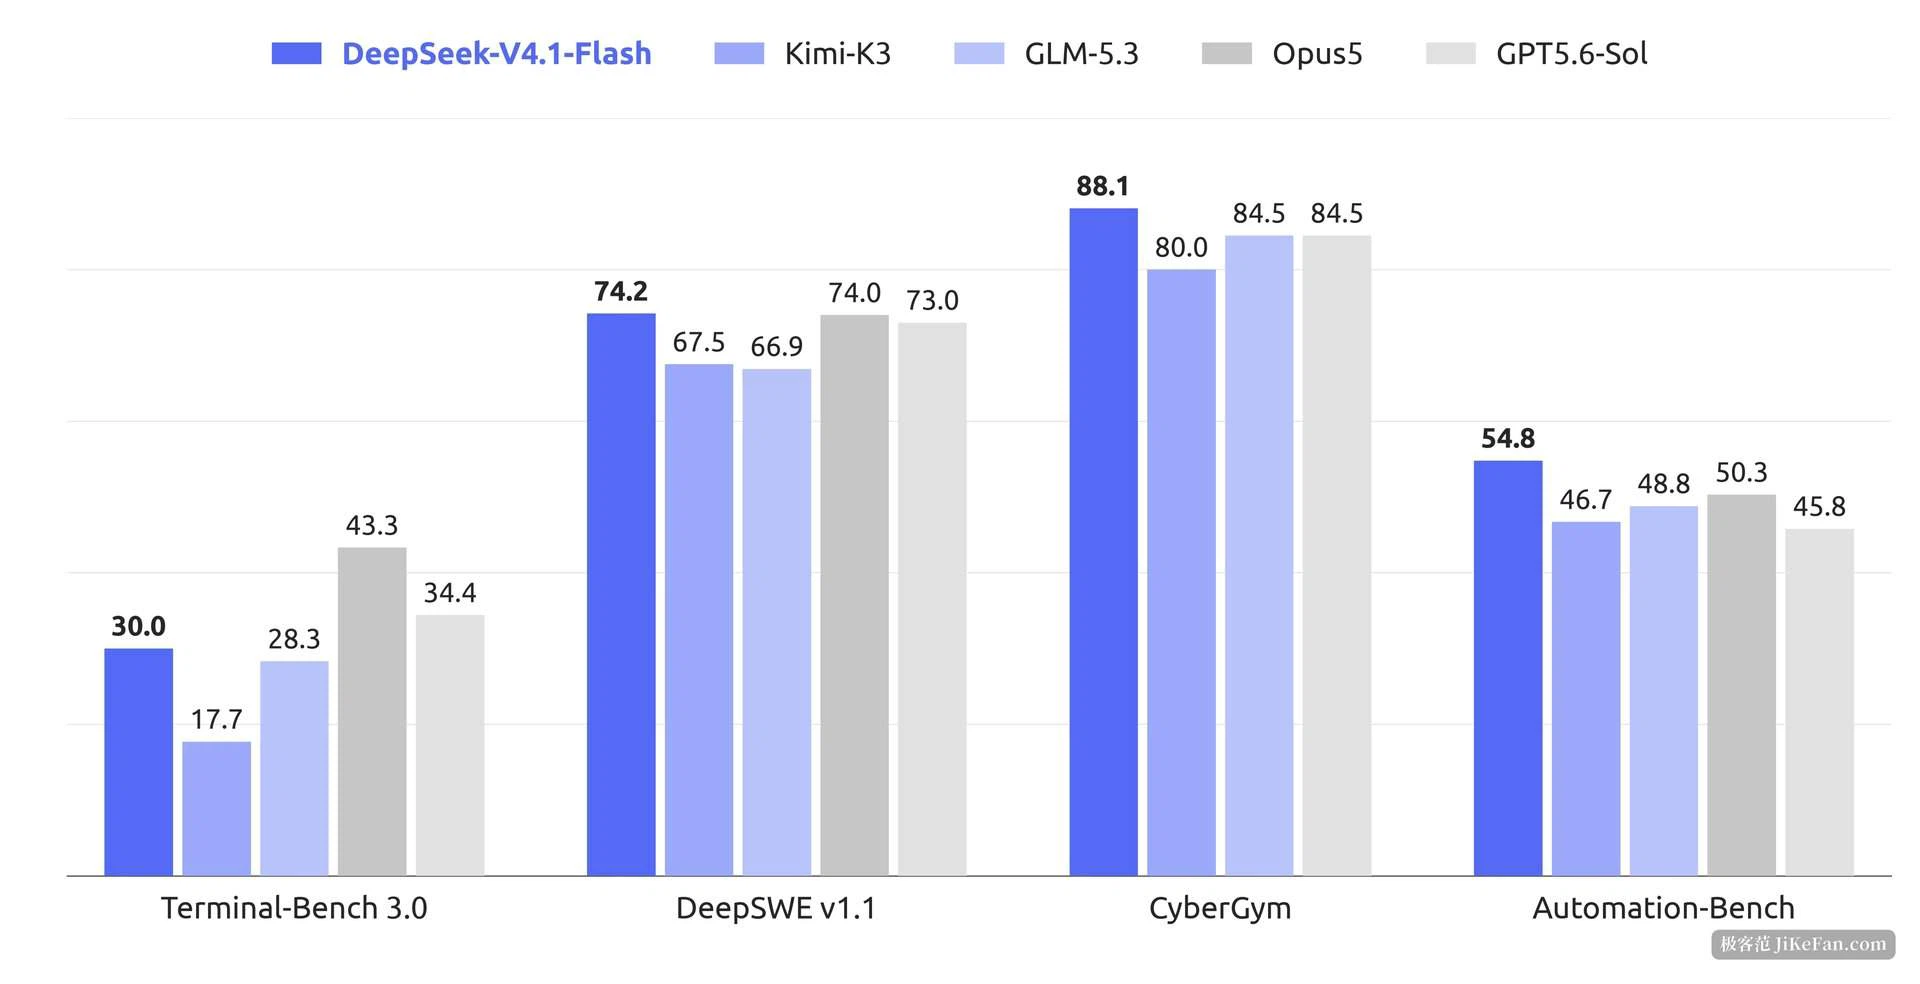
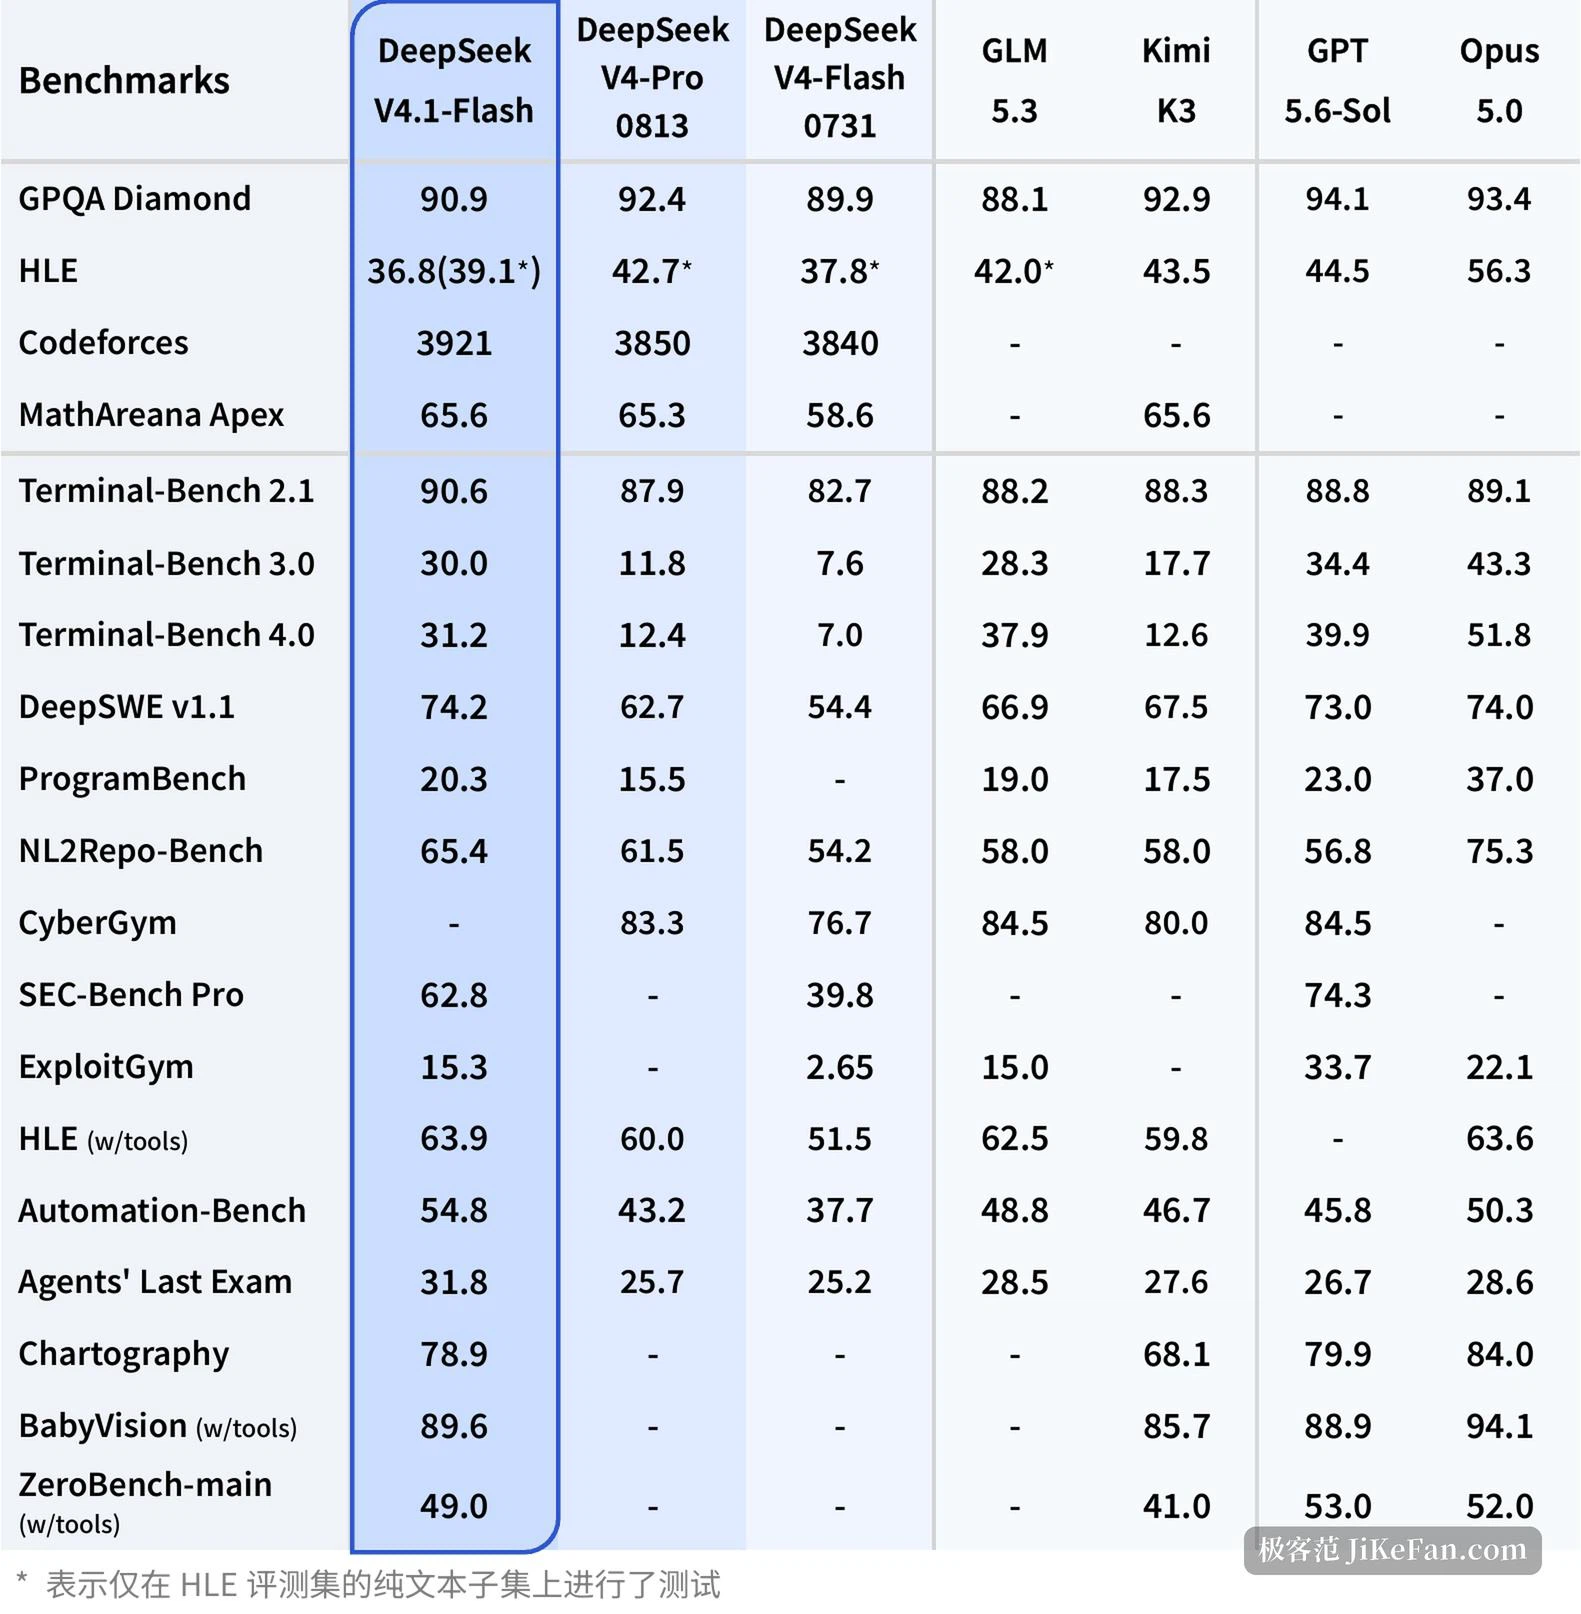
官方這回公開的基準成績裡,比較亮眼的是代理與程式設計方向:終端任務那項九十點六分,軟體工程七十四點二分,研究所程度的問答九十點九分,競賽程式設計評分三千四百七十一。這些是廠商自己的測試數字,不是第三方獨立評測,同一張表裡也有幾項明顯落後的科目,看的時候留個心眼。
價目表上真正變動的部分
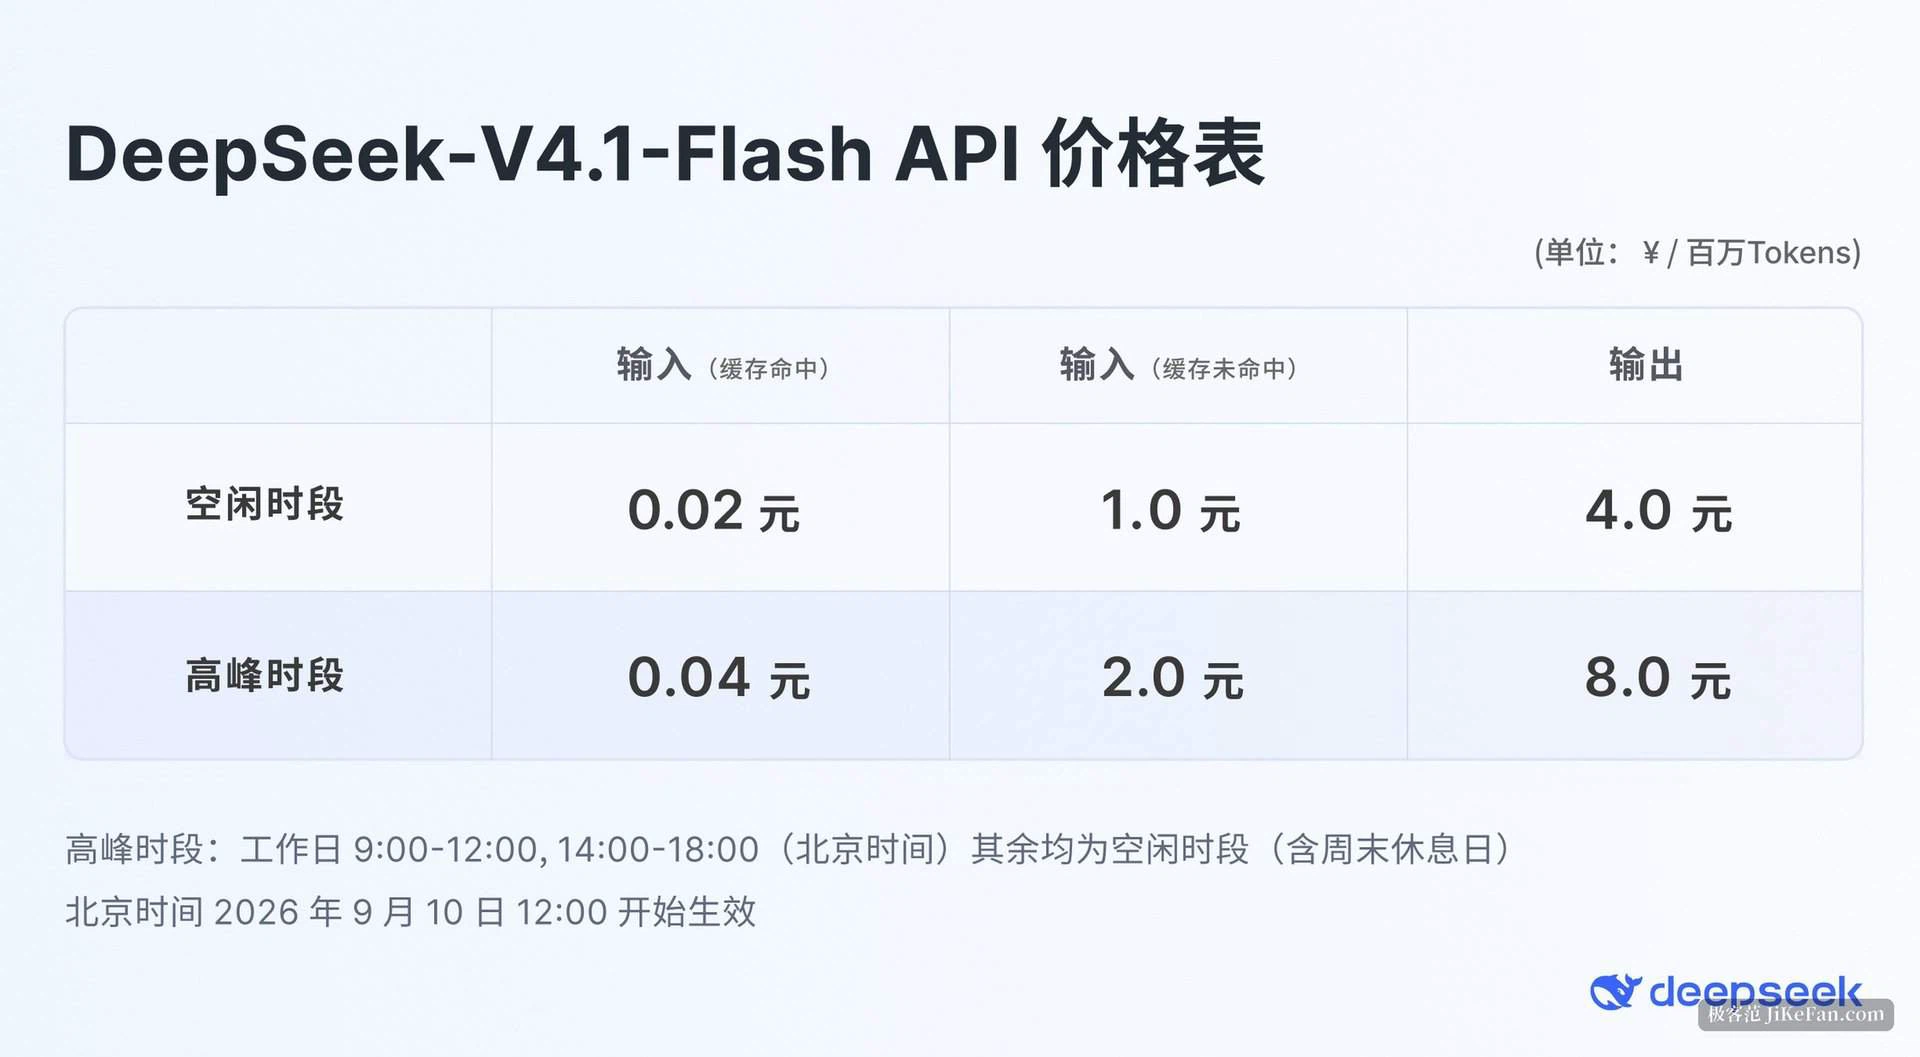
比起模型本身,API 側的改動可能更影響帳單。它沿用閒時與高峰雙檔定價,兩檔相差一倍。折算下來,閒時快取命中的輸入價是每百萬 token 兩分錢,官方稱這一檔比八月的水平下調了約六成;未命中的輸入 1 元,輸出 4 元。高峰檔一律翻倍,四分錢、2 元、8 元。
另外一件事是介面的遷移。官方原本計畫在 9 月 14 日中午之後,把發往舊模型的請求直接路由到新模型並按新價計費。公告發出後有不少開發者在討論相容性,官方隨後調整:9 月 14 日之後保留舊模型原有的呼叫入口,計費標準不變,不做強制切換。對已經在跑線上業務的人來說,這個結果比降價本身更讓人安心。
手機應用上多了個喇叭
模型之外,9 月 12 日應用裡加了一個語音入口。被灰度到的使用者,對話框右上角會出現一個小喇叭,點開就能直接說話,回覆也是語音。這項功能還在分批測試,沒有全面放開,看不到按鈕的人得再等等。
設定頁裡已經能選四種音色,官方按氣質分了從活潑到低沉的不同走向。語音補上以後,雙手和眼睛被佔著的時候也能用——開車、做飯、通勤路上,這些場景裡打字本來就不成立。
把時間線擺在一起看更清楚:9 月 10 日發新模型,能力與價格同時到位;9 月 12 日上語音,互動門檻再降一檔。兩個動作指向同一件事——把模型從開發者的工具箱裡拿出來,放進普通人的日常。
它的意義不在於又多了一個模型名字。它把讀的成本與寫的成本拆開算,把長上下文的快取壓到原來的零頭,再把權重以開放許可釋出——三件事疊在一起,等於把用 AI 處理日常任務的成本線又往下推了一截。對開發者與重度使用者來說,這是這一輪更新裡最實在的部分。