
Umi-OCR 2.1.5、通信なしで文字を読む
要約
Umi-OCR 2.1.5 は画面の切り取り、画像の入ったフォルダー、走査した PDF を通信なしで読む無料の道具です。範囲を選んで写せ、除外も指定できます。
おすすめ- ソフト名
- Umi-OCR
- バージョン
- 2.1.5
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinux
- 更新日時
- 2026-11-14 23:00
走査した紙、画面の切り取り、人から届いた画像。文字はそこにあるのに、文書へ移すには一文字ずつ打つしかない。一度やった人は覚えています。オンラインの認識は手間を省きますが、代わりにファイルを他人のサーバーへ渡すことになり、外部と切った機械、秘匿の要る材料、あるいは単に手間が嫌だという場合には使えません。Umi-OCR は立つ位置を変えました。認識の仕組みを自分の機械に置き、通信なしでも動きます。Python と Qt で書かれたオープンソースで、MIT の許諾のもと、配布物は展開すればそのまま動き、別の実行環境を要しません。公式は系統ごとに入れ物を分け、Windows と Linux にそれぞれ版があり、画面の言語も十数種を覆います。
無料、オープンソース、一括処理ができるオフラインの OCR ソフト。企画の表紙は自分の立ち位置を控えめに書き、形容詞を置かず三つの性質だけを並べています。
切り取ったあと、文字をなぞって選べる
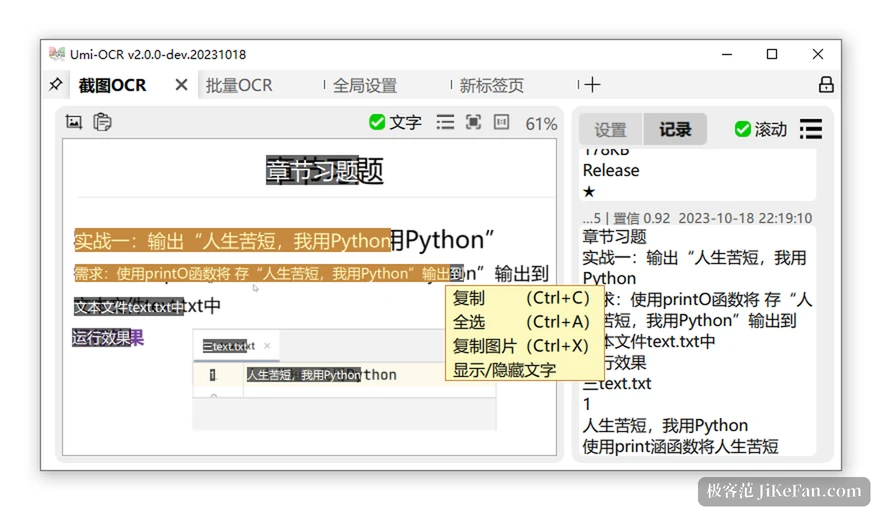
主画面は見出しの束ねで、切り取りの認識、一括の認識、全体の設定がそれぞれ一頁を占め、さらに新しい束ねを開けます。切り取りの頁は左に取ったばかりの画面、右の列に設定と記録が入ります。認識が終わると、左の絵の上で文字をなぞって選べ、右の記録は新しい順に結果を並べ、どの行にも確からしさが付きます。0.92 という数字は見栄えのするものではありませんが、その行をどれだけ信用してよいかを正直に示し、人が読み直すべき場所が一目で分かります。
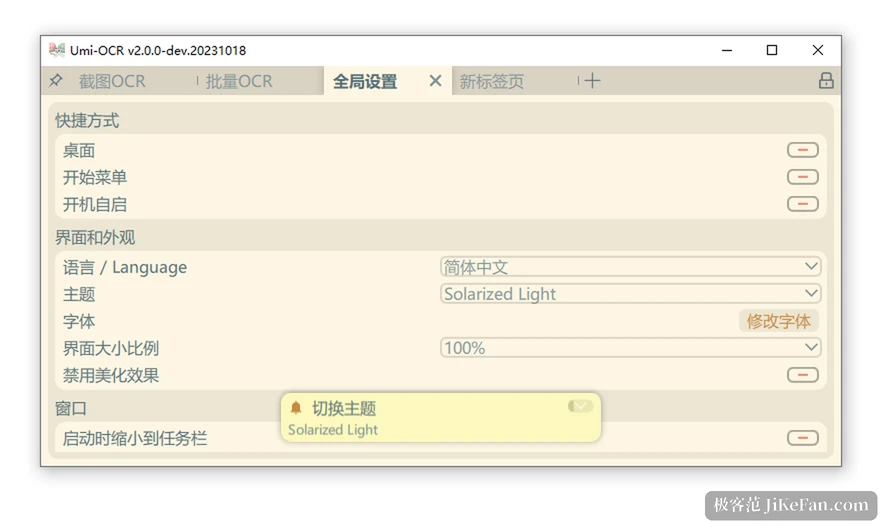
2.1.5 からは多くの頁が左右または上下の二列に切り替えられ、画面が狭いときは記録を下へ押し込んで絵に場所を回せます。Esc を押すと主画面が隠れる仕掛けは、切り取りを繰り返す人のための近道です。
組み方の解析で、乱れた塊を言葉に戻す
認識の根本的な罪は字を間違えることではなく、二段の段落を認識の順に一つの鍋へ放り込むことです。Umi-OCR は文字の後処理に組み方の解析を備え、複数列、単一列、単一行のいくつかの方法で結果を並べ直し、出力の順序を元の読み方に近づけます。単一行の方法はもう一つのよくある場合も扱います。離れた二つの塊の間に空白を一つ入れ、文がくっつかないようにするのです。
こうした細部は機能の一覧には出てきません。しかし長い一節を写し出して、句切りを手で直さずに済むと気づいたとき、違いが分かります。
一括の頁は小さな流れ作業の場
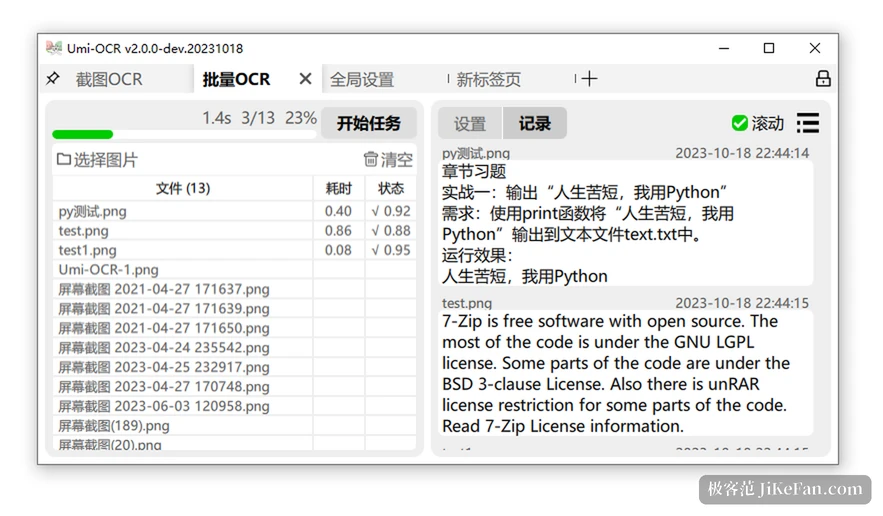
左にはファイルの一覧があり、名前、所要時間、状態が並び、状態の欄の印のあとには同じく確からしさが付きます。上の棒は済んだ枚数と割合を示します。右の記録はファイルごとにまとまり、絵を押せばその結果が読め、下へ転がせば同じ組の他のファイルの結果も見えます。
時間を縮めるのは同時に走らせることよりも、走らせながら読めることです。済んだファイルは一組の終わりを待たずに一覧へ入ります。2.1.5 は画像と文書の読み込みを非同期に変え、数万の下位ファイルを持つ場所でも滑らかに開き、棒も付いて動きます。同じ頁には除外の範囲もあります。四角を描けばその中の文字は認識に加わらず、切り取りに写り込んだ隅の印や透かし、時刻の表示をまとめて外せます。
走査した PDF も読める
文書の認識が扱うのは PDF です。一つは走査したもので、頁に文字の層がまったくなく、認識で補うしかありません。もう一つは元から層を持つもので、そのまま取り出せて認識の手間が省けます。出力は二通りで、素の文字として取り出すか、二層の検索できる PDF を作るかです。元の見た目は動かさず、下に目に見えない文字の層を敷くので、その後は閲覧ソフトで検索も複写も普通にできます。
2.1.5 はこれに関わる二つの不具合を直しました。頁を回したときに元の文字が抜け落ちること、そして一層の PDF を作るときに元の文字が書かれないことです。保管する契約書や説明書にとって、この二つは新しい機能より重いものでした。
他のプログラムから呼べてこそ本領
画面の外に二つの入口があります。命令行は起動時に指示を持て、動いている間にも遠くから任務を受けます。HTTP の接続口はこれを自分の機械の服務に変え、切り取り、画像、PDF を求めとして送れ、返る結果には行ごとの座標と確からしさが入ります。Linux の版は入れ物として走らせることもでき、自分の流れに組み込めます。
2.1.5 が足した記録の仕組みはこの道のためにあります。命令行の引数を付けて起動すれば今の記録が見え、指定した段階以上の記録は記録の場所へ落ちるので、認識の失敗を当て推量で追わずに済みます。同じ版には設定を読み直す指示も加わり、値を変えたあとに道具全体を入れ直さずに済みます。
先に知っておく二つの境目
認識の仕組みは差し込みの形で入り、配布は仕組みごとに二つの包みに分かれます。速い方は処理装置の命令の組に条件を付け、Pentium、Celeron、Atom のような古い処理装置では動きません。立ち上がらないときは互換の版に替えます。これは欠陥ではなく推論の枠組み自体の制約で、企画の文書にもそのまま書かれています。
もう一つの境目は、認識はしても版面は戻さないことです。表は文字の流れとして出てくるので、構造を保ちたいなら自分で組み直します。画面の言語は十数種を覆い、地域の訳の仕組みで保たれ、中国語と英語も入っています。
何のための道具か
Umi-OCR 2.1.5 を使う場面へ戻して見ると、解く問題は狭いものです。画像や走査した紙の中の文字を、写せて、検索できて、他のプログラムへ渡せる文字に変える。しかもその過程は自分の機械から出ません。切り取りでのなぞり、一括の順番待ち、除外の範囲、二層の PDF、命令行と接続口。これらが揃えば、たまに一度使うところから自動化の一工程までを覆えます。無料でオープンソース、口座も通信も要らない。秘匿の要る材料を扱う場面では、この三つだけで選ぶ理由になります。