
Scrapling 0.5.1、サイトを Markdown にし AI に操作を渡す
要約
Scrapling 0.5.1 は、ページもサイト丸ごとも Markdown に変える Python の枠組みです。改版後も要素を探し直せます。
おすすめ- ソフト名
- Scrapling
- バージョン
- 0.5.1
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsmacOSLinux
- 更新日時
- 2026-11-10 23:00
Scrapling は Python で書かれたウェブ抽出の枠組みで、要求を出す、ブラウザを開く、ページを解析する、サイト全体を集める、書き出す、という工程をひとつのライブラリにまとめている。2026 年 11 月 4 日に出た 0.5.1 版は二つのことをした。ブラウザのセッションを外部のプログラムに明け渡し、エージェントが動きとドラッグを読めるようにしたこと。そして「サイト全体をきれいな Markdown に」という道を整えたことだ。自分の語料を集めたい人、AI に公開ページを読ませたい人なら、十分で全体像がつかめる。Windows、macOS、Linux で動く。
まずページを Markdown に洗ってから、モデルに渡す
大きなモデルは生の HTML を読むと損をする。ナビゲーション、スクリプト、スタイル、広告枠が同じ file の中にあり、役に立つ本文は真ん中に挟まっている。文字数で課金されるとき、その雑音にも同じだけ払う。Scrapling は引き算を変換の段に置く。markdown() を呼んだあと、スクリプト、スタイル、隠れた要素は空になり、CSS で隠された白文字、aria-hidden の付いた区画、HTML のコメント、幅のない文字も一緒に消える。
この道にモデルは介在しない。手元の文字列処理なので、一万ページを取ってもモデルの費用は出ない。節約は金だけではない。きれいな語料は下流の分割を安定させ、検索で出てきた断片に半画面のメニューが付いてこない。
サイト全体の変換には雛形がある。許可するドメインを決め、本文の選択子を指定し、ページ数の上限を与えると、.md ファイルの入ったフォルダと、出所・題名・本文を持つ JSONL が残る。そのまま知識ベースに流し込める。ドキュメントサイト、ブログ、製品の手引きのように構造の整った site は、この方法がいちばん楽だ。
要素が指紋を持ち、改版しても選択子を書き直さない
抽出スクリプトの脆いところは選択子だ。サイトが CSS のクラス名を入れ替えると、昨日まで動いたコードが空のリストを返し、記録を何層もたどって初めて原因が見える。適応型の要素追跡は別の道を行く。最初の特定で位置、属性、文字の特徴を指紋として覚え、構造が変わったあとは類似度で「場所は移ったが同じもの」である節点を探し直す。
似た要素の照合はもう一つのよくある場面を引き受ける。同じ作りのかードが数十枚並ぶページで、その一つだけが要る。まず基準の要素を見つけ、そこから構造の類似で広げる。手書きの nth-child より持ちこたえる。
一度の要求もサイト全体も、書き方は同じ一組
- Fetcher
- 普通の HTTP 要求に、実在のブラウザと同じ TLS 指紋とヘッダを載せる。静的ページと公開の接口にはこれで足りる。
- ブラウザ系の取得器
- Playwright で Chromium を動かし、JavaScript の実行が終わってから中身を取る。すでに開いているブラウザにぶら下がることもできる。
- Spider
- 並行して集め、自動で速度を絞り、Ctrl+C で進み具合を残して次回に続ける。結果は JSON、JSONL、CSV、XML に書き出す。
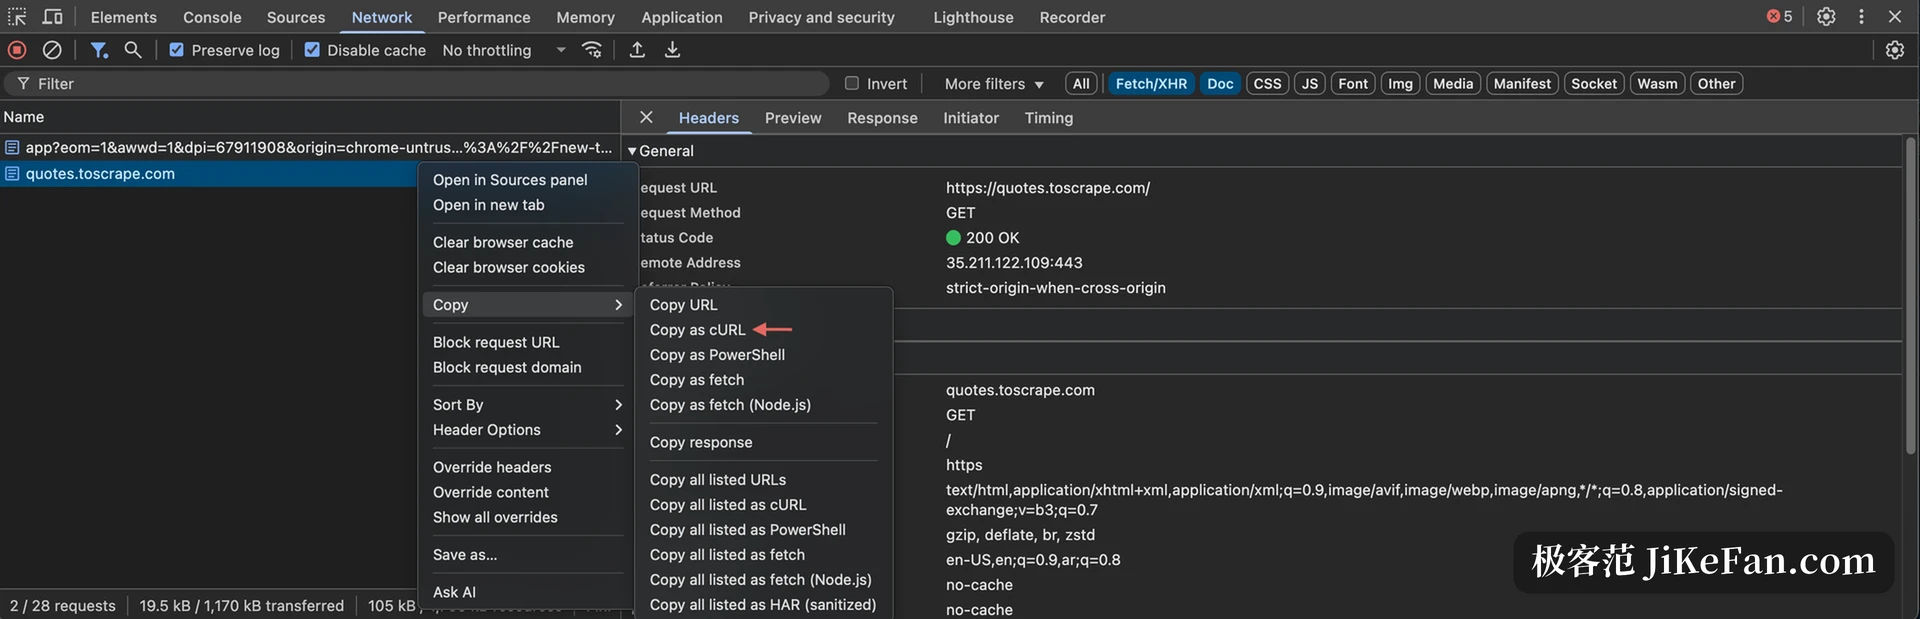
三つの取り方は解析の接口を共有する。同じ選択子のコードが、fetcher を替えるだけで静的ページから動的ページへ移る。JavaScript を描くために別の書き方を用意する必要はない。ページの裏の XHR も記録でき、接口が返すデータは描画後の HTML より整っていることが多い。
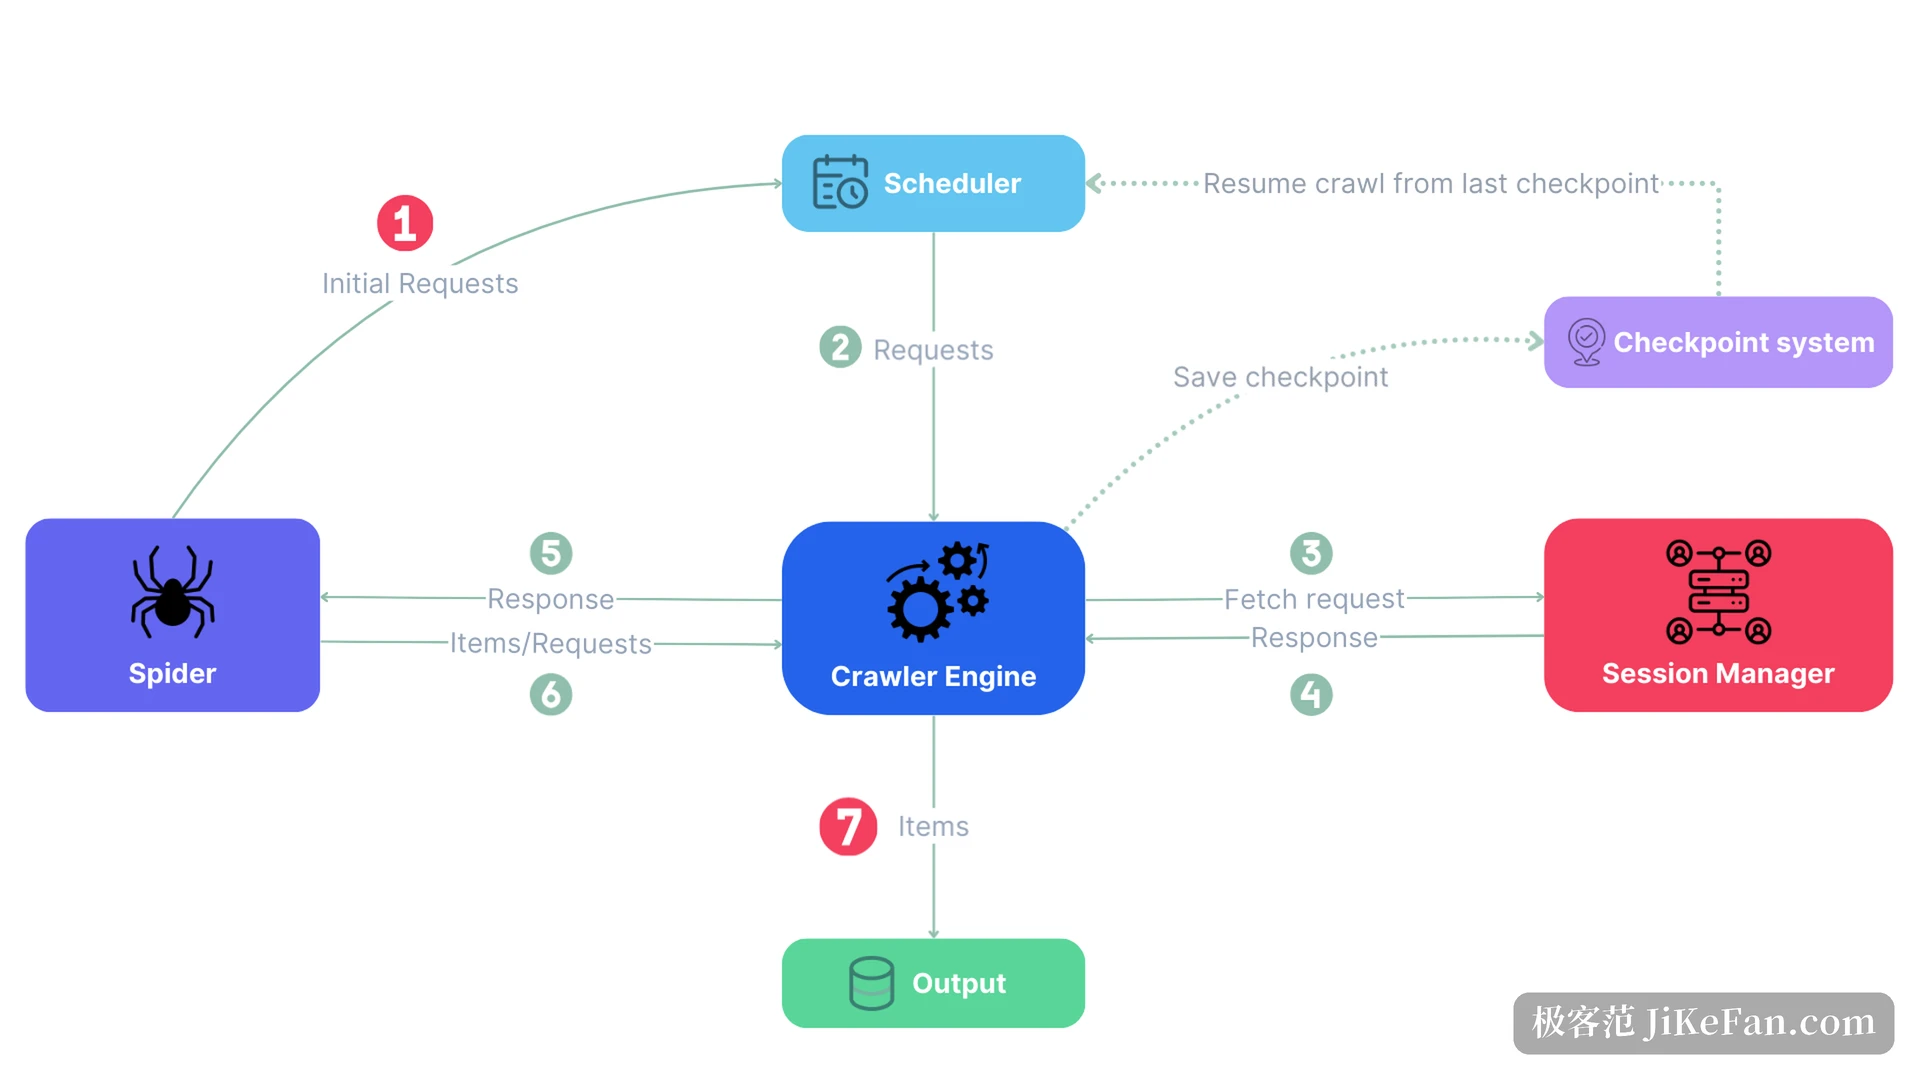
小さな工夫が一つ効いている。ブラウザで接口を調べるとき、右クリックの「cURL としてコピー」で完全な要求が手に入る。その命令を Scrapling の対話シェルに貼ると、再利用できる取得の文に変わる。まず一度走らせ、それからスクリプトに移せばよい。ヘッダを一から組み立てる手間が消える。
0.5.1 が開けた三つの口
| 版 | 日付 | 主な変更 |
|---|---|---|
| 0.5 | 2026-10-17 | MCP サーバーにブラウザの一連の流れが揃い、通信の記録とログイン状態の保存、開いた Shadow DOM への対応、広度優先か深度優先かの選択が入った。 |
| 0.5.1 | 2026-11-04 | 遠隔セッションのクラスが加わり、実行中の Chromium をそのまま引き継げる。エージェントは動きを見て、マウスを押したままドラッグできる。 |
遠隔セッションの意味は、ブラウザと取得の処理を分けられることにある。CDP の端点で動いている Chromium につなぎ、既定では元の文脈をそのまま使い、ログイン状態も受け継ぎ、セッションを切っても開いたタブは残る。以前はログイン情報を持って回るために、状態ファイルを何度も読み書きするしかなかった。
動きとドラッグはエージェント向けだ。一枚の画像は一瞬しか残さず、アニメーション、スクロール後の位置、つまみのような操作は、静止画では前後が分からない。0.5.1 は連続した画面からページが何をしているかを読み、マウスを押し、動かし、途中で止めて確かめ、離せる。道具の説明も同時に縮められ、同じ能力が使う文脈を減らした。
エージェントへの入口は一つではない
MCP サーバーが手を動かす。ページを開く、押す、記入する、転がす、撮る、接口の返りを読む、がすべて道具になり、クライアントをつないだあとは「このページの引数を表にまとめて」で終わる。エージェント技能は別の仕事をする。版に追随して更新される手引きで、コードを書く助手が必要なときに引き、古い記憶で接口を組み立て直さずに済む。命令行と対話シェルが三つ目の道で、一度の要求を通してからスクリプトに落とすのに向く。
三つの道は三人に向く。データの流れを作る人は Python の接口だけを使い、端末で試すのが好きな人はシェルを、集める仕事をエージェントに渡す人は MCP に触る。
境界はやはり境界のまま
できることが増えるほど、何を取るかを先に決める必要がある。公開の文書、公開の価格、公表された政策の資料は普通の用途だ。相手のサイトが自動の access を明確に禁じている、あるいは中身がログインの先にあるなら、手を出さない。Scrapling の Spider は robots.txt を守る設定を選べ、ドメインで範囲を限れるので、取得は対象の中で収まる。
頻度も控え目がいい。一日に一度か二度で変化は分かるし、他人のサーバーを負荷試験の相手にする理由はない。
Scrapling 0.5.1 の値打ちは「取れる」ことではなく「取ったあとそのまま使える」ことにある。ページを入れればきれいな Markdown になり、要素が場所を変えても自分で見つけ直し、エージェントも操作を引き継げる。全体はオープンで手元で動くが、代わりにコードを書く道具であることは変わらない。箱から出してすぐ使えると期待する人には向かない。恩恵を受けるのは、すでに知識ベースを自前で作り、あるいはエージェントのためにデータの道を敷いている人だ。