
Auto-Ontology、データに辞書を立てて AI に答えさせる
要約
Auto-Ontology はデータベースから業務辞書を育てる NVIDIA のオープンソース意味層です。答えには SQL と実行手順が付きます。
おすすめ- ソフト名
- Auto-Ontology
- バージョン
- 0.1
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- LinuxWeb
- 更新日時
- 2026-11-10 23:00
Auto-Ontology は NVIDIA が公開しているオープンソースのセマンティック層である。既存のデータベースから業務用語の辞書を育て、その辞書に沿ってエージェントに答えさせる。狙っているのは、データを自分で見る場面でよく起きる失敗だ。モデルが「売上」を別の列として読み、SQL は通るのに数字が違う。自然言語で業務データを引きたいが、モデルの出力をそのまま信じる気にはならない、というチーム向けの作りになっている。コードは Apache 2.0 で、画面はウェブ、背面はコンテナで動き、モデルの端点を一つつなげば始められる。
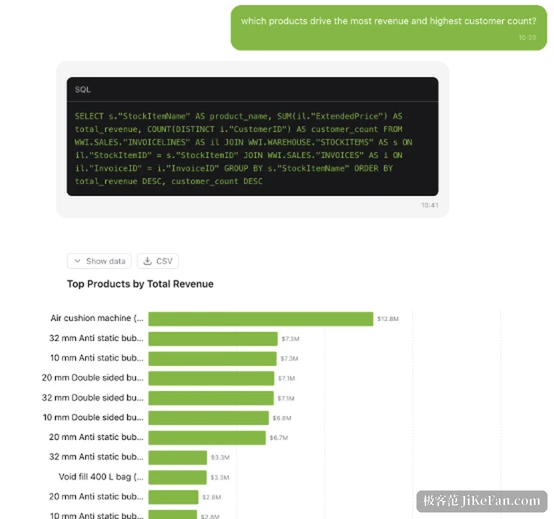
足りないのは翻訳ではなく辞書だ
自然言語を SQL に変えること自体は、何年も前から技術的に可能だ。難しいのは意味のほうになる。「顧客数」は、注文表では注文した口座を数え、顧客表では登録された会社を数える。「売上」は税込かもしれないし税抜かもしれず、請求済みかもしれず未収かもしれない。モデルは自社がどの定義で数えているかを知らないので、もっともらしい列を一つ選ぶ。
Auto-Ontology はまずその文脈を埋める。データがどこにあり、何と呼ばれ、使ってよいのか、どう使うのか、どこから来たのか、どれと似ているのか。こうした情報は普段、データ辞書と SQL のスクリプトと、長くいる人の頭の中に散らばっている。これを問い合わせできる構造にまとめ、エージェントに渡すのがこの道具の仕事だ。
辞書に入る三種類
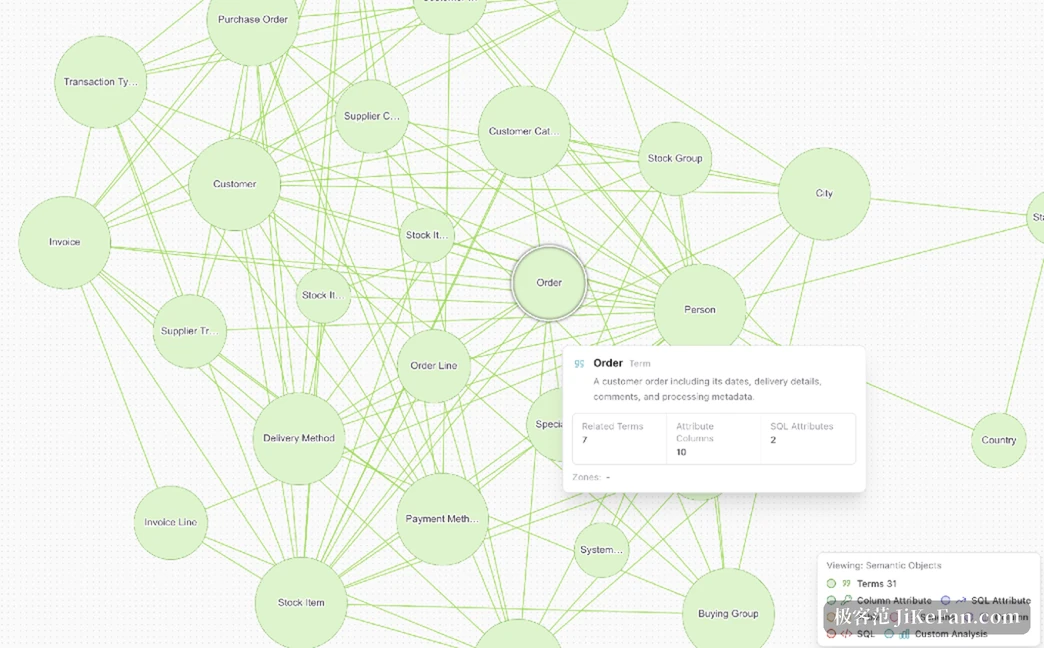
用語は業務の概念で、「顧客」「請求行」のように説明と同義語を持ち、具体的な列に対応づく。SQL 属性は用語の下にぶら下がる検証済みの式で、たとえば粗利率にあたる。エージェントは同じ計算を再利用し、別の式を作らない。関係は表と表がどうつながるかを記録し、橋渡しの表も含み、鍵とデータの形から推測される。
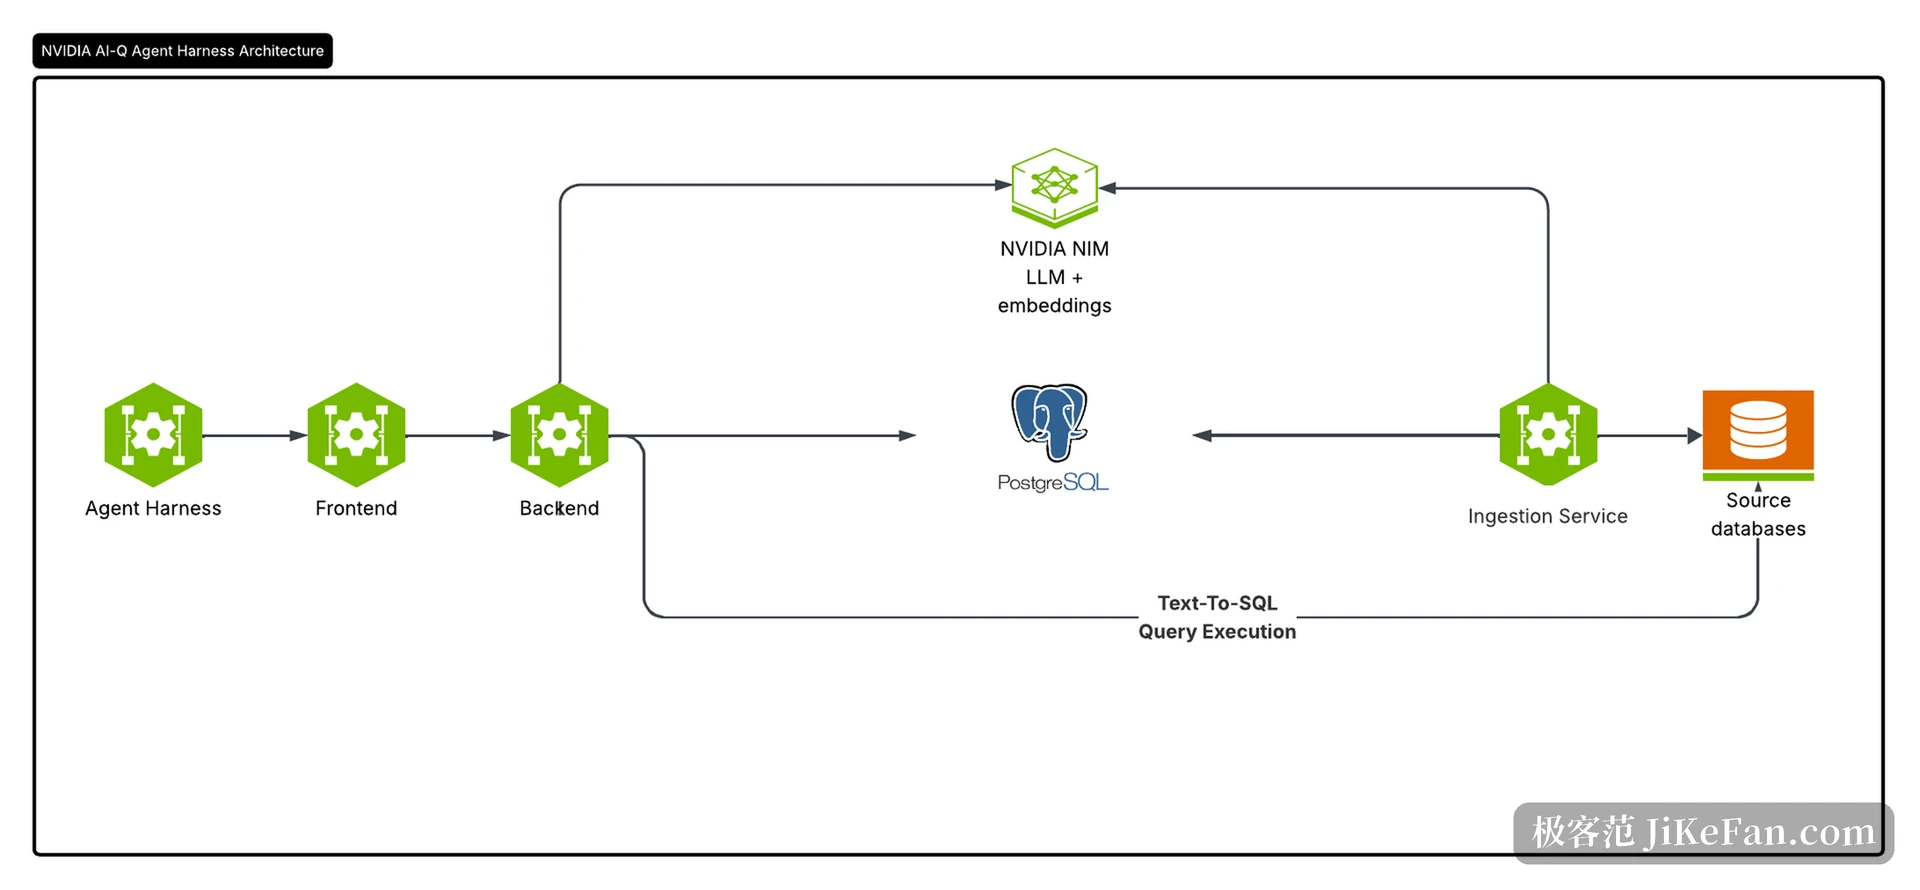
生成は四段階で進む。取り込みサービスが元のデータベースを読み、構造を抜き、列の傾向と値の見本を取る。次に表ごとに用語を抜き出して列に対応づけ、表のあいだのつながりを推測し、過去の問い合わせから SQL 属性を提案する。最後に用語と関係と属性を Postgres に書き、検索用のベクトルを pgvector に置く。
走らせたあとに見えるのは、クリックして辿れる意味のグラフだ。公式の見本は Microsoft の Wide World Importers という売上の見本データベースを使い、一度のコンパイルで 31 の用語が出る。「注文」を選ぶと、説明、関連する用語、対応する列、そして 2 つの SQL 属性が右側に並ぶ。数字は小さいが、この構造がどんな形かを示すには足りる。
機械が下書きし、人が署名する
自動で出てきたものをそのまま使うわけにはいかない。この企画では「認証」を独立した工程にしている。対話の中で実際の質問を試すか、MCP 経由で検査の道具を呼ぶ。用語の説明が違う、SQL 属性の計算が違うと分かったら画面で直し、直したうえで一つずつ認証する。認証済みの名前と説明と式だけが、その後の回答で信頼できる定義として扱われる。
回りくどく見えるが、ここが要になる。セマンティック層の値打ちは、どれだけ速く生成するかではなく、定義のそれぞれに責任を持つ人がいることにある。認証の印は、その責任を書き留める場所だ。
数字を出す前に検証を一段はさむ
質問には五つの関門がある。意図を読み、質問に出てくる実体を抜く。ベクトル検索で候補の用語、列、属性を集める。それをもとに SQL を書く。絞り込みの値と問い合わせ全体をデータベースに当てて試し、通らなければ直す。最後に実行し、答えと SQL と手順をまとめて返す。
四つ目の関門が、普通の問い合わせ道具との差になる。多くの道具は SQL を書いたらそのまま走らせ、空の結果でも桁の違う数字でも平気で出す。ここではまず「ペンシルベニア州」のような絞り込みの値がデータベースに実在するか、書き方がデータと合っているかを確かめ、問い合わせ自体も先に試し打ちする。
断る道も用意されている。公式の見本で「ある製品の 2015 年 6 月の広告の効果」を聞くと、見本のデータに広告はない。網羅率は 0.5 になり、数字を作らずに「このデータに広告費はありません。その月の売上を見るか、広告のデータが別のデータベースにあるかを確認してはどうか」と返す。この答えは、精確に見える間違った数字よりずっと役に立つ。
MCP でエージェントにつなぐ
FastMCP で書かれたサーバーが同梱され、外に出す道具は読み取りだけに限られる。配備が整っているかの確認、用語の検索、用語の列と SQL 属性の取得、いまの本体で答えられる質問かの判定、そして質問を投げて答えとデータ行を受け取る。呼び出しはすべてログインした利用者の権限で動くので、万能の鍵ではない。
セマンティックモデルをやり取りする標準の Apache Ossie にも対応し、YAML を入出力できる。既にあるセマンティックモデルを捨てなくてよく、データウェアハウスの統制をすでに敷いているチームにはありがたい。
費用と向き不向き
入れて終わりの道具ではない。配備は Docker Compose か Helm で行い、Postgres 17 が要り、NVIDIA のモデル端点につながる必要がある。推論も埋め込みもそこを通るため、託された版でも自前でもよい。既定の設定にはモデルまで入っており、替えるには環境変数を書き換える。
向く場面ははっきりしている。データベースが多く、定義がばらつき、業務側が自分で数字を見たがっている。中核のデータベースを一つか二つつなぎ、本体を一度コンパイルし、数十の用語を人の手で認証してからエージェントに開放する。この道は通る。向かない場面も同じくらいはっきりしている。データベースが一つで、列の名前から中身が分かる小さなチームでは、維持の手間が利点を上回る。
Auto-Ontology が見る価値のある理由は、質問を SQL に変えられることではない。モデルは自社の定義を知らないと認めたうえで、その定義を人が点検でき、機械が引ける層に仕立てたことにある。数字が正しいかは最後は人がうなずくことで決まり、この道具はそのうなずきに置き場所を与えている。