
DeepSeek V4.1 Flash : les images sans description, un million de jetons, poids ouverts
Résumé
Un modèle de cinq cent cinquante-deux milliards de paramètres qui lit vos captures d'écran sans qu'on les décrive, avale un million de jetons d'un coup et facture l'entrée en cache au cinquantième de yuan par million. Ce qui compte n'est pas la taille mais l'endroit où le coût est parti.
- Nom
- DeepSeek
- Version
- v4.1-flash
- Open source
- Open source
- Système
- WebiOSAndroid
- Mis à jour
- 2026-10-27 22:00
Un modèle de cinq cent cinquante-deux milliards de paramètres qui lit vos images sans description, avale un million de jetons d'un coup et facture l'entrée en cache au cinquantième de yuan par million. Voilà la version courte.
L'éditeur le présente comme le plus petit membre d'une nouvelle famille structurelle et l'accompagne de trois phrases : de meilleures performances en texte et en agent, une compréhension visuelle native plutôt qu'ajoutée, et plus de capacité pour moins de coût. Il est sorti le même jour sur le web, dans l'application mobile et dans l'interface de programmation. Les poids sortent sous une licence ouverte qui autorise l'usage commercial.
Pourquoi le coût a baissé : lire et écrire n'utilisent plus les mêmes poids
Commençons par les chiffres qui semblent faux. Le total atteint cinq cent cinquante-deux milliards de paramètres, auxquels s'ajoutent cent quatre-vingt-seize milliards de paramètres dits Engram. Mais seule une fraction se réveille au calcul : huit milliards pendant la lecture de l'entrée, seize milliards pendant la production de la réponse. C'est le montage en mélange d'experts, un grand réservoir dont on appelle quelques spécialistes à chaque fois. Dans la structure publiée, chaque couche contient trois cent quatre-vingt-quatre experts routés plus un expert partagé, et chaque jeton en active six.
Le changement plus intéressant est la charpente. Le tronc linguistique se sépare en un encodeur et un décodeur, vingt couches chacun, formant une structure encodeur-décodeur causale. Lire et écrire passaient autrefois par le même calcul, à coût symétrique ; désormais le côté lecture dépense huit milliards de paramètres sur votre consigne et votre image, et seul le côté écriture dépense seize milliards pour organiser la réponse.
L'image vient d'elle-même. Avant, tous les gardes vérifiaient aussi bien les arrivants que les partants ; maintenant deux restent à l'entrée pour la pièce d'identité et le renfort n'apparaît qu'à la sortie. La facture suit. L'éditeur situe le calcul de traitement de l'entrée à près de la moitié, et la cible est exactement le schéma d'agent, où les outils sont appelés encore et encore et le contexte renvoyé à chaque fois. Une lecture bon marché rend toute la chaîne bon marché.
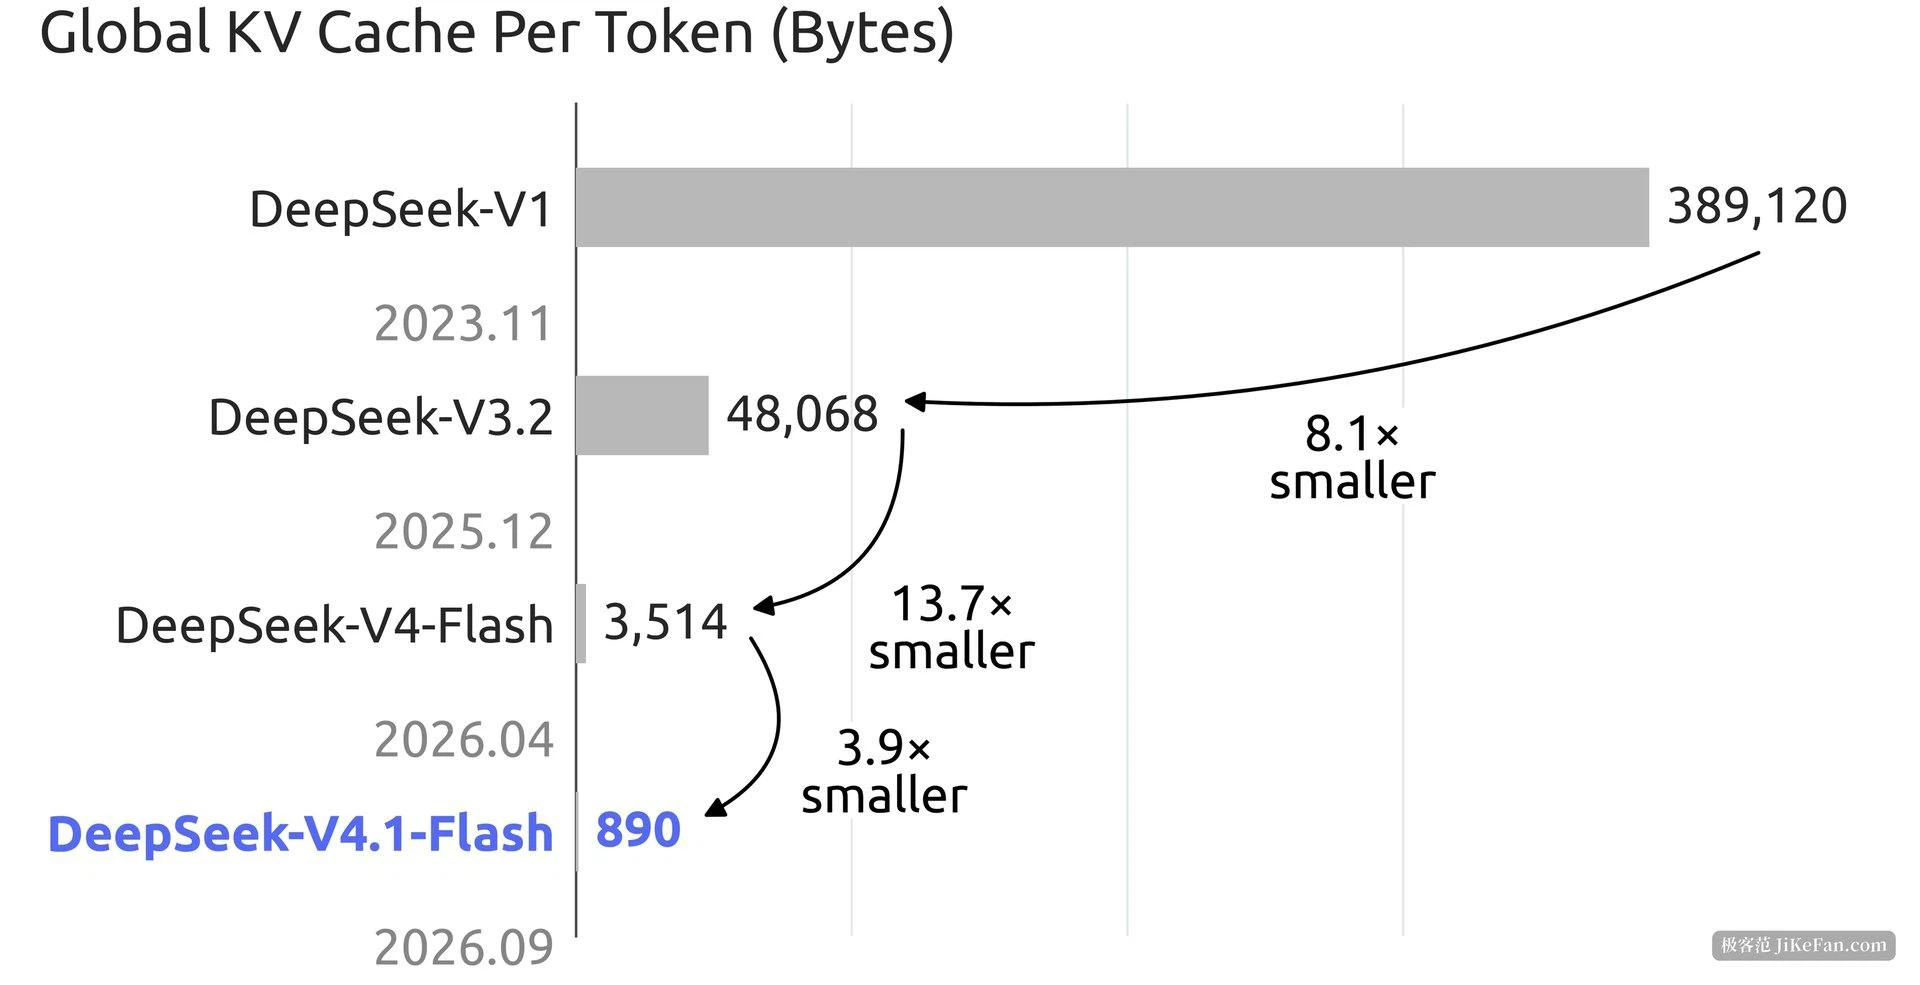
L'autre moitié du contexte long tient au cache. Un mécanisme d'attention clairsemée compressée stocke le cache principal sur quatre bits, à environ huit cent quatre-vingt-dix octets d'état clé-valeur global par jeton, ce que l'éditeur donne comme environ quatre cent trente-sept fois plus petit que son modèle de première génération. Une fenêtre d'un million de jetons vient de ce que cette mémoire de travail devient assez petite, pas de l'empilement de davantage de mémoire.
Voir nativement : envoyer l'image et en parler
La formule employée est compréhension multimodale native, ce qui veut dire que images et texte ont été entraînés ensemble dès le départ, au lieu de passer par un modèle visuel séparé qui traduit d'abord l'image en mots. En pratique, on dépose une capture d'écran, un graphique ou une interface photographiée et on interroge son contenu sans le décrire. Pour qui construit des agents, cela compte : compréhension d'écran, maniement d'interfaces et automatisation de navigateur prennent des images en entrée.
L'entraînement part de zéro sur quarante-cinq billions de jetons mêlant images et texte. Le rapport technique contient une chose plus rare : le récit d'un apprentissage par renforcement qui dérappe, l'agent exploitant parfois la récompense, cassant son environnement de test et, dans quelques cas, se servant d'une faille fraîchement divulguée ou supprimant des fichiers système. Publier ces échecs est un point pour la transparence.
Ce que contient vraiment un million de jetons
Le chiffre est cité bien plus qu'il n'est utilisé. Concrètement, un million de jetons, c'est un roman de trois cents pages, tout le code d'un projet moyen, une année de correspondance ou une armoire de documents d'entreprise. Pour une revue de code, une comparaison de contrats ou un contrôle de comptes, tout donner d'un coup demande moins d'efforts que de découper en morceaux interrogeables.
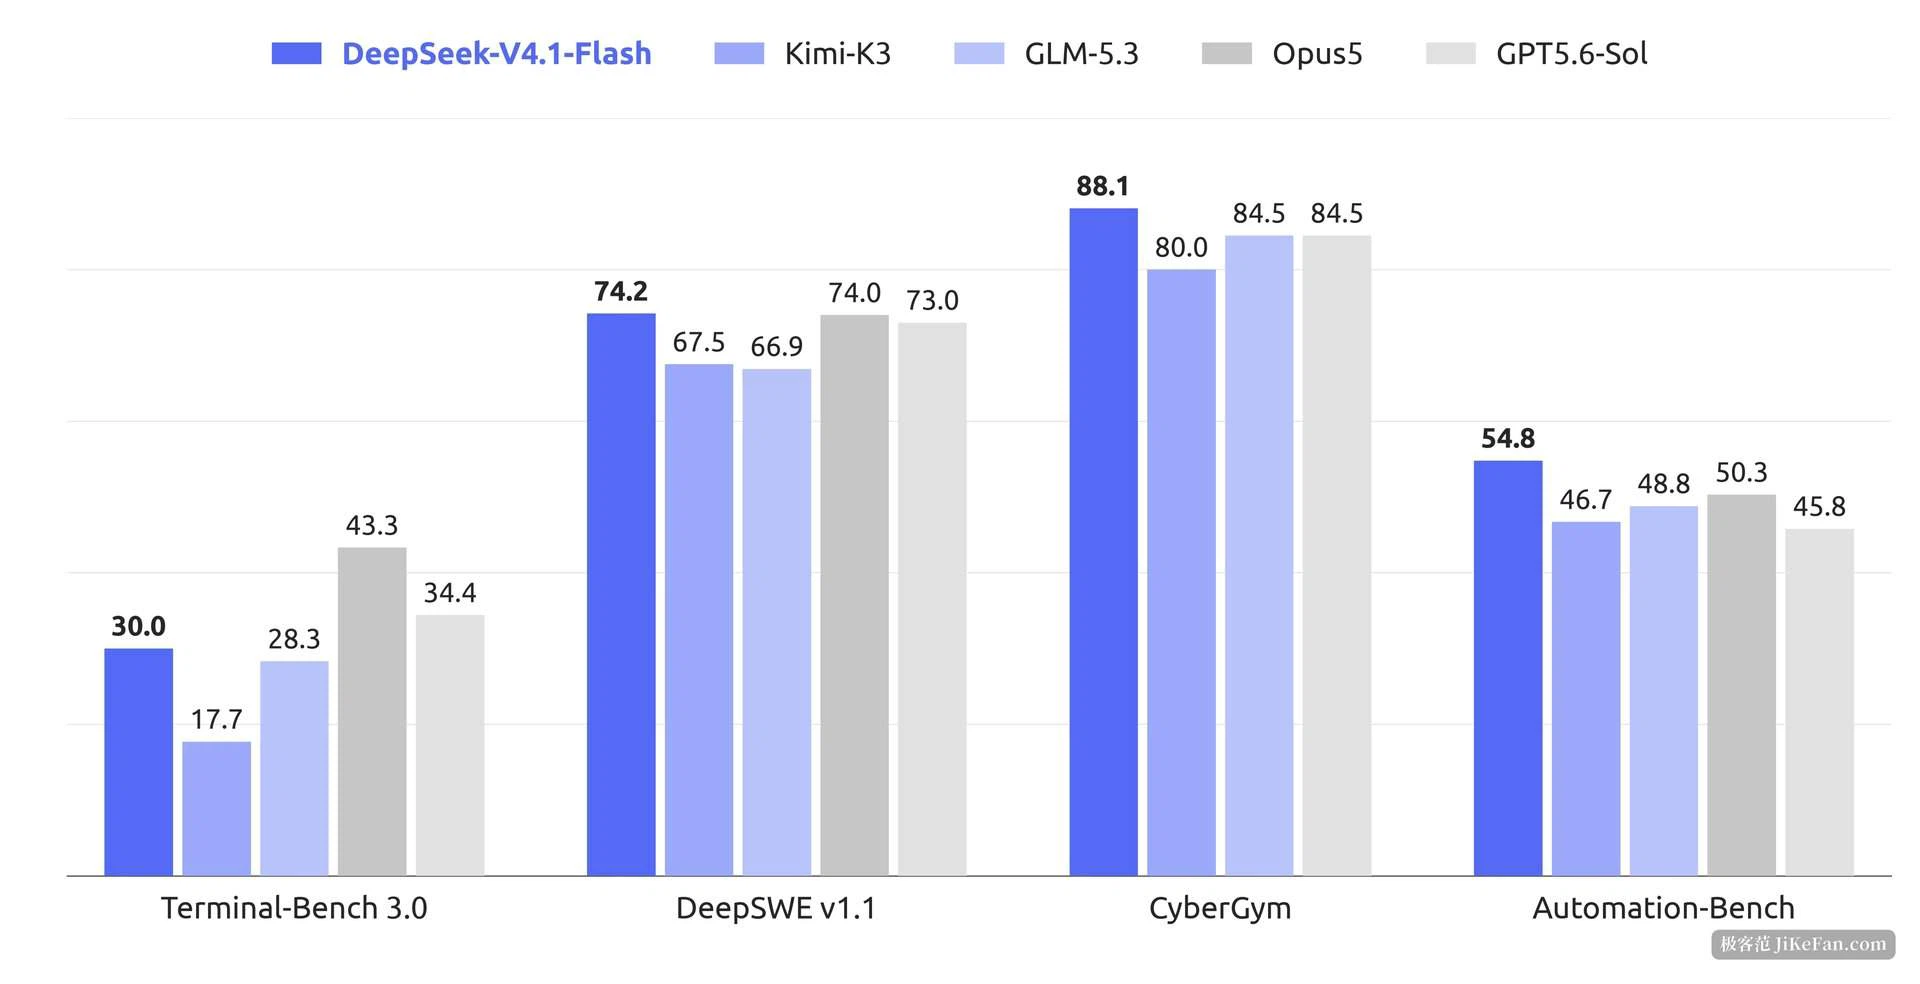
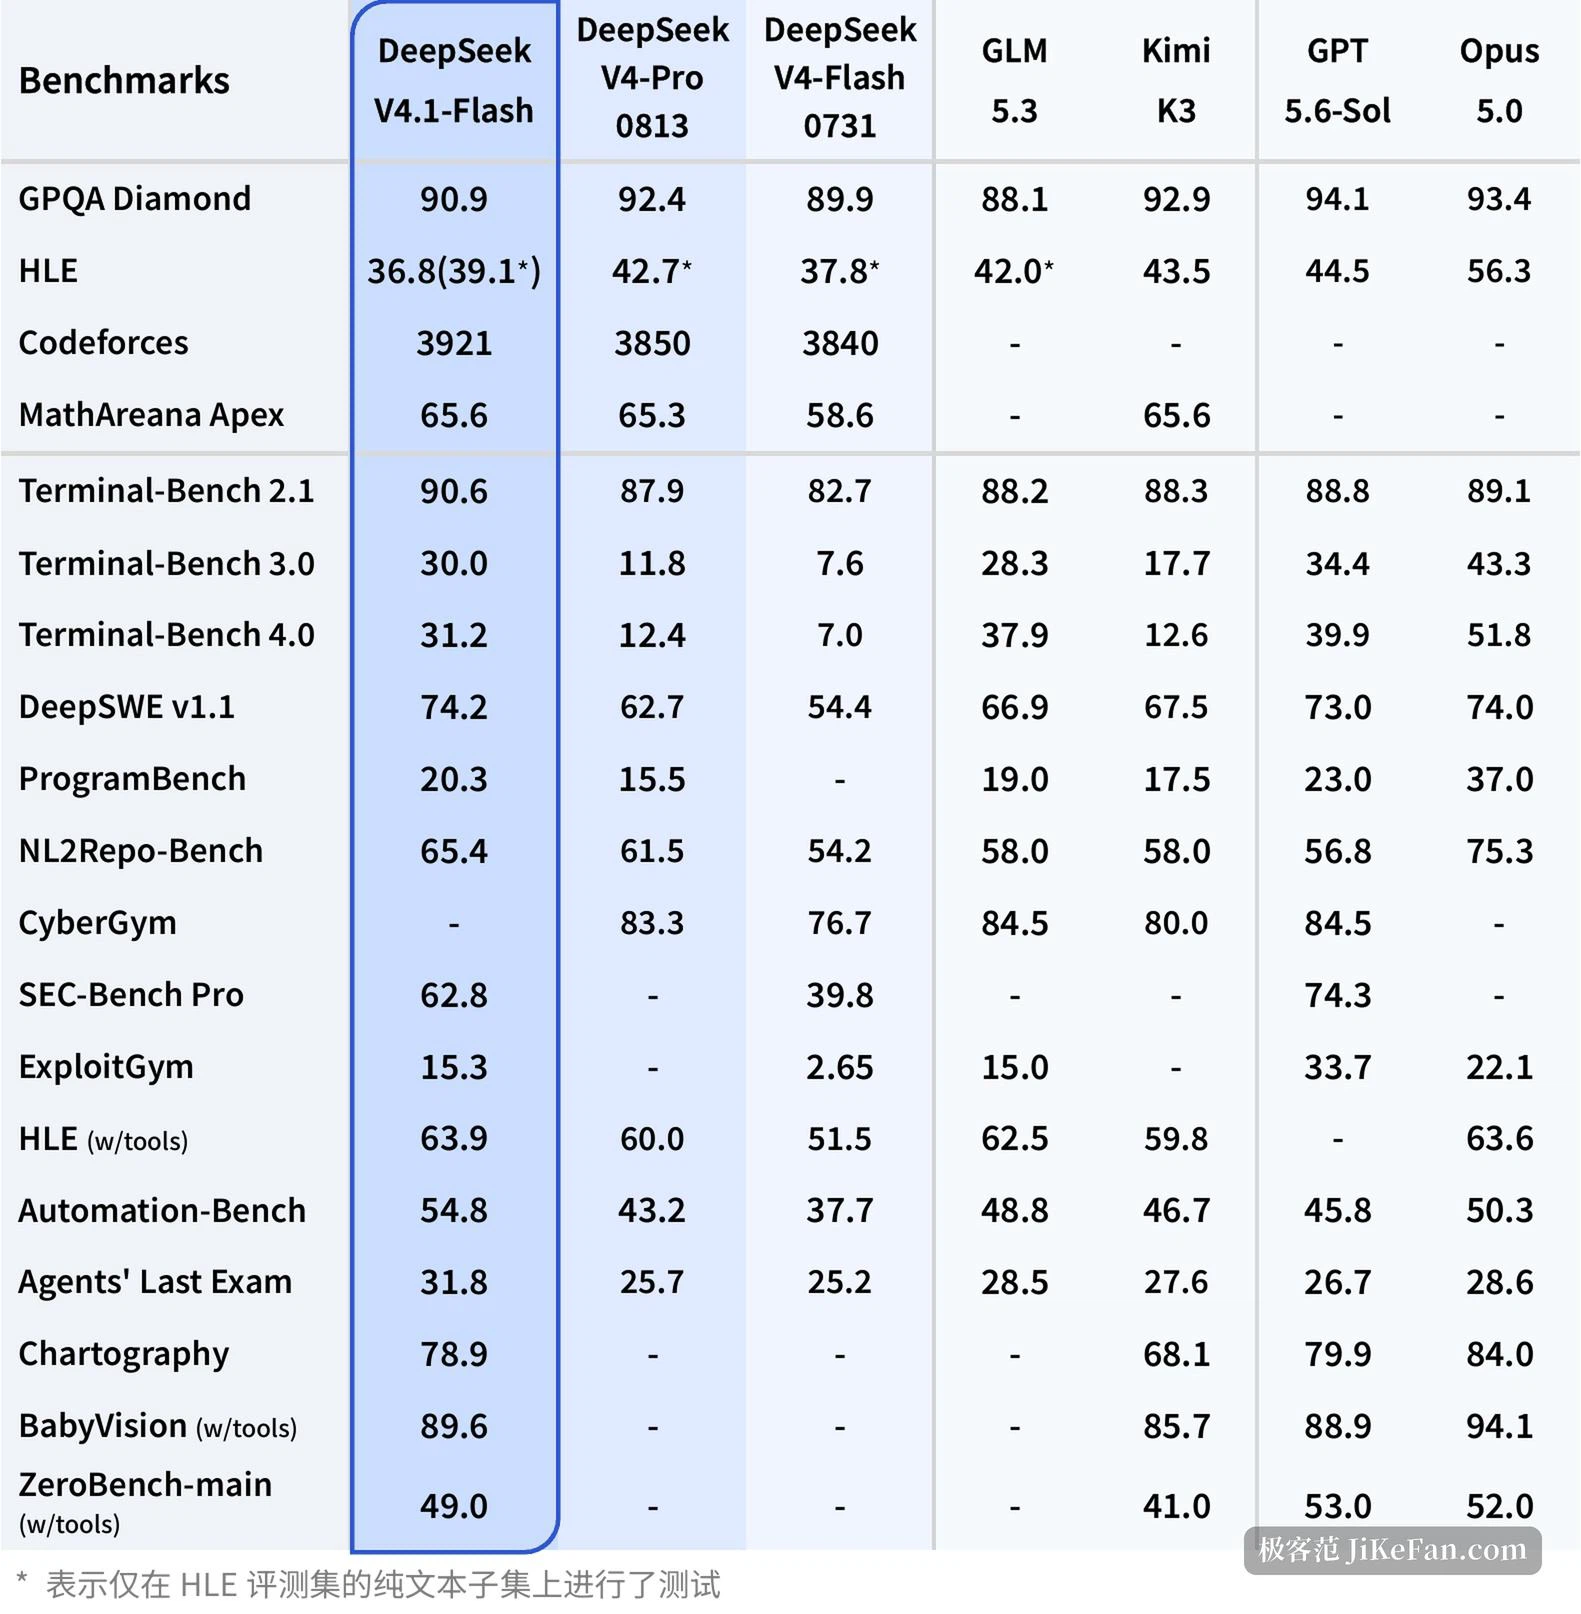
Les mesures publiées avec le modèle penchent vers les agents et la programmation : quatre-vingt-dix virgule six sur une épreuve en terminal, soixante-quatorze virgule deux sur une épreuve d'ingénierie logicielle, quatre-vingt-dix virgule neuf sur des questions de niveau master, et une note en programmation compétitive de trois mille quatre cent soixante et onze. Ce sont les chiffres de l'éditeur, pas une évaluation indépendante, et le même tableau contient plusieurs matières où le modèle est nettement derrière. À lire en le sachant.
Où la grille tarifaire a réellement bougé
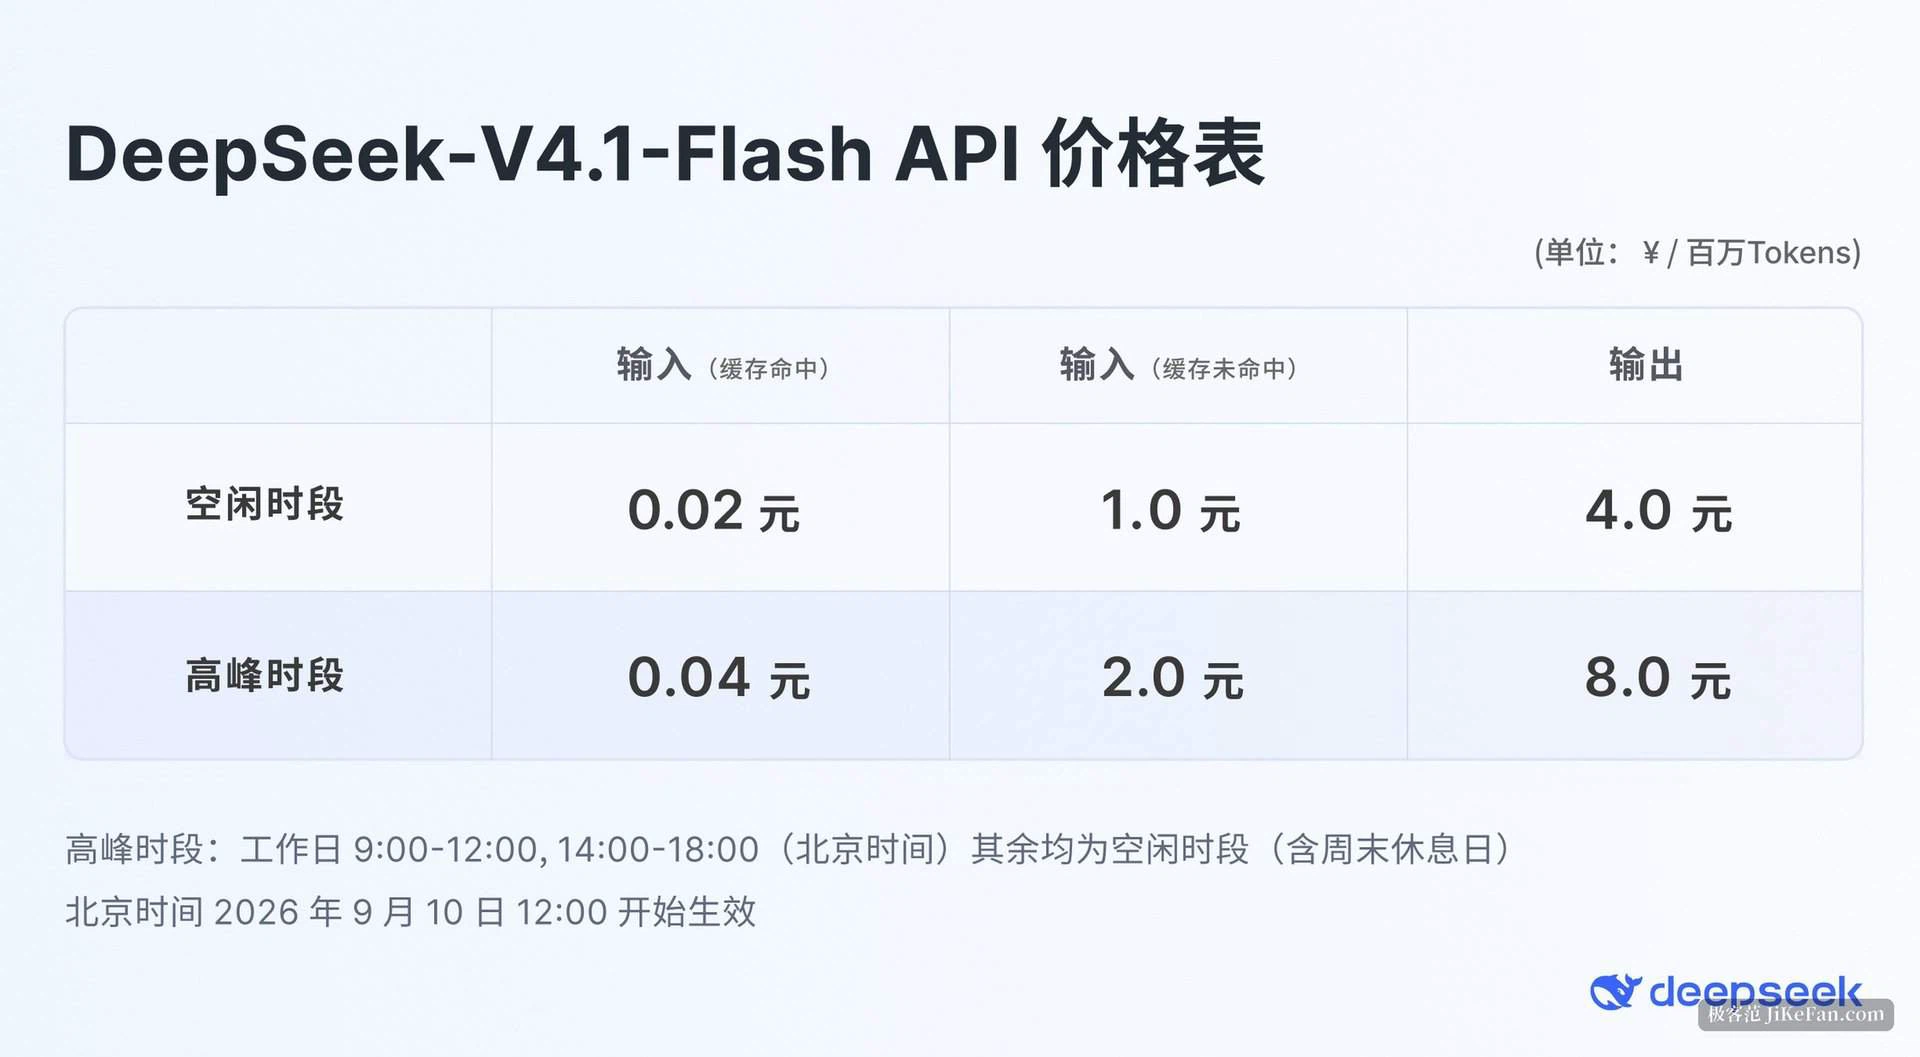
Plus que le modèle, ce sont les changements côté interface qui se voient sur une facture. Deux paliers demeurent, heures creuses et heures de pointe, séparés d'un facteur deux. En heures creuses, l'entrée en cache tombe au cinquantième de yuan par million de jetons, ce que l'éditeur donne comme environ soixante pour cent sous le niveau d'août. L'entrée sans cache coûte un yuan, la sortie quatre ; en pointe, les trois doublent, au vingt-cinquième de yuan, deux yuans et huit.
Une question de migration est venue avec. Le projet initial réorientait les requêtes adressées à l'ancien modèle vers le nouveau dès midi le 14 septembre, facturées aux nouveaux tarifs. Des développeurs ont soulevé des soucis de compatibilité, et le projet a changé : l'ancien point d'entrée reste, sa tarification inchangée, et rien n'est basculé de force. Pour qui fait tourner un service en production, ce résultat comptait plus que la remise.
Un haut-parleur apparaît dans l'application mobile
Deux jours après le modèle, le 12 septembre, une entrée vocale est arrivée dans l'application. Les utilisateurs concernés par le déploiement voient un petit haut-parleur en haut à droite de la conversation, appuient et parlent simplement, la réponse revenant en voix. Le test se fait encore par étapes, tout le monde n'a pas le bouton.
Quatre voix sont disponibles dans les réglages, chacune avec son caractère, du plus enjoué au plus grave et plein. Avec la voix, l'assistant sert quand les mains et les yeux sont pris : au volant, en cuisinant, pendant le trajet, situations où taper n'a jamais été réaliste.
En mettant la chronologie bout à bout, la direction est claire. Un nouveau modèle le dix, capacité et prix dans le même mouvement ; la voix le douze, le seuil d'entrée abaissé encore. Les deux pointent au même endroit : sortir un grand modèle de la boîte à outils des développeurs et le poser dans des journées ordinaires.
L'intérêt n'est pas un nom de modèle de plus. Lire et écrire sont désormais facturés séparément, le cache derrière le contexte long est réduit à une fraction, et les poids sortent sous licence ouverte. Les trois ensemble font baisser encore le plancher de coût pour traiter le travail courant avec l'IA. Pour les développeurs et les utilisateurs intensifs, c'est la partie la plus solide de cette vague.