
通義萬相 Wan 從 8.19GB 顯存的模型一路走到 27B 雙專家 MoE
摘要
兩個約 14B 的專家加起來 27B,每一步卻只點亮其中一個,成本因此貼近單專家模型。另有一條 5B 分支把 720P 24fps 塞進一張消費級顯卡,真正讓出空間的是 VAE 的壓縮比。
推薦- 軟體名稱
- 通義萬相 Wan
- 版本
- 20260916
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsmacOSLinux
- 更新時間
- 2026-10-06 17:14
通義萬相(Wan)是阿里雲的開源影片生成模型線,權重與推理程式以 Apache-2.0 授權公開。這條線從 2025 年 2 月的 Wan2.1 起步,到 Wan2.2 引入 MoE 架構把總參數推到 27B,再分出音訊驅動、角色動畫、音樂舞蹈幾個專項模型,同時保留一條能在消費級顯卡上跑的輕量分支。
Wan2.2:把 MoE 搬進影片擴散模型
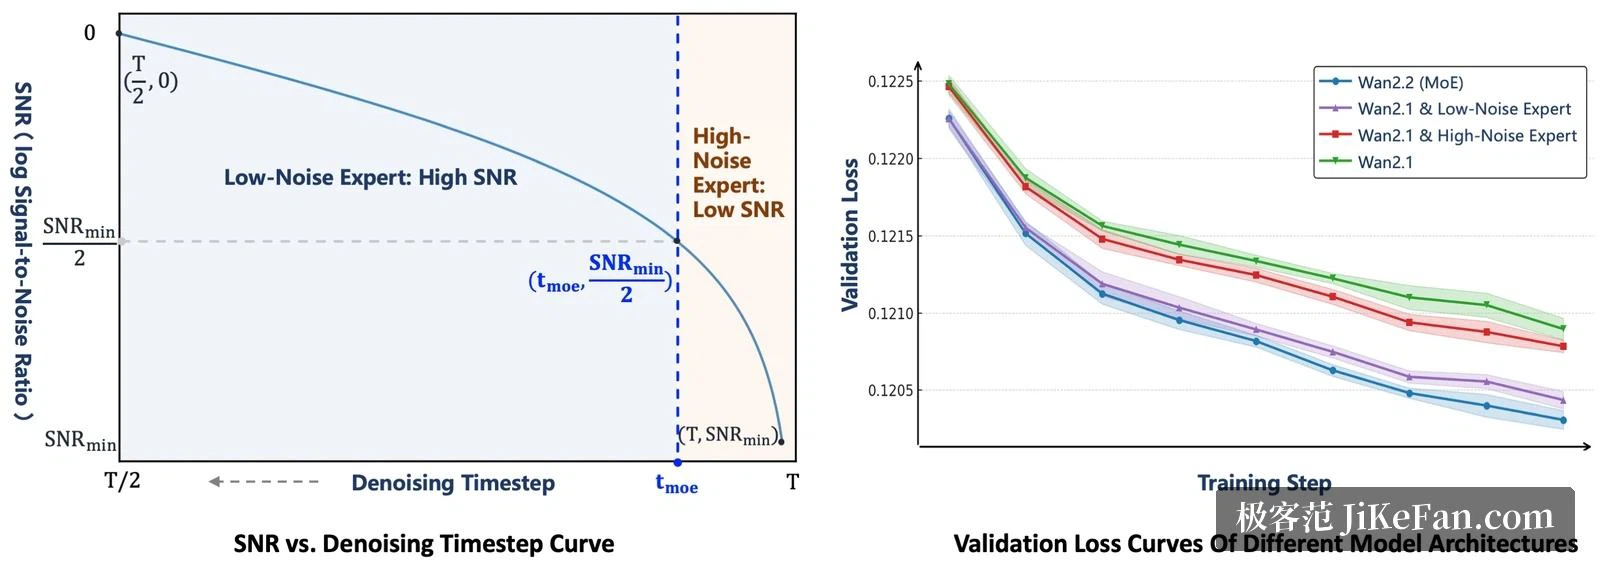
技術報告把核心創新寫在第一段:把混合專家架構引入影片生成擴散模型。A14B 系列採雙專家設計——高噪聲專家負責去噪早期、關注整體佈局,低噪聲專家負責後期、細化細節;兩個專家各約 14B 參數,合計約 27B,但每一步只激活約 14B,因此推理計算量與顯存佔用與單專家模型基本持平。切換點由信噪比決定:去噪剛開始時噪聲高、信噪比處於低點,此時激活高噪聲專家,閾值步長取在信噪比低值的一半處。
架構之外,訓練資料也是這一代的變數:官方寫明相比 Wan2.1,Wan2.2 增加了 65.6% 的圖像與 83.2% 的影片,用來提升模型在運動、語意與美學等維度的泛化。另外,美學資料單獨標注了光照、構圖、對比度、色調等維度,讓電影感的生成風格變得可指定。
5B 的 TI2V:720P 24fps 與消費級顯卡
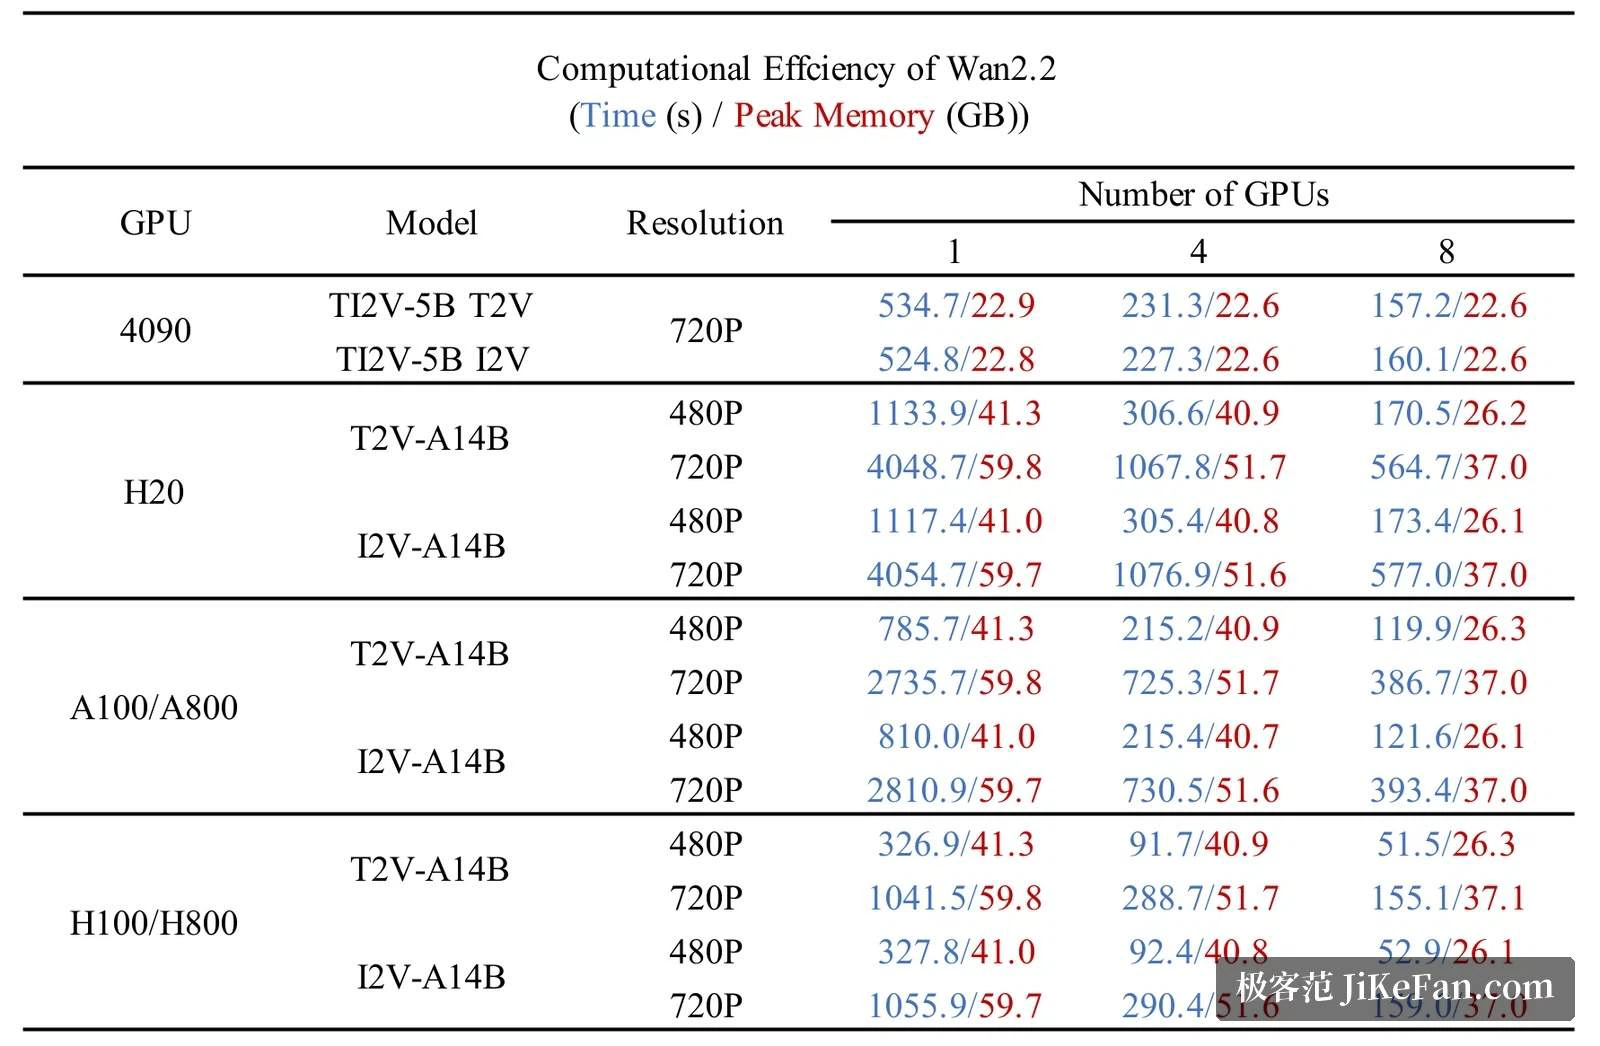
TI2V-5B 是對個人開發者更友善的分支。它把文生影片與圖生影片合進同一個模型,支援 720P 解析度下的 24fps 輸出,並且可以在 4090 這類消費級顯卡上運行。官方給的效率數據可以直接換算成本:在單張 4090 上,一段 720P 的文生影片耗時約 534.7 秒、峰值顯存約 22.9 GB;圖生影片約 524.8 秒、峰值顯存約 22.8 GB。把推理擴到 8 張卡,兩項任務分別降到約 157.2 秒與 160.1 秒。
壓縮 VAE:16×16×4 換來的顯存空間
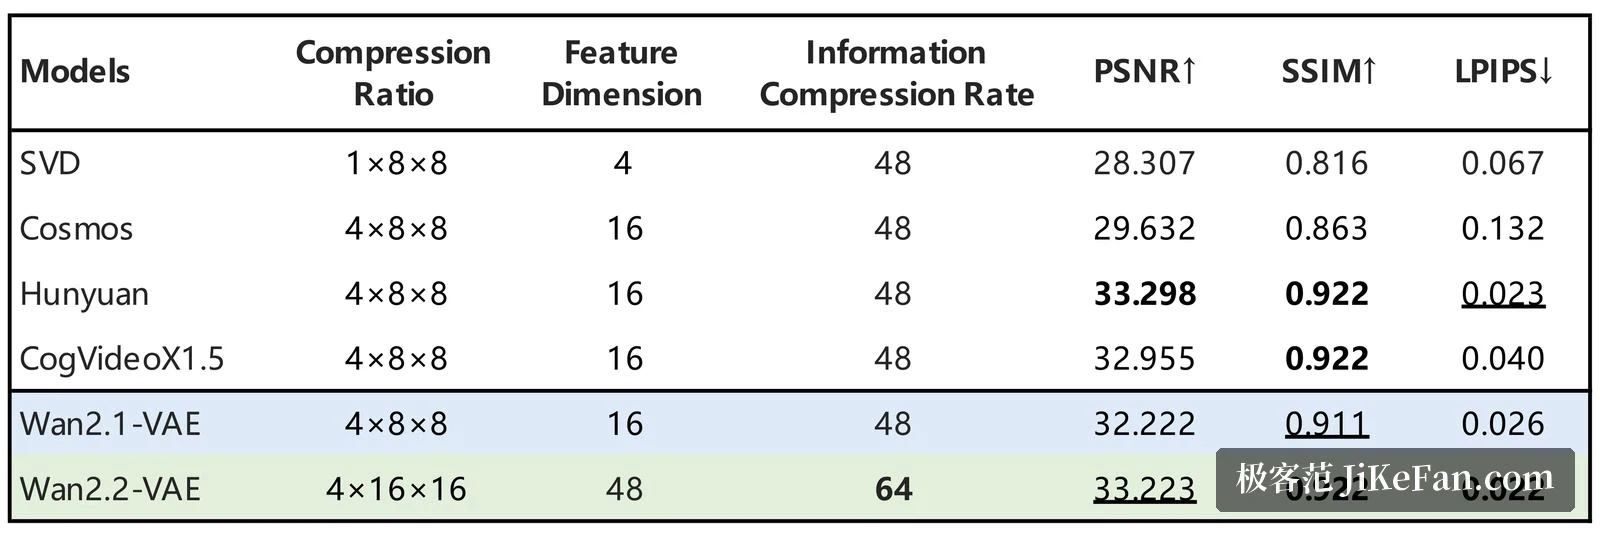
5B 模型能塞進消費級顯卡,關鍵之一是影片 VAE 的壓縮比。Wan2.2-VAE 做到 16×16×4,在時間與空間維度上給出更高的壓縮倍數;官方對比表裡,Wan2.1-VAE 與部分同類方案是 4×8×8。在資訊壓縮倍數為 64 的同時,Wan2.2-VAE 把重建指標 PSNR 從 32.222 抬到 33.221,SSIM 與 LPIPS 也同步小幅改善。壓縮比更高、重建品質不降,才是同一張顯卡能跑更高解析度的直接原因。
效率表:不同 GPU 上的耗時與顯存
官方倉庫附了一張跨硬體的效率表,格式是「總耗時(秒)/峰值顯存(GB)」。除 4090 的數據外,還能看到 A14B 檔位在 H20 上的表現:單卡跑 720P 文生影片約 4048.7 秒、峰值顯存約 59.8 GB,擴到 4 卡後降到約 1067.8 秒、峰值顯存約 51.7 GB。倉庫同時提示,A14B 的單卡命令需要至少 80GB 顯存的 GPU;顯存不夠時可以打開模型卸載與參數型別轉換,用速度換容量。
三條專項模型線
Wan2.2 之後,這條開源線分出幾個針對性很強的方向。2025 年 8 月 26 日發布的 Wan2.2-S2V-14B 是音訊驅動的影片生成模型,官方同步給出推理程式、權重與技術報告,支援 480P 與 720P 兩檔解析度;2025 年 9 月 19 日發布的 Wan2.2-Animate-14B 面向角色動畫與角色替換,官方提供權重與推理程式,並在 2025 年 11 月 13 日被整合進 Diffusers,此前也已提供 ComfyUI 整合。
2026 年 8 月 7 日發布的 Wan-Animate-2 把這條路走得更遠:它採端到端的角色動畫框架,直接把驅動影片送進重新設計的 Diffusion Transformer,省掉中間的動作提取器,因此在動作保真度與身份保持上更有針對性;另一個新增能力是文字驅動的視角控制,可以把輸出的相機視角與驅動影片解耦。官方還給出 Wan-Animate-2-Lite 這一輕量變體,把推理延遲壓到即時門檻,面向串流角色動畫。
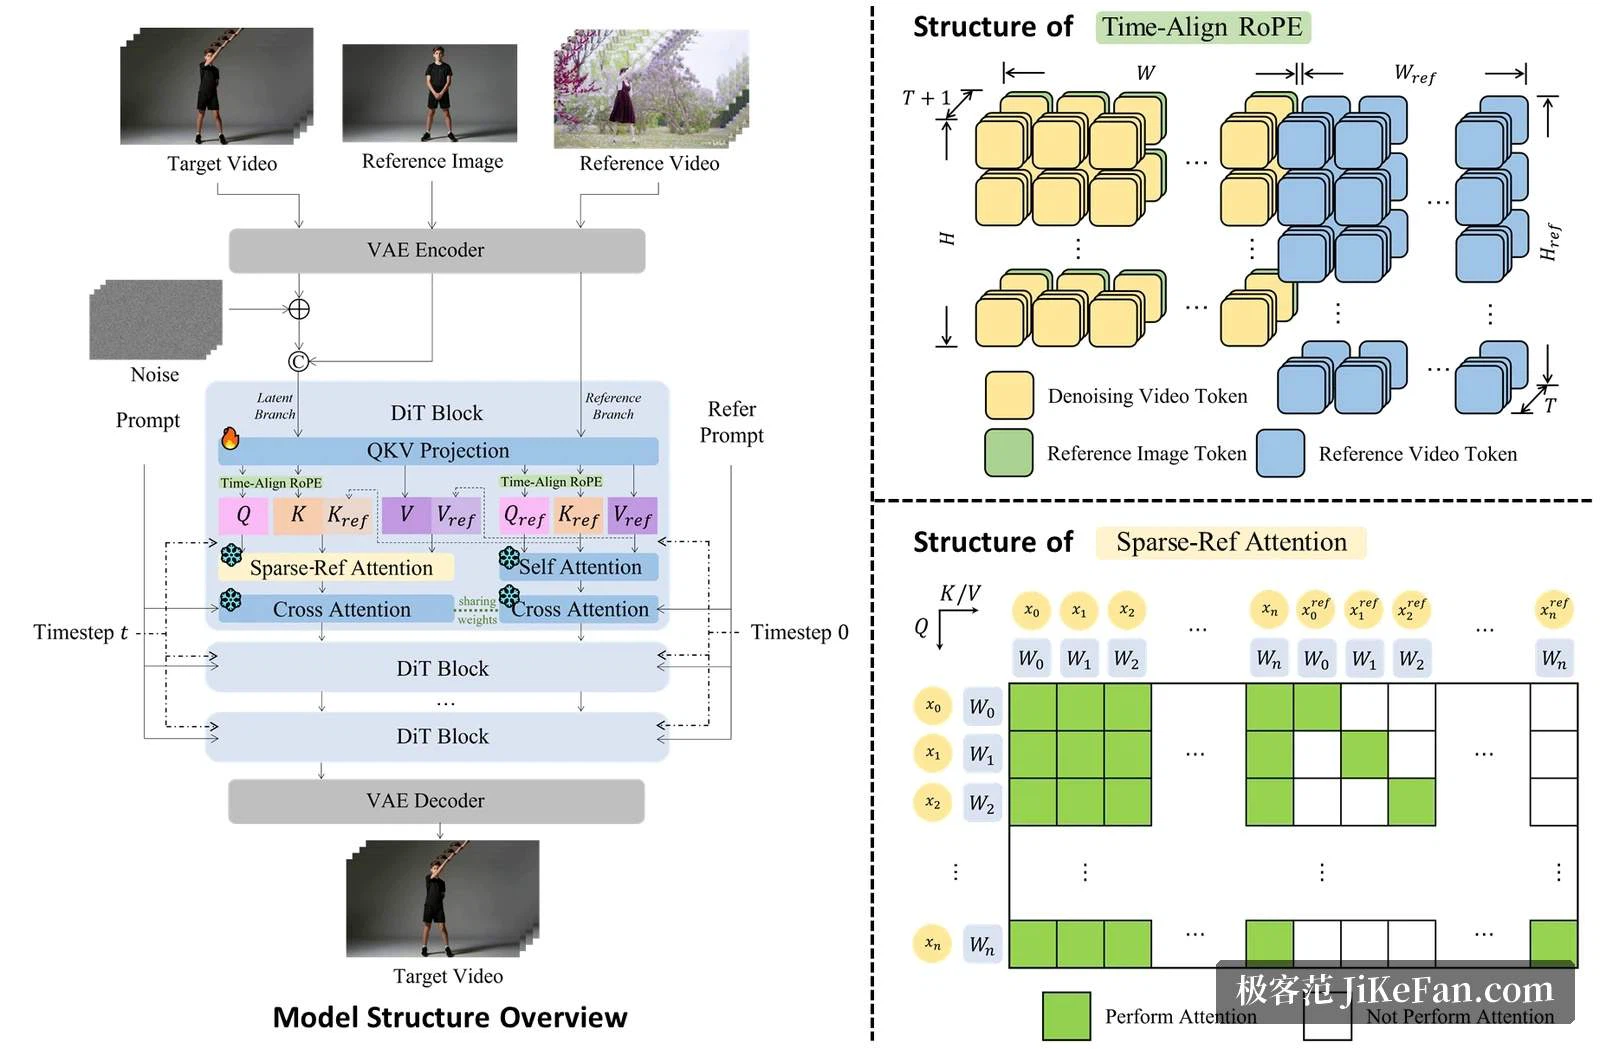
音樂到舞蹈則單獨開源成 Wan-Dancer。官方寫明這套框架可以生成時長超過一分鐘的 720p 30fps 舞蹈影片,覆蓋古典、街舞、拉丁等五種舞種;做法是把生成拆成全域關鍵幀規劃與局部時序細化兩步,再用時間映射的位置編碼與光流損失維持長時序的穩定性。倉庫標注的測試環境是 8 張 A800 80GB 顯卡,屬於這幾個專項模型裡門檻較高的一個。
回溯 Wan2.1:8.19GB 顯存與中英文字渲染
Wan2.1 是這條線的起點,也是理解輕量分支的參照。官方寫明 T2V-1.3B 版本只需要 8.19 GB 顯存,幾乎可以在全部消費級顯卡上運行;在 RTX 4090 上大約 4 分鐘能生成一段 5 秒 480P 影片,而且沒有使用量化等最佳化手段。模型檔位方面,Wan2.1 提供 T2V-14B(480P 與 720P)、I2V-14B 的 480P 與 720P 兩個版本、T2V-1.3B(480P)、FLF2V-14B(720P)以及 VACE 的 1.3B 與 14B 兩檔。
能力覆蓋上,Wan2.1 除文生影片與圖生影片外還包含影片編輯、文生圖與影片轉音訊;官方把「能同時生成中英文文字的影片模型」列為賣點之一,並說明 Wan-VAE 可以對任意長度的 1080P 影片做編解碼、同時保留時間資訊。這兩點決定了它後續能被大量二次開發專案直接拿來當底座。
授權、權重與整合路徑
組織頁寫明,Wan 名下 6 個公開倉庫全部採用 Apache-2.0 授權,包括 Wan2.2、Wan2.1、Wan-Dancer、Wan-Animate-2、Wan-skills 與一個 Diffusers 分支;其中 Wan2.2 的星標數約 17.5k,Wan2.1 約 17k。權重同時發布在 Hugging Face 與 ModelScope 兩個渠道。對團隊來說,授權與權重渠道決定了它能不能進內部流程,這兩項在倉庫首頁都能直接確認。
社群生態
圍繞這條線的第三方專案已經形成規模。官方說明收錄的包括輕量推理框架,其中一個能在當代旗艦顯卡上跑、另一個能在 8GB 的 4060 上跑;一個提供逐層卸載、FP8 量化、序列並行與 LoRA 訓練的最佳化工具;稀疏注意力與快取加速方案;一個 ComfyUI 封裝;以及一批提示詞接力與長影片類工作。另有一個 Wan-skills 倉庫,把模型能力包裝成可被智能體呼叫的技能。
幾條邊界
其一,文中耗時與顯存數字全部來自官方倉庫的效率表,測試條件包含特定的並行策略與注意力實作,自己的機器上會有差異。其二,A14B 單卡需要 80GB 以上顯存才能按倉庫預設命令運行,5B 分支才是消費級顯卡的現實選擇。其三,專項模型的硬體門檻差別很大,Wan-Dancer 標注的測試環境是 8 張 A800。其四,授權與商用條款請以倉庫內的授權檔案為準,涉及人物形象與肖像素材時還要確認素材本身的授權。
一句話收尾:這條開源線的價值不在單一模型的分數,而在於它把同一套架構鋪成一條梯度清晰的產品線——1.3B 讓 8GB 顯存的機器也能出片,5B 用高壓縮比 VAE 把 720P 24fps 做到單張 4090 可跑,A14B 用雙專家 MoE 把總參數推到 27B 而單步成本不變,再往上用三個專項模型分別解決聲音、角色與長時序舞蹈。