
權重與程式碼都在自己手上:CogVideoX 的開源授權與各型號規格
摘要
CogVideoX 是清影背後模型的開源版本。五個型號從 720×480 到 1360×768,顯示記憶體從 18GB 一路壓到 3.6GB,2B 權重與程式碼同為 Apache 2.0,5B 另有自己的授權。
推薦- 軟體名稱
- CogVideoX
- 版本
- 2
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 18:37
用過智譜清影的人,未必知道它背後的模型是開源的。CogVideoX 的官方倉庫在模型介紹裡寫得很直接:CogVideoX 是源自清影(QingYing)的影片生成模型的開源版本。換句話說,網頁端排隊等待生成的那種能力,有一份可以拿到本機自己跑的對應版本。
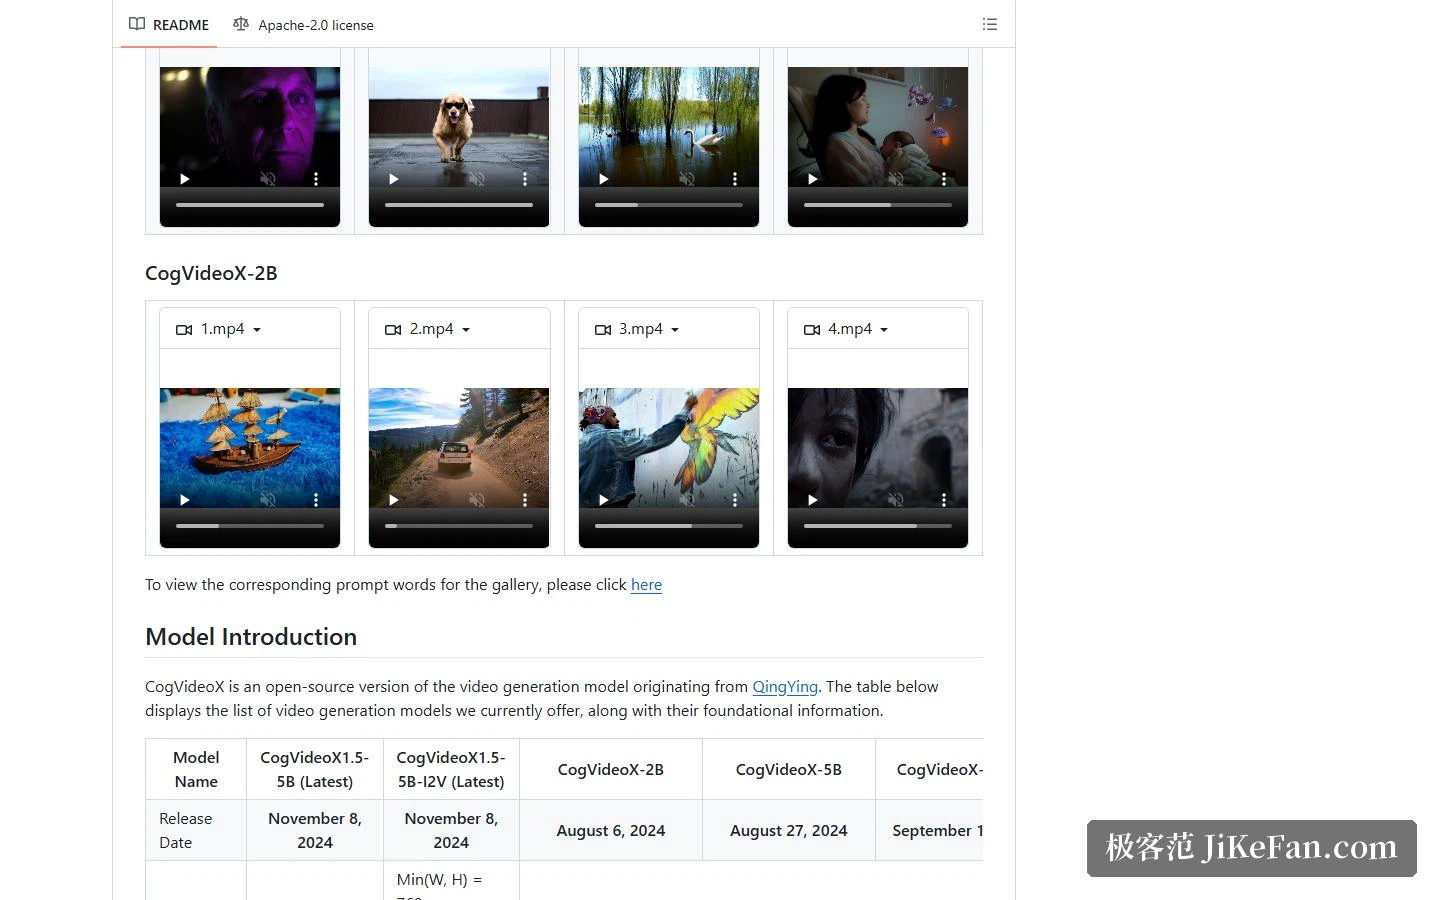
不過兩者並不等同。官方在頁面頂端就把關係說清楚了:想體驗更大規模的商業影片生成模型,可以前往清影與 API 平台;而這個倉庫提供的,是對應的開源版本。商業版面向線上大規模生成,開源版把權重和程式碼交到你自己手裡。
五個型號,規格差異不小
官方在模型表裡列出了目前提供的全部型號:CogVideoX1.5-5B、CogVideoX1.5-5B-I2V、CogVideoX-2B、CogVideoX-5B、CogVideoX-5B-I2V。名稱裡的 I2V 指圖生影片,其餘為文生影片。發布節奏也能看出這條線的演進:2024 年 8 月 6 日放出 CogVideoX-2B,8 月 27 日補上 5B,9 月 19 日開源圖生影片模型 5B-I2V,11 月 8 日更新到 1.5 版本。
規格把檔次分得很清楚。CogVideoX-2B 輸出 720×480、8 fps、6 秒。CogVideoX1.5-5B 做到 1360×768、16 fps,時長可選 5 秒或 10 秒。CogVideoX1.5-5B-I2V 的解析度規則更靈活:短邊取寬高裡的較小值等於 768,長邊在 768 到 1360 之間且能被 16 整除,這個範圍內都可用。從 720×480 到 1360×768,再到圖生影片的彈性比例,這一系統把常見的輸出規格基本覆蓋了。
顯示記憶體與速度:能不能跑在你的機器上
官方在資料說明裡給了三組顯示記憶體數字,都以 CogVideoX-2B 為例:用 SAT 搭配 FP16 推理時佔用 18GB;換到 diffusers 下 FP16 最低 4GB;再用 INT8 量化(torchao)能壓到最低 3.6GB。同一份說明裡也提醒,INT8 是為了適配顯示記憶體更小的顯示卡而降低推理速度,並非沒有代價。
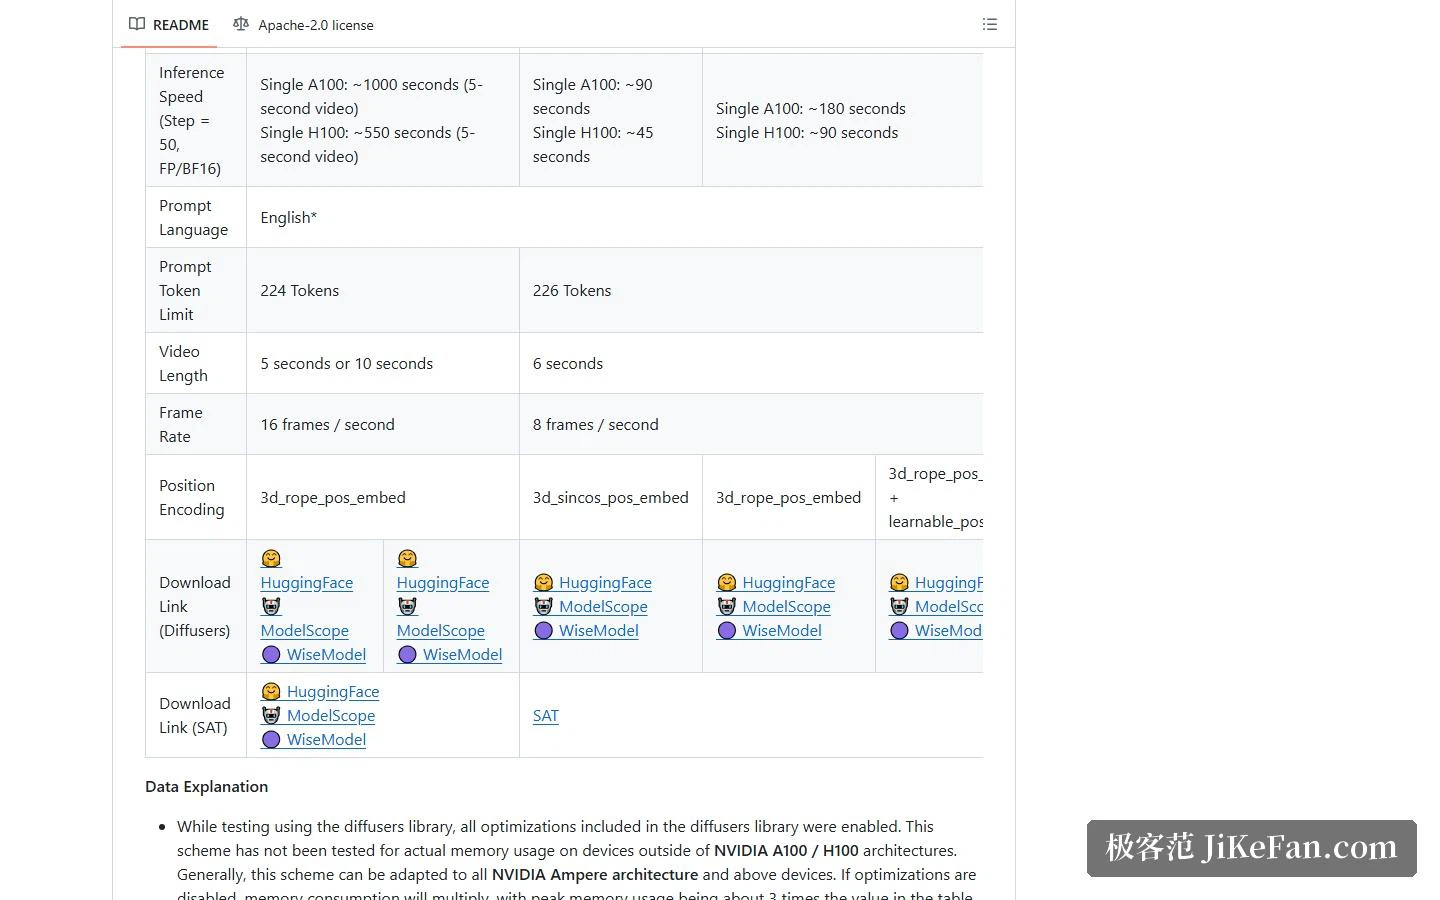
速度方面,官方給出的實測條件是步數 50、FP16/BF16 精度。CogVideoX-5B 在單張 A100 上約需 180 秒,在單張 H100 上約需 90 秒。更新的 CogVideoX1.5-5B 因為要出 5 秒或 10 秒的高解析度影片,同樣條件下 5 秒影片在 H100 上約需 550 秒——能力更強,代價是等待時間明顯拉長。官方也說明,這組測試開啟了 diffusers 函式庫中的全部優化,並未在 A100 與 H100 之外的裝置上驗證真實顯示記憶體佔用,如果優化被關閉,峰值會是表內數值的三倍左右。
動手前要確認的兩件事
第一是 Python 版本。官方在 SAT 與 diffusers 兩條推理路徑下都寫明了同一條要求:Python 版本需要在 3.10 到 3.12 之間,含 3.10 與 3.12 本身。倉庫同時提供兩套程式碼,其中 SAT 包含 SAT 權重的推理與微調程式碼,diffusers 那套對常用參數的說明更詳細,適合先跑通再改動。
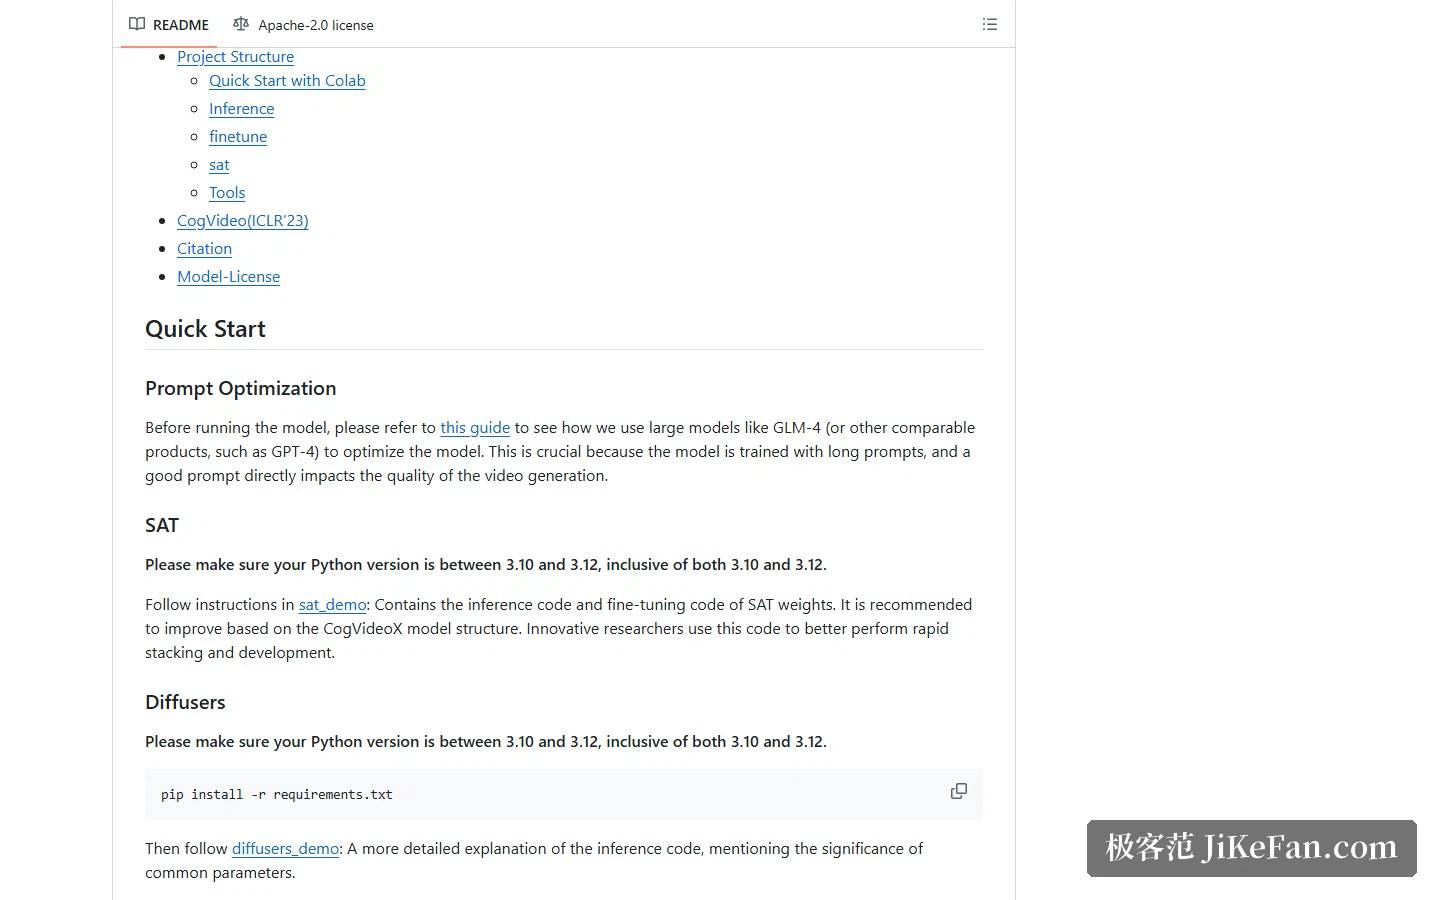
第二是提示詞語言。這套模型只接受英文輸入,其他語言需要先翻譯成英文。官方在提示詞優化一節建議用 GLM-4 或同類大模型把輸入潤色成模型適用的長文本——模型是用長提示詞訓練的,提示詞品質會直接影響生成效果。倉庫標出的提示詞長度上限是 224 到 226 個 token。
許可證:程式碼和模型要分開看
倉庫的程式碼以 Apache 2.0 許可證發布,這一點沒有歧義。模型則要分型號看:CogVideoX-2B(含對應的 Transformer 與 VAE 模組)同為 Apache 2.0;CogVideoX-5B(Transformer 模組,含 I2V 與 T2V)使用單獨的 CogVideoX LICENSE。如果你的場景對許可寬鬆度有要求,2B 這一檔的邊界更清楚;打算用 5B 之前,建議先把那份 LICENSE 讀完。
倉庫裡有什麼
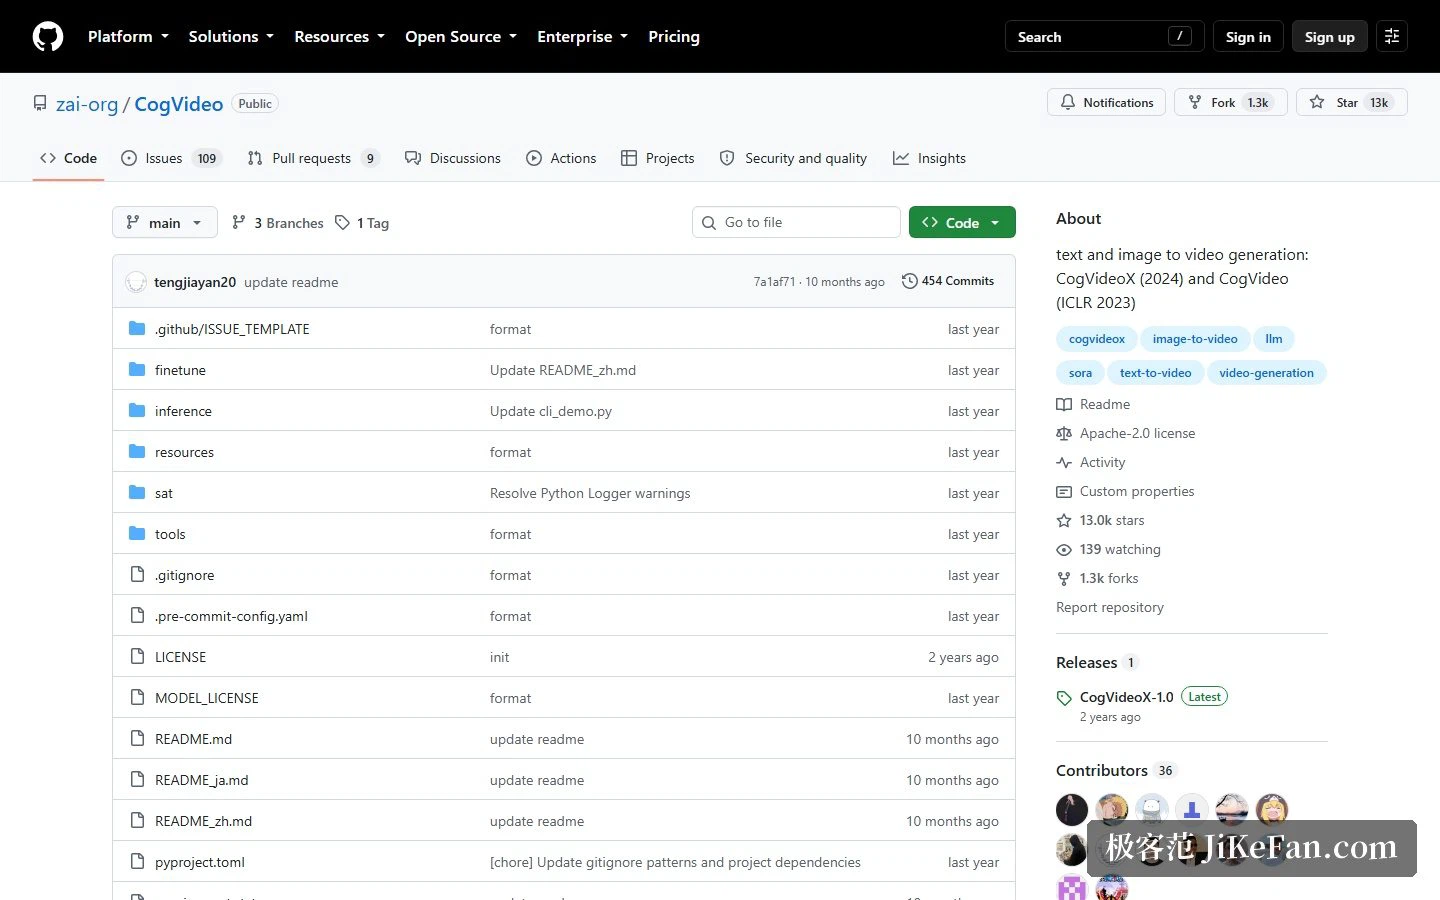
根目錄結構很直白:sat 與 inference 是兩套推理程式碼,finetune 放微調,resources 存素材,tools 是工具腳本;許可分成兩個檔案,LICENSE 覆蓋程式碼,MODEL_LICENSE 單獨說明模型。倉庫目前有 13k 顆星與 1.3k 次 fork,官方登記的版本號為 CogVideoX-1.0。
近一年的更新
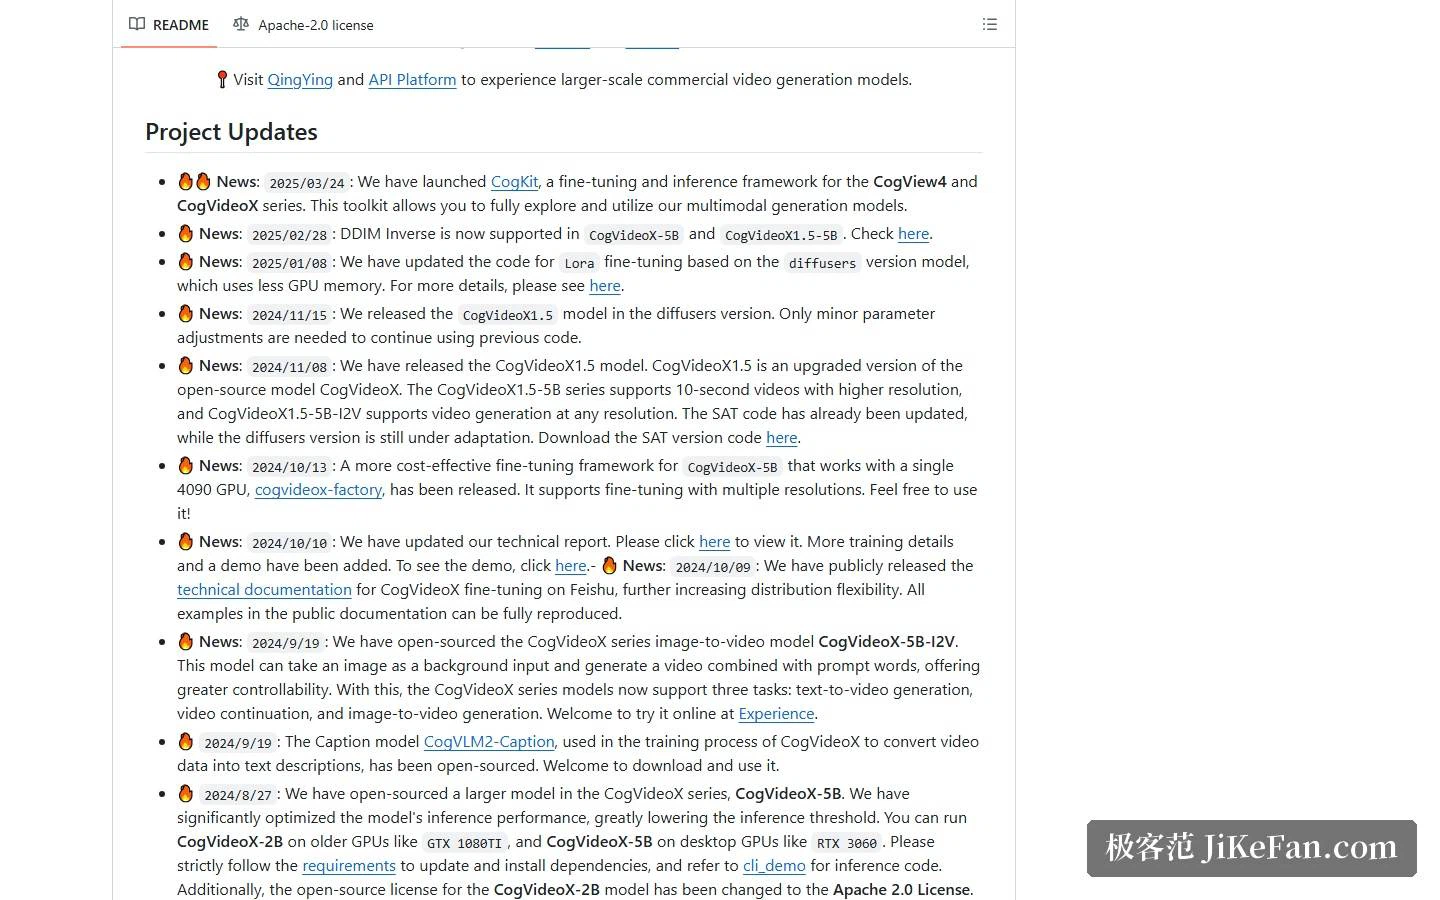
更新日誌也能說明這條線的活躍程度。2025 年 3 月推出 CogKit,一套面向 CogView4 與 CogVideoX 系列的微調與推理框架;2 月為 CogVideoX-5B 與 CogVideoX1.5-5B 補上了 DDIM Inverse 支援;1 月更新了基於 diffusers 的 LoRA 微調程式碼。再往前,2024 年 10 月放出的微調框架讓 CogVideoX-5B 的微調可以跑在單張 4090 上,官方同時提到 CogVideoX-2B 能在 GTX 1080Ti 這類更早的顯示卡上運行,5B 則對應 RTX 3060 這一檔桌上型顯示卡。
它適合誰
如果你想把影片生成接進自己的工作流,又不希望受線上服務的排隊、額度和內容策略牽制,CogVideoX 提供了一條可控的本機路徑:權重開放、程式碼開放,記憶體門檻能壓到 3.6GB 這一檔。它更適合有顯示卡、也願意折騰環境的人——Python 版本、依賴、量化精度、提示詞語言,每一步都得自己確認清楚。
反過來說,如果你只是偶爾生成一段影片,或者不想處理環境和依賴,直接用線上服務更省事。本機部署省下的是各種限制,付出的是時間和一張夠用的顯示卡。
還有一點值得提前知道:這套模型只吃英文提示詞。中文使用者想用得順手,得先解決「把想法翻譯成模型能理解的長描述」這一步——而這一步的品質,往往比換一個更大的型號影響更明顯。
開源模型的真正價值,不在於複製一項線上服務的全部能力,而在於把生成過程搬回你自己的機器上。先確認顯示卡和環境能不能接受它,再談效果。