
SWE-agent:把一張問題單交出去,它讀完程式、改完檔案、把補丁交回來
摘要
一個研究性質的代理:收下一張問題單,就把整趟修復走完——複製專案、讀描述、翻出相關檔案、動手修改、跑測試,最後交回一份可以直接合併的補丁。它真正的貢獻不是模型,而是為「讀程式、改程式」重新設計的那套介面。
推薦- 軟體名稱
- SWE-agent
- 版本
- 1.1
- 收費
- 付費
- 開源
- 開源
- 作業系統
- LinuxmacOS
- 更新時間
- 2026-10-06 07:31
開源專案和小團隊有著同一種尷尬:待修的問題單越堆越多,能騰出手的人始終就那麼幾個。市面上的編程助手大多停在「幫你把眼前這幾行補完」——打字快一點,但沒有人替你把一個臭蟲從頭跟到尾。這個專案走另一條路:把整件事交出去。
SWE-agent 由兩所大學的研究者打造,並以開源形式釋出。給它一張問題單的位址,它會複製對應的專案、讀描述、在程式庫裡翻找相關位置、想清楚哪裡不對、動手改檔案、跑一遍測試確認沒弄壞別的地方,最後產出一份可以直接當合併請求送出的補丁。整個過程都在隔離環境裡完成,不需要人在旁邊逐項確認。
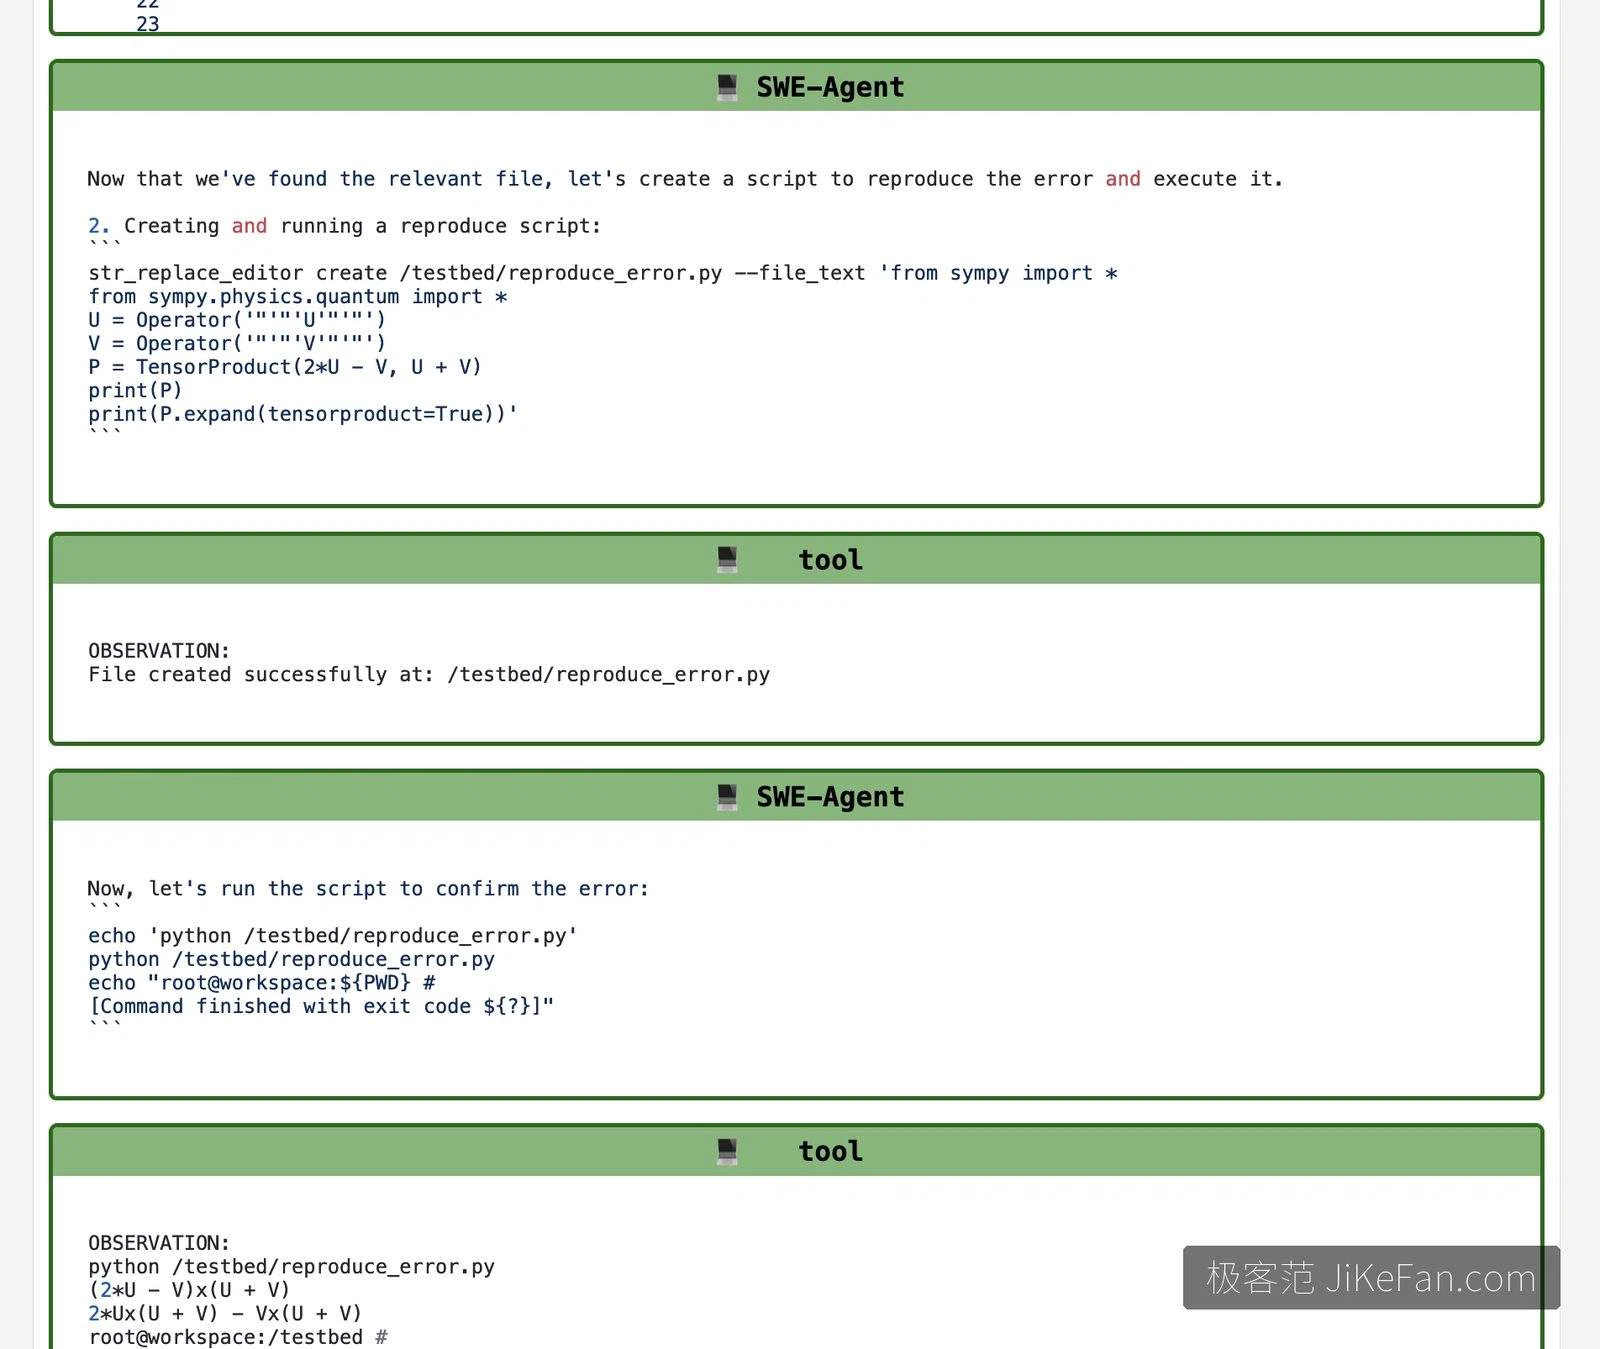
不是補完程式,而是把一次修復走完
這套做法 2024 年第一次亮相。在一個由真實問題單構成的公開評測集上,它解出了一成二多一點的題目,平均一題只要九十三秒。那是第一次有開源方案做出兩位數成績,也讓「模型到底能不能真的修臭蟲」從口頭討論變成可測量的題目。此後隨著模型迭代,後來的一個大版本又多次刷新了開源方案在這類評測上的最好成績。
重點不在模型,而在給它一套合手的工具
讓一個普通的對話模型去翻真實的程式庫,多半會迷路:檔案太多、脈絡塞不下、格式一錯就前功盡棄。隨附論文最核心的貢獻是一套「代理與電腦之間的介面」——不是把裸終端機丟給模型,而是為「讀程式、改程式」這件事重新設計一套指令。
細節做得很具體。檔案檢視器每一輪只顯示大約一百行,正好落在模型讀得準的範圍裡。編輯指令會先跑一次語法檢查,程式不合法就不讓這次修改生效。整個目錄的檢索只列出命中的檔名,不多塞脈絡。指令沒有任何輸出時,也會明確回一句「執行成功但沒有輸出」。看起來都是小事,而正是這些設計讓模型在長任務裡不容易崩掉;論文也驗證過,沒有調校好的介面,同一個模型表現會差一大截。
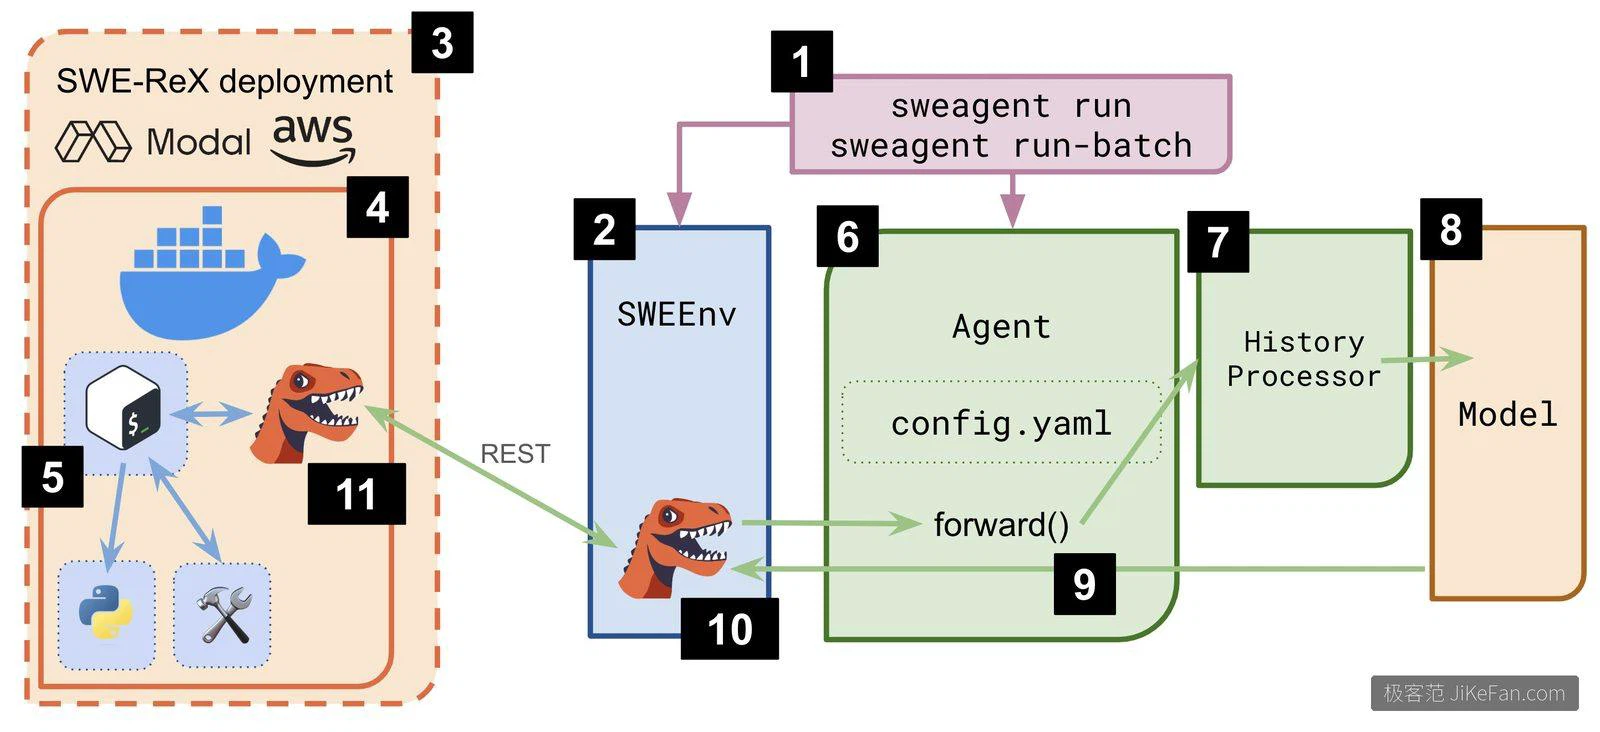
模型隨你換,設定只要一份檔
它不綁定任何一家模型廠商。各家商業模型與跑在本機的開源模型都能接,模型與參數寫在同一份設定檔裡,換模型改一行就行,不必動程式。這讓它特別適合做「同一個任務、不同模型誰更強」的橫向評測。
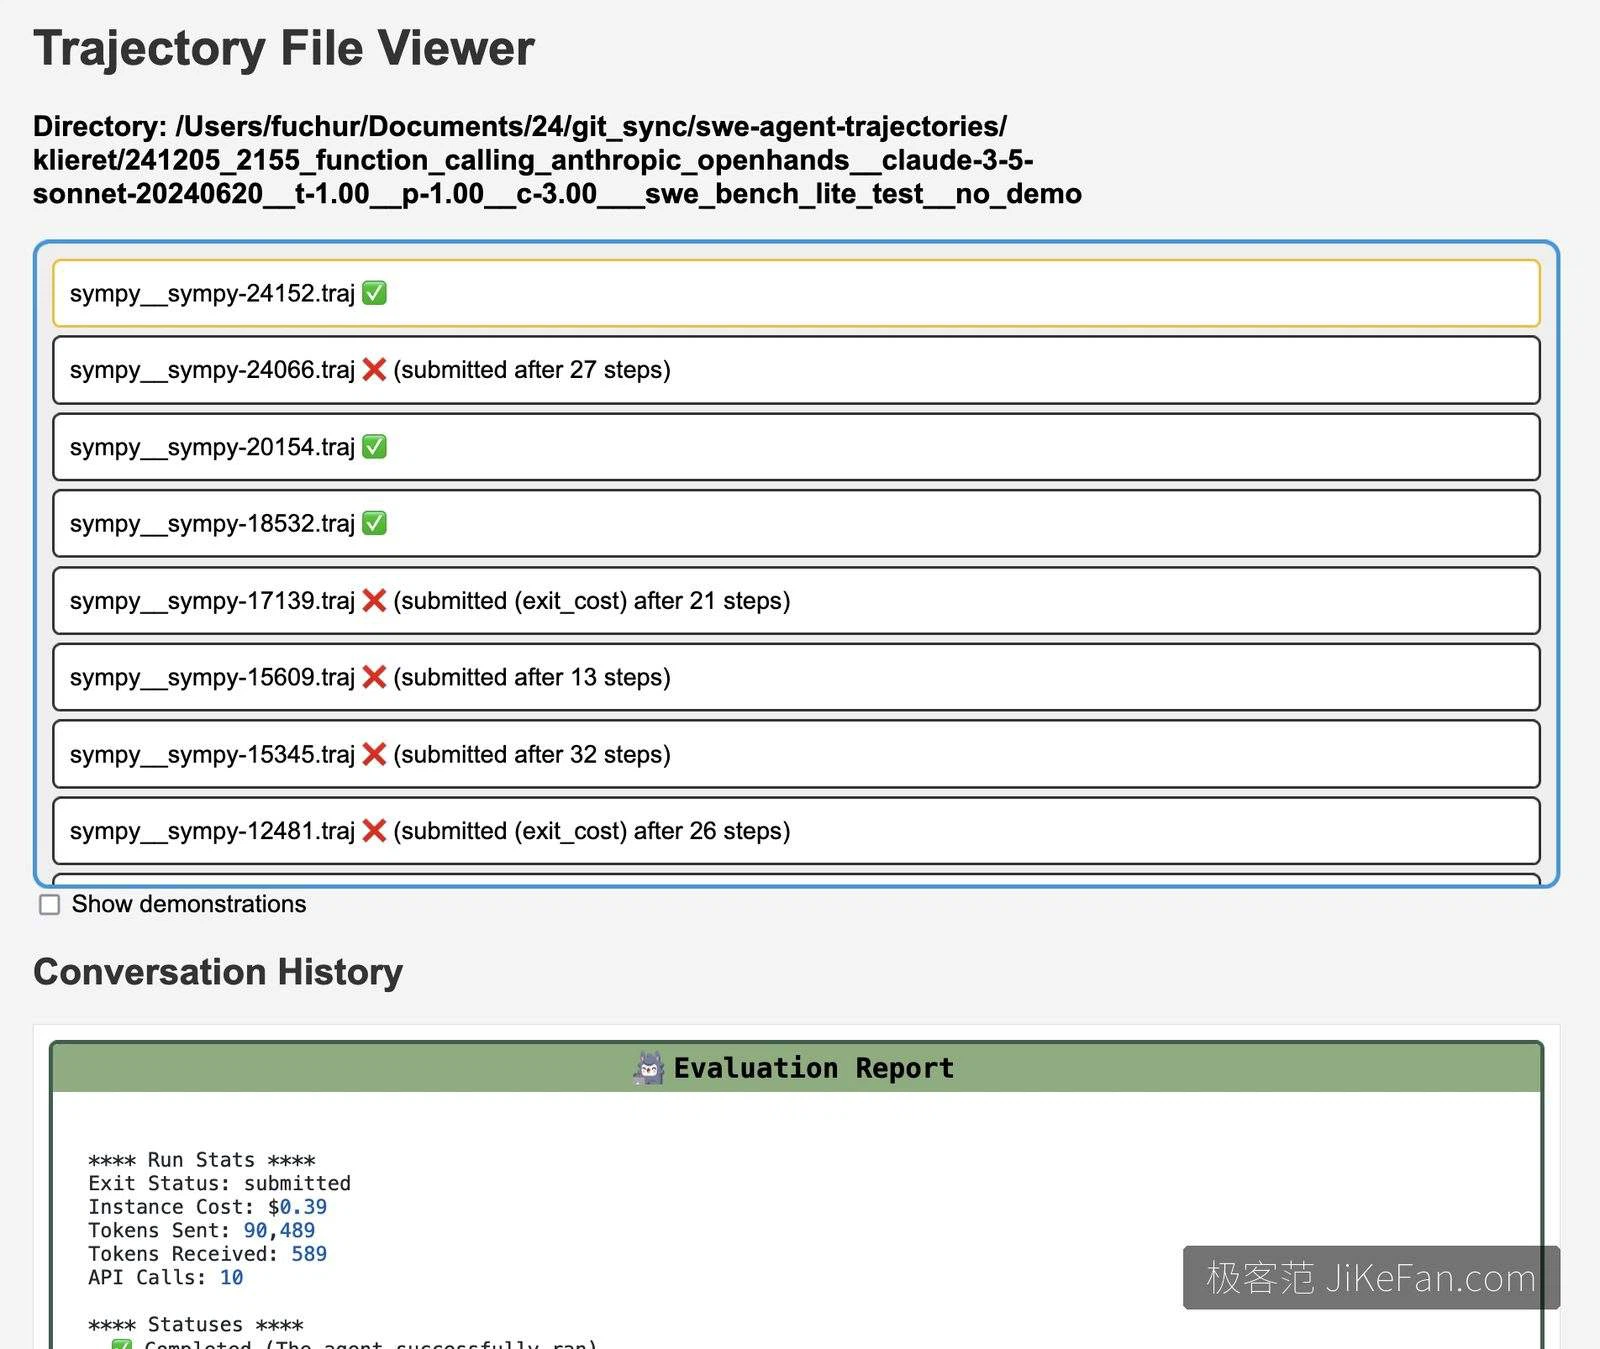
隔離交給容器:每一次執行都在沙箱裡,碰不壞你的機器。要一次處理幾十上百張問題單時,可以開批次平行。跑完之後會留下完整的軌跡——每一步讀了哪個檔案、搜了什麼、改了什麼都能回溯;官方還提供線上檢視器,連每一步花了多少錢、耗掉多少 token 都標得清楚。
修臭蟲只是起點
同一套框架還能做別的。團隊拿它去打網路安全方向的攻防搶旗賽,在相關榜單上拿過領先成績;競技編程題也行,任何能描述成「在一個環境裡連續操作直到完成」的任務,都可以接上去跑。專案全程開源,程式碼可稽核、可修改、可複製重現,這也是它在學術圈被反覆引用的原因。
它現在的位置,說清楚
2025 年七月,同一個團隊釋出了更輕量的迷你版:核心約一百行 Python,去掉所有自訂工具、只留一個最基本的 shell,在驗證集上依然能解出約 65% 的題目。團隊現在的建議是多數新使用者直接從那裡開始;SWE-agent 本身則轉入維護模式,重心不再放在新功能上。
它值得用的場景也跟著清楚了:需要高度可配置的工具鏈、想試驗不同的歷史處理策略,或者想研究「一個好的代理介面該怎麼設計」——功能更完整的它仍然是更合適的那個。它是研究基礎設施,不是包裝好的成品軟體。到 2026 年底,這個開源程式庫已累積兩萬多顆星與兩千多次分支複製,而那套評測集也成了這個方向繞不開的公共標尺。