
-
Notion AI:在笔记里查资料、写稿、记会议,把 AI 接进整个工作区
Notion AI 是内置在 Notion 里的 AI 助手,能查资料、写稿、自动填充数据库,还能把会议录音转成摘要;它随 Business 套餐提供,其他套餐只有有限试用额度。
-
Grammarly:英文语法、语气、抄袭一起查的 AI 写作助手,支持 20 多种语言
Grammarly 是一款 AI 写作助手,能在你写英文邮件、论文与文档时实时纠正语法、拼写与标点,还能调整语气、改写整句,免费版每月可生成 100 次 AI 提示。
-
DeepL:把整份文档连排版一起翻译的 AI 翻译器,免费版每月 5 万字
DeepL 是一款 AI 翻译服务,网页版可以免费使用,每月可翻译 5 万个字符;它还能把整份 Word、PDF、PPT 文档连排版一起翻译,付费订阅后额度更高。
-
沉浸式翻译:免费的双语对照翻译扩展,网页 PDF 视频字幕全覆盖
沉浸式翻译是一款 AI 驱动的双语网页翻译扩展:它把外文网页变成原文与译文上下对照的样式,还支持 PDF 文档、视频字幕与图片翻译,免费即可使用,注册后额度更高。
-
Adobe Podcast Enhance:浏览器里一键降噪增强,免费额度每天 1 小时
Adobe Podcast 的增强语音是一个浏览器里的免费工具:上传录音,它会消除背景噪音、平衡音量并提高清晰度,官方称处理后的声音就像在录音棚里录的一样,且无需安装任何软件。
-
RVC:开源音色转换框架,10 分钟语音数据即可训练,端到端延迟 170 毫秒
RVC 是一个开源的语音音色转换与实时变声框架:官方推荐至少收集 10 分钟低底噪语音数据用于训练,端到端延迟可以做到 170 毫秒,并配有网页界面与实时变声界面,以 MIT 许可证开源。
-
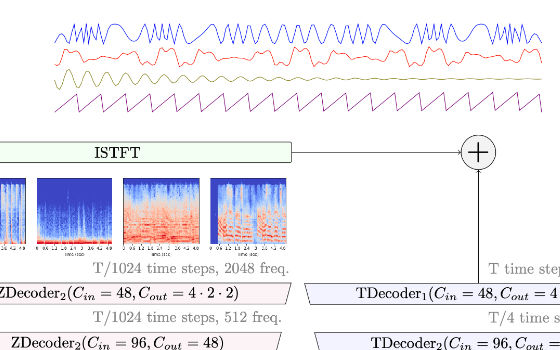
Demucs:开源音源分离模型,命令行一行拆出四条音轨
Demucs 是一个开源的音源分离模型,能把一首歌里的鼓、贝斯与人声分别拆出来;命令行一行即可运行,也能从 Python 直接调用,代码以 MIT 许可证开源。
-
Ultimate Vocal Remover:开源人声分离,干声与伴奏一键提取
UVR 是一个开源的人声分离工具,用先进的音源分离模型把音频拆成人声与伴奏两条音轨;官方安装包已内置界面、Python 与 PyTorch,下载后装上就能用,不需要额外配环境。
-
WhisperX:70 倍实时的开源转写工具,输出词级时间戳与说话人标签
WhisperX 把转写串成流水线:先用 faster-whisper 批量转写,再用 wav2vec2 强制对齐拿到词级时间戳,最后由 pyannote 区分说话人。
-
Buzz:离线转写与翻译音频的桌面工具,由 Whisper 提供支持
Buzz 是一个能在个人电脑上离线转写与翻译音频的桌面工具,由 Whisper 驱动;支持转写音视频文件、麦克风实时转写与说话人识别,结果可导出 SRT 与 VTT 字幕。
-
Whisper:从 3900 万参数到 15.5 亿参数,六种尺寸按显存和精度挑
Whisper 是一个通用语音识别模型,同一个模型就能做多语言转写、翻译与语种判断;提供从 3900 万到 15.5 亿参数的六种尺寸,代码与权重都是 MIT 许可。
-
IndexTTS:本地部署的零样本语音合成,情感强度与语速都能用参数调
IndexTTS 是一个零样本文本转语音系统,一段参考音频就能克隆声音;最新版支持五种语言,还能用情感向量、语速系数与拼音发音控制来调节合成细节,也支持半精度推理与 vLLM 部署。
-
F5-TTS:开源语音合成模型,代码是 MIT 许可而预训练模型限非商用
F5-TTS 是一个用流匹配做语音合成的开源项目,提供 pip 安装、命令行推理与 Gradio 网页界面;代码是 MIT 许可,预训练模型因训练数据限制只能非商用。
-
CosyVoice:零样本克隆声音的开源语音合成,覆盖九种语言与十八种中文方言
CosyVoice 是一个开源的语音合成模型,最新版本 Fun-CosyVoice 3.0 支持零样本跨语言克隆声音,覆盖九种外语与十多种中文方言,以 Apache 2.0 许可证开源。
-
GPT-SoVITS:1 分钟语音数据就能微调出 TTS 模型,5 秒样本即可零样本合成
GPT-SoVITS 是一个开源的语音合成 WebUI:输入 5 秒人声就能零样本合成,1 分钟语音数据即可微调出相似度更高的音色,还支持跨中英日韩粤五种语言推理。
-
第 1 / 8 页