
Ultimate Vocal Remover:开源人声分离,干声与伴奏一键提取
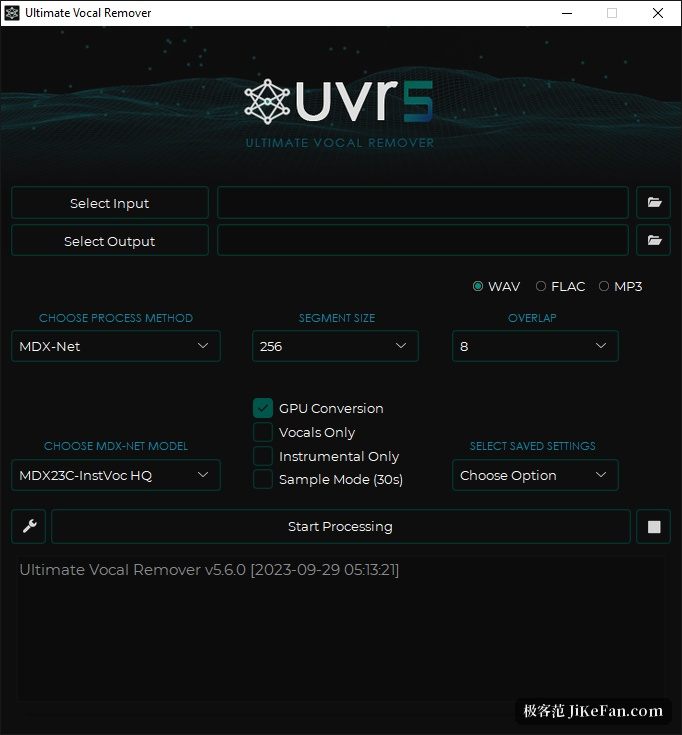
UVR 全名 Ultimate Vocal Remover,是一个做音源分离的开源工具:把一首歌拆成人声与伴奏,或者只把人声抹掉、留下伴奏。对做翻唱、混音、二次创作的人来说,这是最常用的一步预处理。
它最大的特点是「开箱即用」——官方安装包把界面、Python、PyTorch 与其它依赖打包在一起,官方说明里明确写了不需要额外准备前置条件,下载安装即可使用。
它到底做什么
官方对它的描述是:使用先进的音源分离模型,从音频文件中去除人声。这里说的是「分离」而不是「滤波」——不是把某个频段一刀切掉,而是让模型判断哪些成分属于人声、哪些属于伴奏,再把它们分别还原成独立音轨。
包里的模型绝大部分是项目自己的成果:官方说明除 Demucs v3 与 v4 的四轨模型之外,包内提供的模型都由 UVR 的核心开发者训练。也就是说,装上之后界面里可选的那一批模型,来源是清楚的。
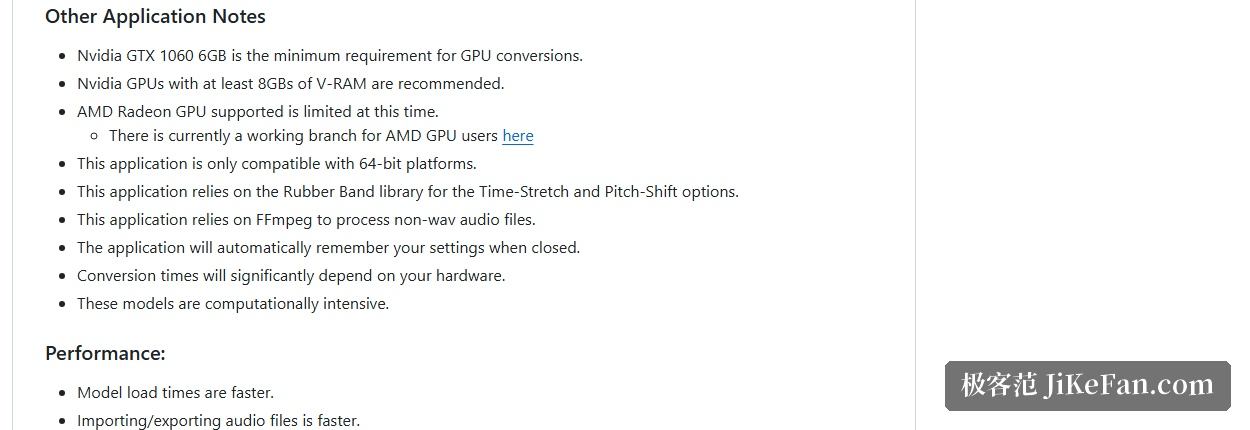
除了标准分离,它还带了一些配套工具,例如时间伸缩与变调——这两项依赖 Rubber Band 库;处理非 wav 格式的音频则依赖 FFmpeg。官方给了「把可执行文件直接放进应用目录」的免安装做法,不想折腾环境变量的人可以照做。
三个平台怎么装
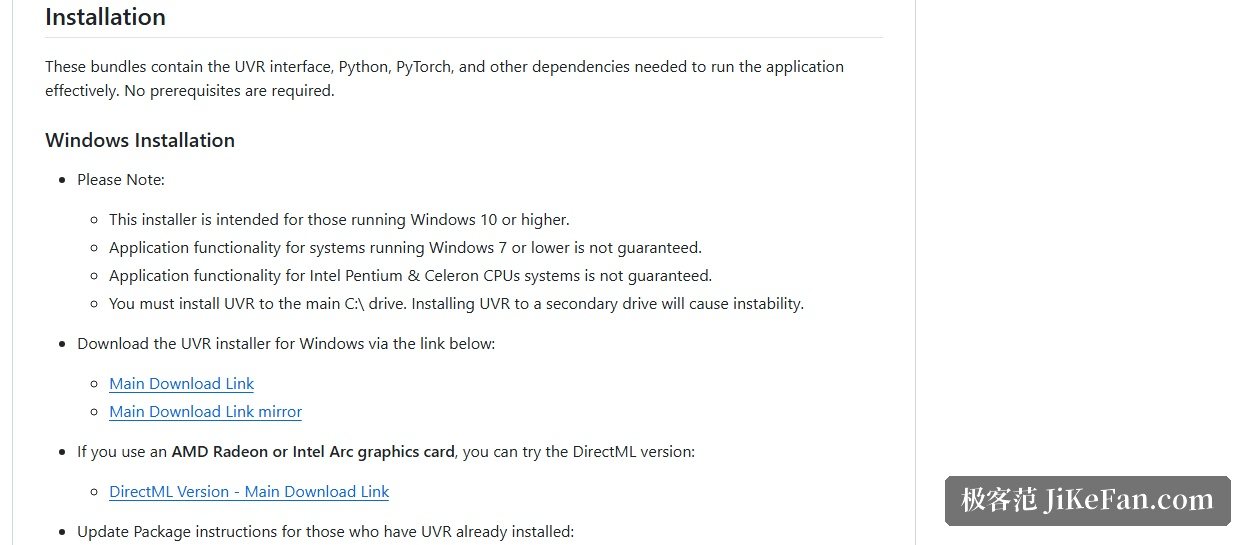
Windows 用户直接下安装程序:要求 Windows 10 或更高版本,并且必须装在 C 盘——官方特别提醒装到副盘会引起不稳定。如果用的是 AMD Radeon 或 Intel Arc 显卡,可以改用 DirectML 版本,官方也坦言 AMD 显卡的支持目前仍然有限。
macOS 用户需要 Big Sur 或更高版本,并按 M1 与 Intel 两种机型分别下载;官方提到 M1 的 MPS 加速已经扩展到支持 Demucs v4 与全部 MDX-Net 模型,另外首次启动可能要等 5 到 10 分钟。Linux 侧官方给的是手动流程:面向 Debian 与 Arch 系发行版,先装 FFmpeg、Python 包管理器与 tk 组件,再建虚拟环境安装依赖,最后以脚本方式启动。
硬件门槛与依赖
显卡是这类工具绕不开的话题。官方给出的最低要求是 Nvidia GTX 1060 6GB,但推荐显存 8GB 以上;软件只支持 64 位系统。官方同时提示转换耗时明显取决于硬件——分离模型本身就是计算密集型负载。
没有独显也不是不能用,但要有心理准备:CPU 跑分离的时间会明显长于音频本身的长度。稳妥的做法是先用一段短音频把流程走通,确认参数合适再处理整张专辑。
许可是 MIT
UVR 的代码以 MIT 许可证开源。官方在许可说明里补了一句给第三方开发者的话:如果要把这些模型用在自己的应用里,请按 MIT 许可的方式署明 UVR 及其开发者。宽松许可加上「模型来自官方」这一点,让它比同类闭源工具更适合放进长期的工作流。
另外,应用会在关闭时自动记住你的设置,省去每次重新配置的麻烦。
它适合谁
如果你只是偶尔想要一首歌的伴奏,网页版工具就够了。但如果你需要处理整批文件、需要反复换模型对比效果、或者不希望把音频上传到别人的服务器,UVR 这类本地工具的价值就体现出来了:装一次,之后每次分离都在自己的机器上完成。
需要提醒的是,分离质量受模型与素材影响很大,官方也坦言这些模型计算量不小。把它当成「预处理的第一步」而不是「一键完美出活」更合适——分出音轨之后,通常还需要在音频软件里做一轮修整。
把人声从伴奏里拆出来这件事,过去靠的是相位抵消这类技巧,效果时好时坏。换成音源分离模型之后,动手的是模型而不是你的经验——这类工具真正的价值,是把一件手艺活变成了可以重复执行的步骤。