
Demucs:开源音源分离模型,命令行一行拆出四条音轨
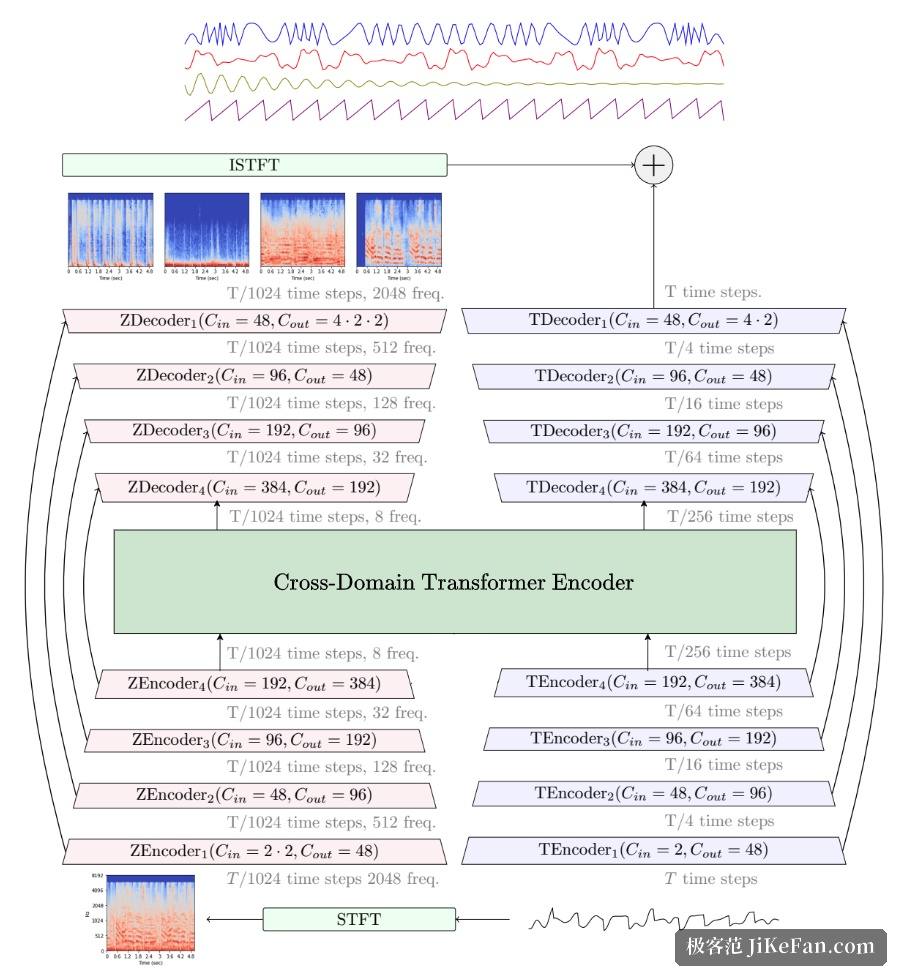
Demucs 是一个开源的音源分离模型,目标很直接:把一首混好的歌拆成几条独立音轨——鼓、贝斯、人声,以及剩下的其它伴奏。它是「模型加命令行」这种形态,想接进自己的脚本,比图形界面工具方便。
它由 Défossez 等人提出,经历过多次版本迭代,v4 是当前的主版本。有一件事需要先讲清楚:作者已经离开 Meta,原来的仓库不再维护,只处理重要修复——这一点对要不要把它放进长期项目很关键,本文末尾会展开。
它拆出什么
官方对它的描述是「当前先进的音乐音源分离模型」,目前能把鼓、贝斯与人声从其余伴奏中分离出来。也就是说输出的是四条音轨,而不是简单的「人声/伴奏」两分。
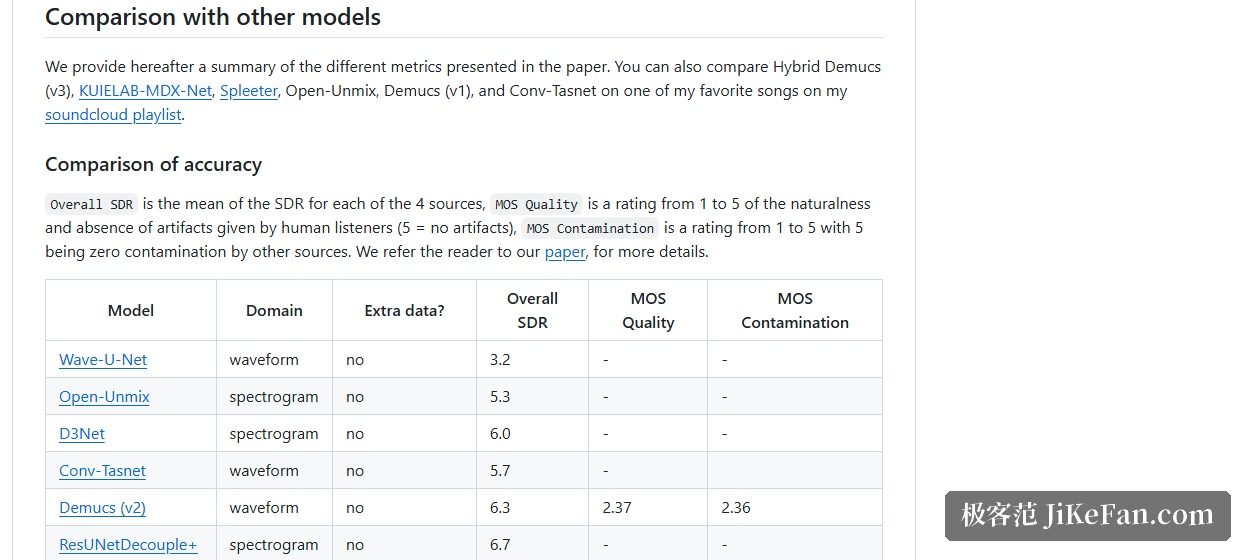
效果上的数字官方也给了:Hybrid Transformer Demucs 在 MUSDB HQ 测试集上的 SDR 为 9.00 dB;如果再叠加稀疏注意力与按源微调,可以做到 9.20 dB。这套模型是在 MUSDB HQ 数据集之外,又加了 800 首歌曲一起训练出来的。
模型怎么选
装好之后可选的模型不止一个,官方给了明确的取舍:默认模型是 htdemucs;想要更好一点的效果可以用微调版 htdemucs_ft,代价是分离耗时大约是默认模型的四倍。另有一个实验性的六源版本,会额外拆出钢琴与吉他——但官方自己说了,钢琴这一路目前效果不算好。
另外两个模型算是「历史战绩」型选手:mdx 曾在 MDX 挑战赛的 A 轨拿到第一,mdx_extra 在 B 轨排名第二;两者还各有一个量化版本,体积更小、质量可能略降。
装起来与基本用法
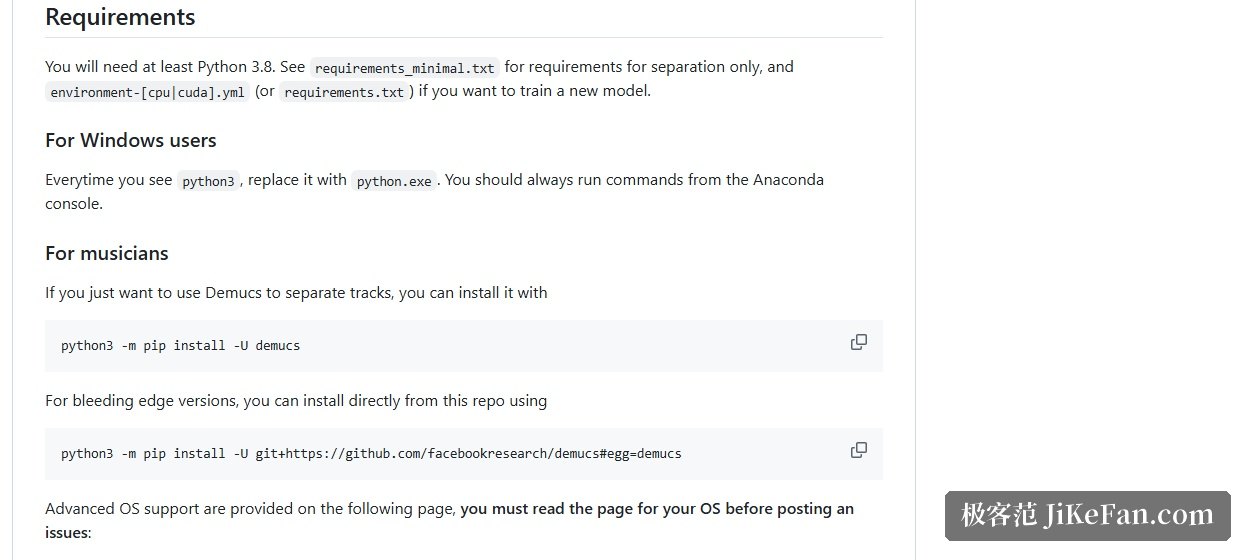
安装只要一条 pip 命令,要求 Python 3.8 或更高版本。官方同时提供了 conda 环境文件与容器镜像两种方式,适合需要复现环境、或者要跑在服务器上的场景。
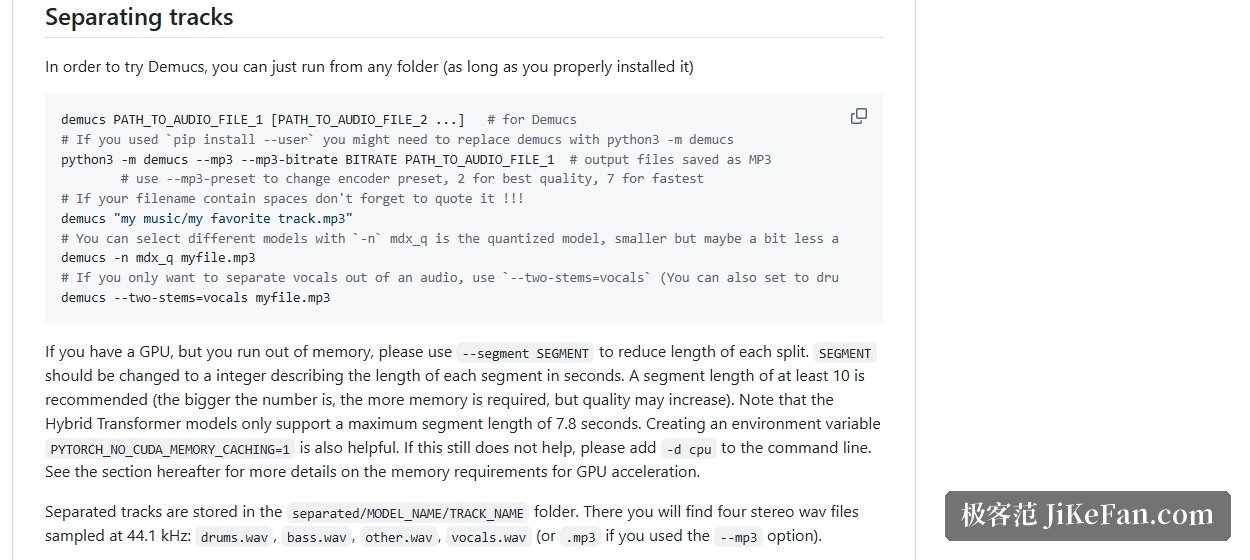
最常用的调用方式是把音频文件路径交给它,跑完在输出目录里拿结果:以模型名命名的目录下再按曲名分目录,里面是四个 44.1kHz 的立体声文件——鼓、贝斯、其它、人声。输出默认是 wav,也可以用参数改精度,或者直接存成 mp3。
如果只想要人声、不要其它音轨,可以打开只分离人声的模式,也就是常说的卡拉OK 用法。官方提醒这个模式并不是「只算人声」——它先把整轨全部分离再混合,所以既不会更快,也不会更省内存。
显存、速度与调用方式
显存方面官方给的数字是:用 GPU 至少要 3GB,但按默认参数跑大约需要 7GB。显存不够有两条退路——调小分段长度,或者干脆切到 CPU 计算。用 CPU 的代价是时间,官方给出的经验值是处理时间约为音频时长的 1.5 倍。
除了命令行,它也能直接从 Python 程序里调用:把命令行参数原样传给接口即可,等于把分离这一步嵌进自己的批处理流程。
维护状态与许可
这一节需要如实说明:作者在仓库首页写明自己已不再就职于 Meta,因此原仓库不再维护,只处理重要的问题修复,功能请求也不再受理,同时把工作转移到了自己新建的分支仓库。
许可上,Demucs 以 MIT 许可证开源,宽松度足够放进商业流程,只是要接受「上游基本冻结」这个现实:选它意味着你用的是一套已经稳定的实现,而不是一个还在快速演进的项目。
它适合谁
如果你的需求是「把一批音频按四条音轨拆开,并且希望这一步能写进脚本」,Demucs 的形态比图形界面工具更顺手:装一次、调用一次、输出固定的目录结构,剩下的交给自己的流程编排。
反过来,如果你只是想偶尔给一首歌做伴奏,或者希望点几下鼠标就能试遍各种模型组合,那带界面的工具会更省心。Demucs 的价值不在门槛低,而在可控与可重复。
音源分离这几年从「技巧活」变成了「模型活」:真正决定效果的,已经从你会不会调参,变成你选的模型在什么数据上训练过。于是工具选型的重点,也跟着从功能表移到了模型清单与维护状态上。