
WhisperX:70 倍实时的开源转写工具,输出词级时间戳与说话人标签
WhisperX 解决的是一个很具体的问题:Whisper 转写出来的文字很准,但时间戳只到句子一级,做字幕时会发现文字和画面对不上,偏差几秒是常事,而且它本身不支持批量处理。
WhisperX 的做法是在 Whisper 之外补上两步——先把转写结果和音频做一次强制对齐,把时间戳精确到每个词;再把音频按说话人切开,给每一句标上是谁说的。官方把这套流程做成了一条流水线,对外提供命令行与 Python 两种用法。
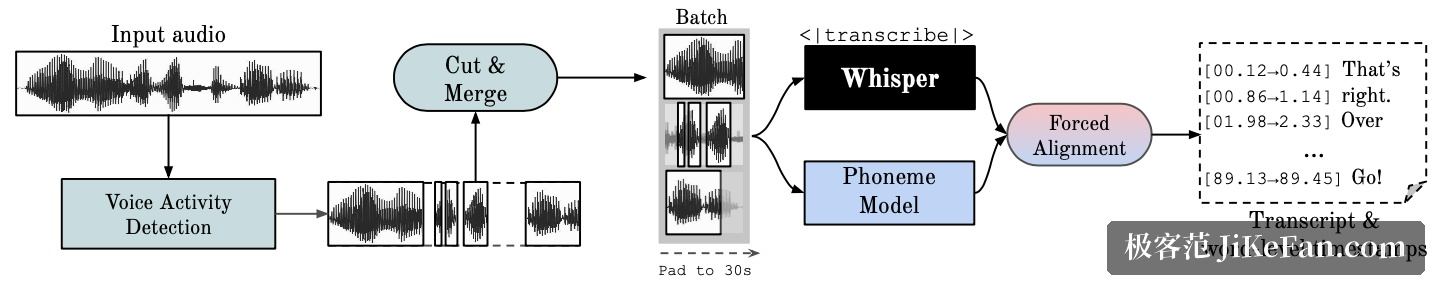
一条四步流水线
官方仓库给出的流水线图把过程拆成四步:先做语音活动检测,把静音段过滤掉;再交给转写模型批量出文字;然后用音素级识别模型做强制对齐,得到词级时间戳;最后用说话人分离模型区分不同的人。
几个关键指标都写在官方说明里:在 large-v2 模型上做批处理推理可以达到 70 倍实时;转写后端用的是 faster-whisper,large-v2 在 beam size 为 5 的设定下显存需求小于 8GB;词级时间戳来自 wav2vec2 强制对齐;说话人分离来自 pyannote-audio,输出的是说话人 ID 标签。整套流程的论文发表在 INTERSPEECH 2023,题目是 WhisperX: Time-Accurate Speech Transcription of Long-Form Audio。
前置的语音活动检测还有个副作用值得一提:官方说明它能在减少幻觉的同时不损失识别准确率,并且让批处理更容易做——这也是它能把速度做上去的前提之一。
装起来:一条 pip 命令
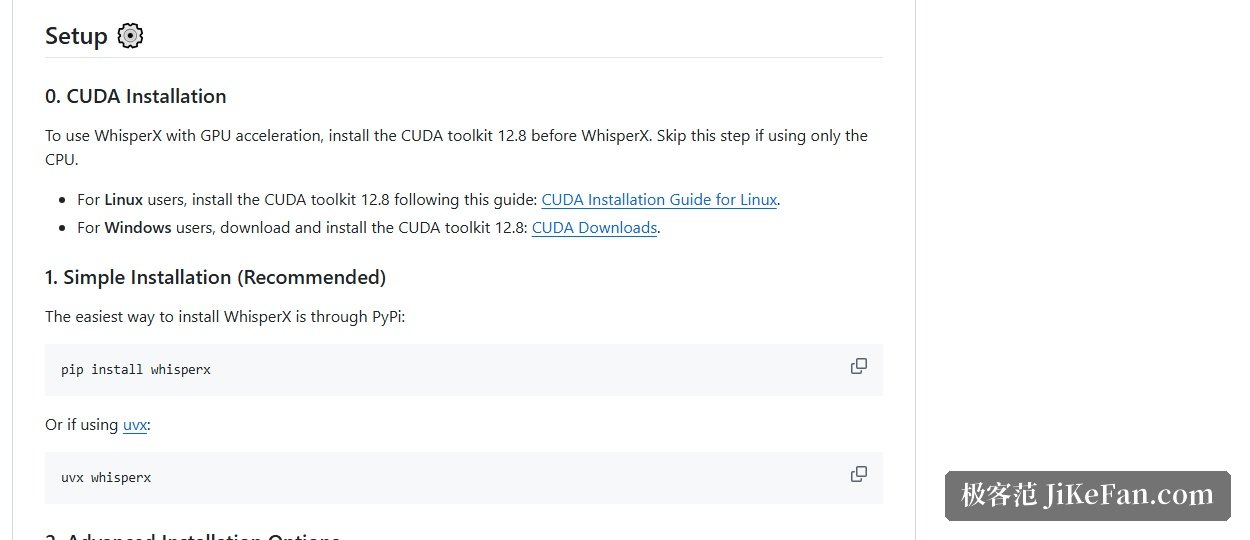
官方推荐的安装方式很简单,一条 pip 命令就够;如果机器上装了 uv,也可以直接用 uvx 把命令跑起来,不必先装进环境。想在 GPU 上加速,需要先装好 CUDA 12.8;只用 CPU 的话可以跳过这一步。
如果要开启说话人分离,需要额外准备一个 Hugging Face 的访问令牌,通过命令行参数传进去,并且先在模型页面同意使用条款。也就是说,转写和对齐本身不依赖联网,但说话人分离这一步会涉及模型下载与授权。
命令行怎么用
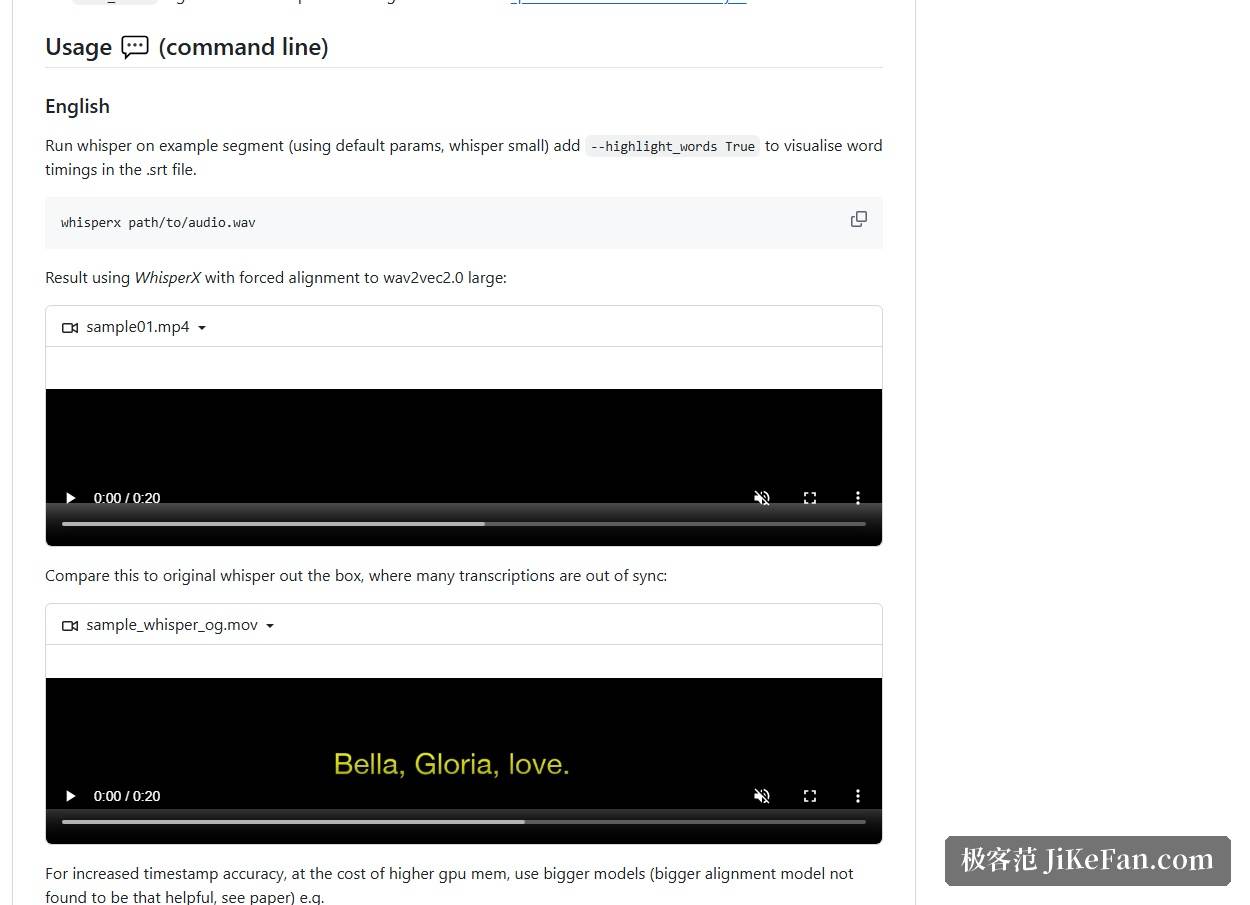
最基本的用法是把音频文件路径交给它,默认用较小的模型和默认参数跑一遍。要让时间戳更准,可以换更大的模型并显式指定对齐模型,代价是占用更多显存。多人音频加上说话人分离参数,字幕里还能开启逐词高亮,方便逐个核对每个词的时间点。
没有显卡同样能用,加两个参数切到 CPU 计算即可,官方也说明这种方式同时适用于在 Mac 上运行。需要注意的是,词级对齐用的音素模型是按语言准备的:英语、法语、德语、西班牙语、意大利语有现成的默认模型,其他语言需要自己找对应的模型并测试效果。
faster-whisper:把转写后端单独拿出来用
WhisperX 的转写环节用的是 faster-whisper。后者是一套独立的开源实现,用 CTranslate2 这个推理引擎重写了 Whisper,官方描述是同等准确率下最快比原版快 4 倍,并且占用更少内存;在 CPU 和 GPU 上都能用 8 位量化再提一档效率。
如果你只需要转写、不需要词级对齐和说话人分离,直接用它会更轻。安装同样是 pip 一条命令,而且它对系统依赖比较友好:不像原版那样要求系统里先装好 FFmpeg,音频解码交给 PyAV 完成,因为 PyAV 已经把 FFmpeg 的库打包在自己的包内。运行环境要求 Python 3.9 或更高版本。
官方基准测试里的数字
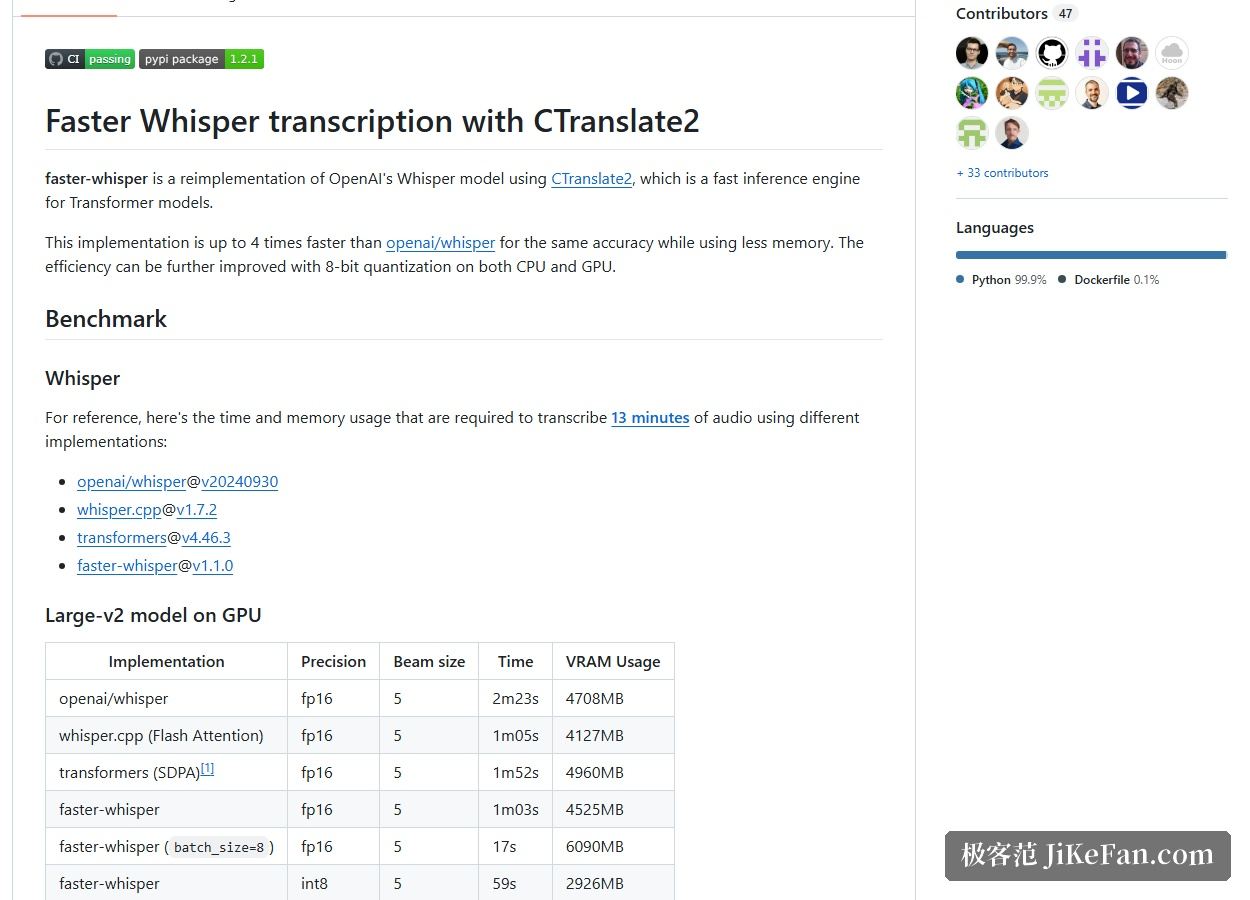
官方给了一组可复现的对比:用 13 分钟音频,在 RTX 3070 Ti 8GB 上跑 large-v2 模型,精度 fp16、beam size 取 5。
实现 | 用时 | 显存占用 |
|---|---|---|
openai/whisper | 2 分 23 秒 | 4708MB |
whisper.cpp(Flash Attention) | 1 分 05 秒 | 4127MB |
faster-whisper | 1 分 03 秒 | 4525MB |
faster-whisper(批处理 8) | 17 秒 | 6090MB |
faster-whisper(int8) | 59 秒 | 2926MB |
faster-whisper(批处理 8 + int8) | 16 秒 | 4500MB |
这张表里最值得看的是批处理那一行:同样是 fp16 精度,默认逐条跑要 1 分 03 秒,开成批处理只要 17 秒;如果显存紧张,切到 int8 可以把占用压到 2926MB。CPU 侧也有对应的数据:小模型在 8 线程的桌面处理器上,原版要 6 分 58 秒,faster-whisper 的 int8 批处理是 51 秒。
官方也提醒,比较不同实现时要注意参数对齐:相同的 beam size、相近的识别准确率、CPU 场景下相同的线程数,否则数字没有可比性。例如原版默认的 beam size 是 1,而 faster-whisper 默认是 5。
用 Python 调起来更顺手
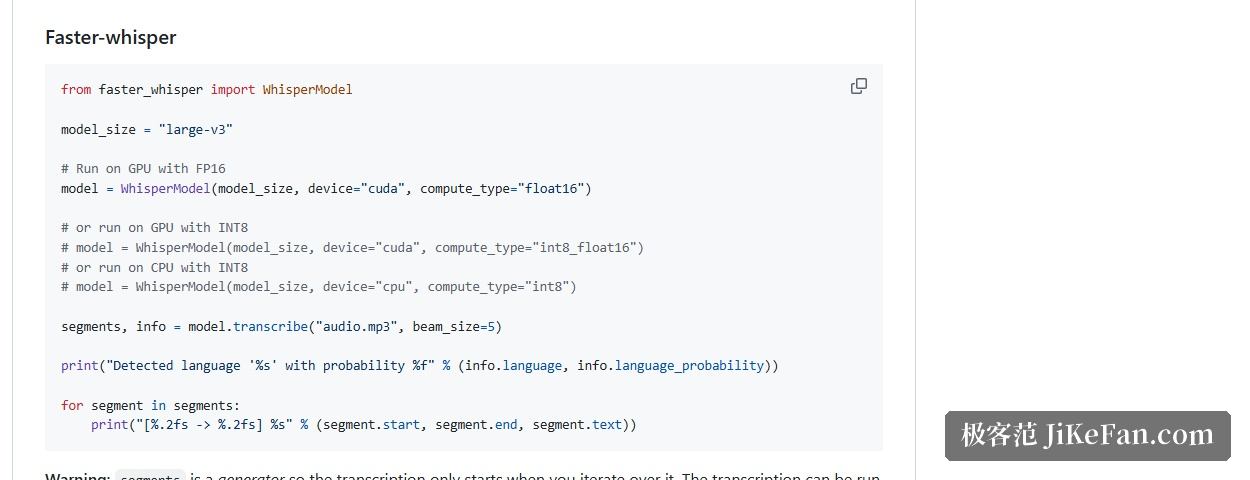
要在自己的脚本里用,faster-whisper 的接口只有几行:指定模型大小、设备与计算精度,然后调用转写。有一点需要留意,它返回的转写结果是一个生成器,真正的计算发生在你开始遍历它的时候,所以要先转成列表或者用循环取出来,否则看起来像是没跑到。批处理是另一套接口,把模型包一层并给出批大小即可;需要词级时间戳时打开对应参数,就能逐词拿到开始与结束时间。想过滤长静音,打开 VAD 过滤就行,官方默认只去掉超过 2 秒的静音,这个阈值可以自定义。
几个要提前知道的限制
词级对齐不是万能的。官方明确列出:年份缩写、带货币符号的金额这类在对齐模型词典里找不到的写法,无法给出时间点,也就没有时间戳;重叠说话的场景,Whisper 和 WhisperX 处理得都不算好;说话人分离本身也远谈不上完美;另外对齐模型按语言准备,换语言就要换模型。
许可是 BSD 与 MIT
WhisperX 以 BSD 许可证开源,faster-whisper 以 MIT 许可证开源,两者都在仓库根目录提供 LICENSE 文件。宽松的许可意味着把它接进自己的字幕流程、或者做二次开发,授权上的障碍都不大。
它适合谁
如果你的目标是把长音频变成能直接用的字幕文件,WhisperX 的价值就落在这条流水线上:时间戳精确到词,多人内容能区分说话人,命令行与 Python 两套接口都能接进现有的处理流程。官方称它在 large-v2 上能做到 70 倍实时,对动辄几小时的素材来说,这个差距很实在。
但它并不打算做成开箱即用的桌面应用:环境要自己配,模型与语言要自己选,对多数人来说真正的门槛不是命令,而是显卡与模型大小的取舍。如果只是想快速把录音转成文字、不需要词级时间戳,直接用 faster-whisper 会更省事。
转写快不快是工程问题,时间戳准不准才是字幕能不能用的前提。把对齐这件事单独做扎实,长音频的后期成本才会真正降下来。