
GPT-SoVITS:1 分钟语音数据就能微调出 TTS 模型,5 秒样本即可零样本合成
给 AI 一段录音让它学会一个人说话,这件事的门槛这两年一直在往下掉。GPT-SoVITS 把这条线压到了两个数字:五秒和一分钟。五秒是人声样本的下限,用它可以在零样本模式下直接合成语音;一分钟是训练数据的下限,用它微调之后音色相似度会明显提升。项目在 GitHub 上开源,仓库标题写得很直白——一分钟语音数据也能训练出一个可用的 TTS 模型。
两种用法:不训练和少训练
官方把能力拆成两条路径,对应两类需求。
零样本 TTS 是最省事的一条:输入五秒的人声样本,立刻就能把文字转成语音。适合先试试效果、或者只是偶尔用一次的场景,不用等训练,也不用准备数据集。
少样本 TTS 是效果更好的那条:用一分钟的训练数据微调模型,换来更高的声音相似度和更自然的听感。一分钟这个量级的意义在于,它把「训练自己的语音模型」从需要几小时录音的专业工作,变成了随手录一段就能试的事情。
说哪种语言
官方列出的支持语种是英语、日语、韩语、粤语和中文。更有意思的是跨语言这一条:推理时使用的语言可以和训练集的语言不一样。也就是说,用一种语言录的样本,理论上可以拿去说另一种语言,不必为每个语种重新准备一套数据。
WebUI 里自带数据准备工具
真正做语音克隆的人会知道,麻烦的往往不是模型本身,而是前期的数据处理:录音里混着背景音乐怎么办、长音频怎么切、切完谁来写转写文本。GPT-SoVITS 把这些环节一起做进了 WebUI——内置人声伴奏分离、自动训练集分割、多语言语音识别标注和文本标注。
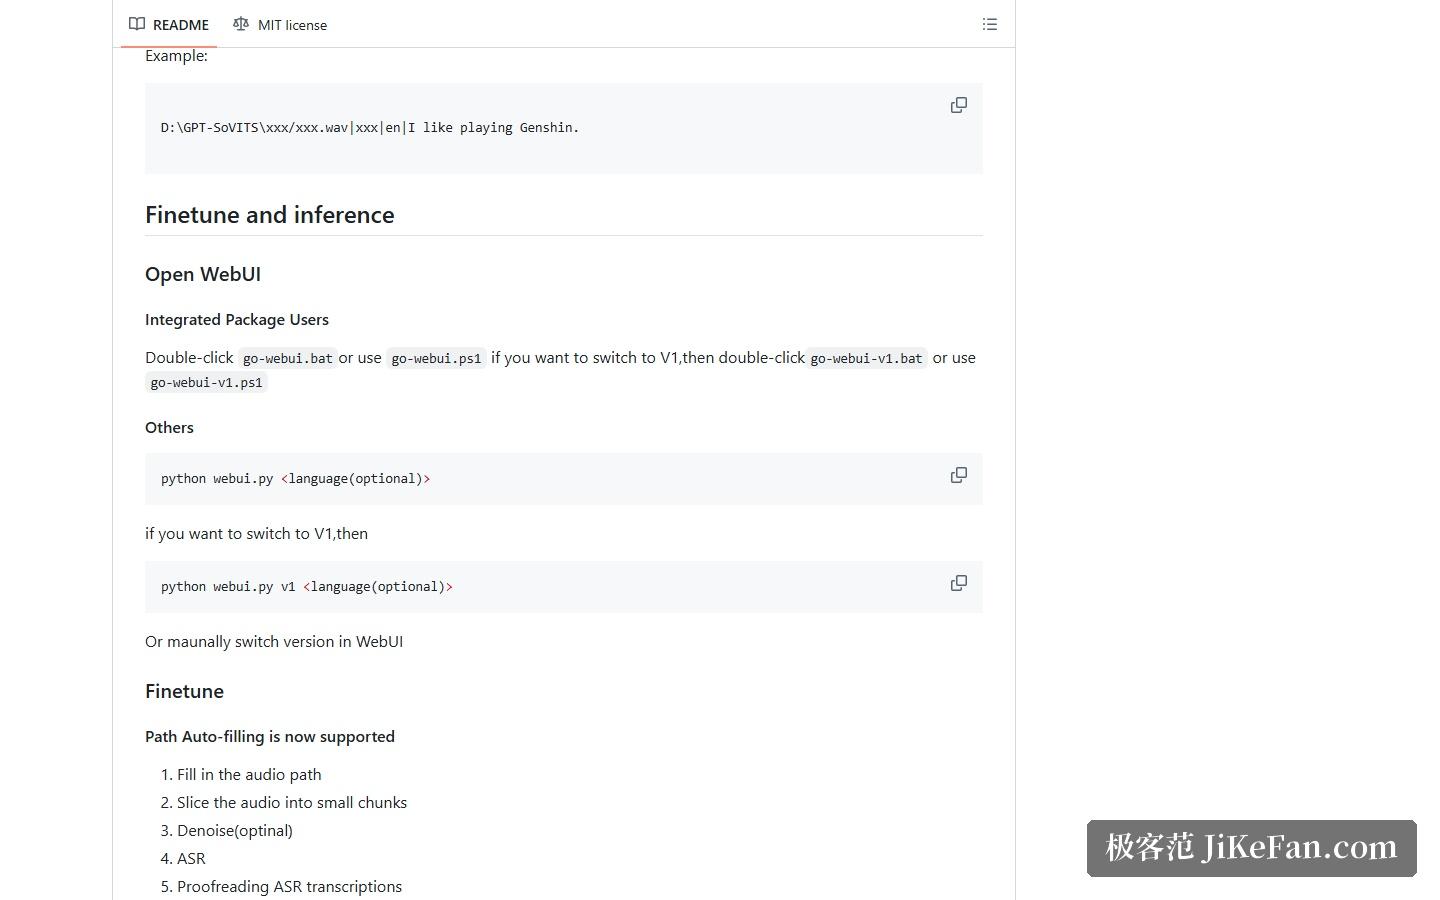
所以实际的操作顺序是:填音频路径、切片、按需降噪、跑语音识别、校对转写文本,然后切到微调页训练。语音识别部分集成了 Fun-ASR、SenseVoice 和 FunASR 几套工具,新手不用自己去拼装这条流水线。
版本不少,怎么选
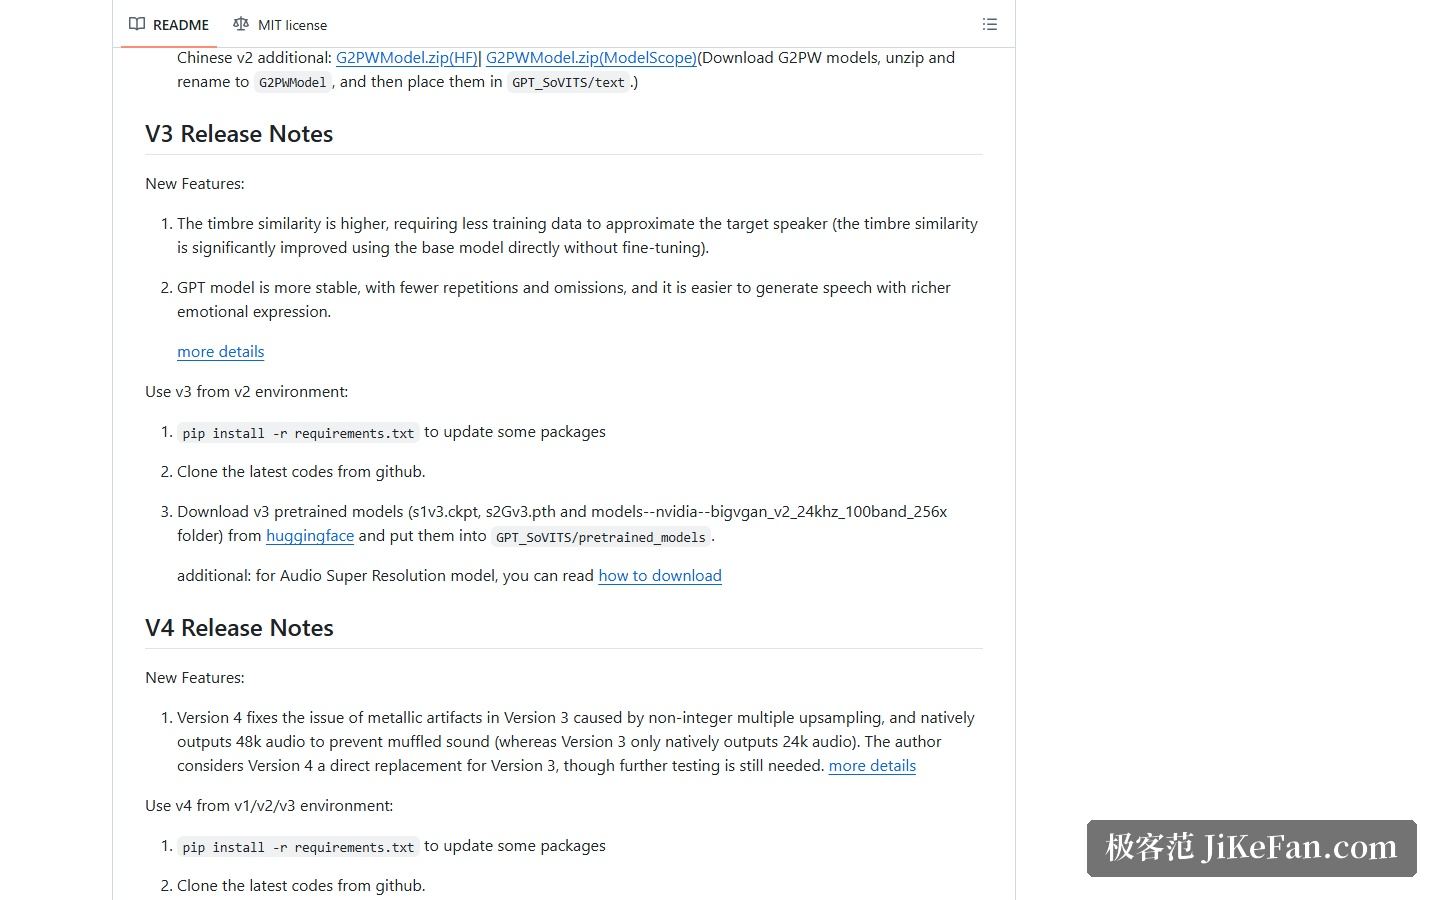
仓库目前提供 V1、V2、V2Pro、V3 和 V4 等多个版本,可以在启动时用参数切换,Windows 集成包也配了对应的启动脚本。几个关键差异值得记住:V2 把预训练模型规模从两千小时扩到五千小时,并新增了韩语和粤语;V3 在不微调的情况下音色相似度就有明显提升,同时 GPT 模块更稳定、情绪更丰富;V4 修复了 V3 因为非整数倍上采样带来的金属杂音,并原生输出 48kHz 音频,而 V3 是 24kHz。
装起来麻烦吗
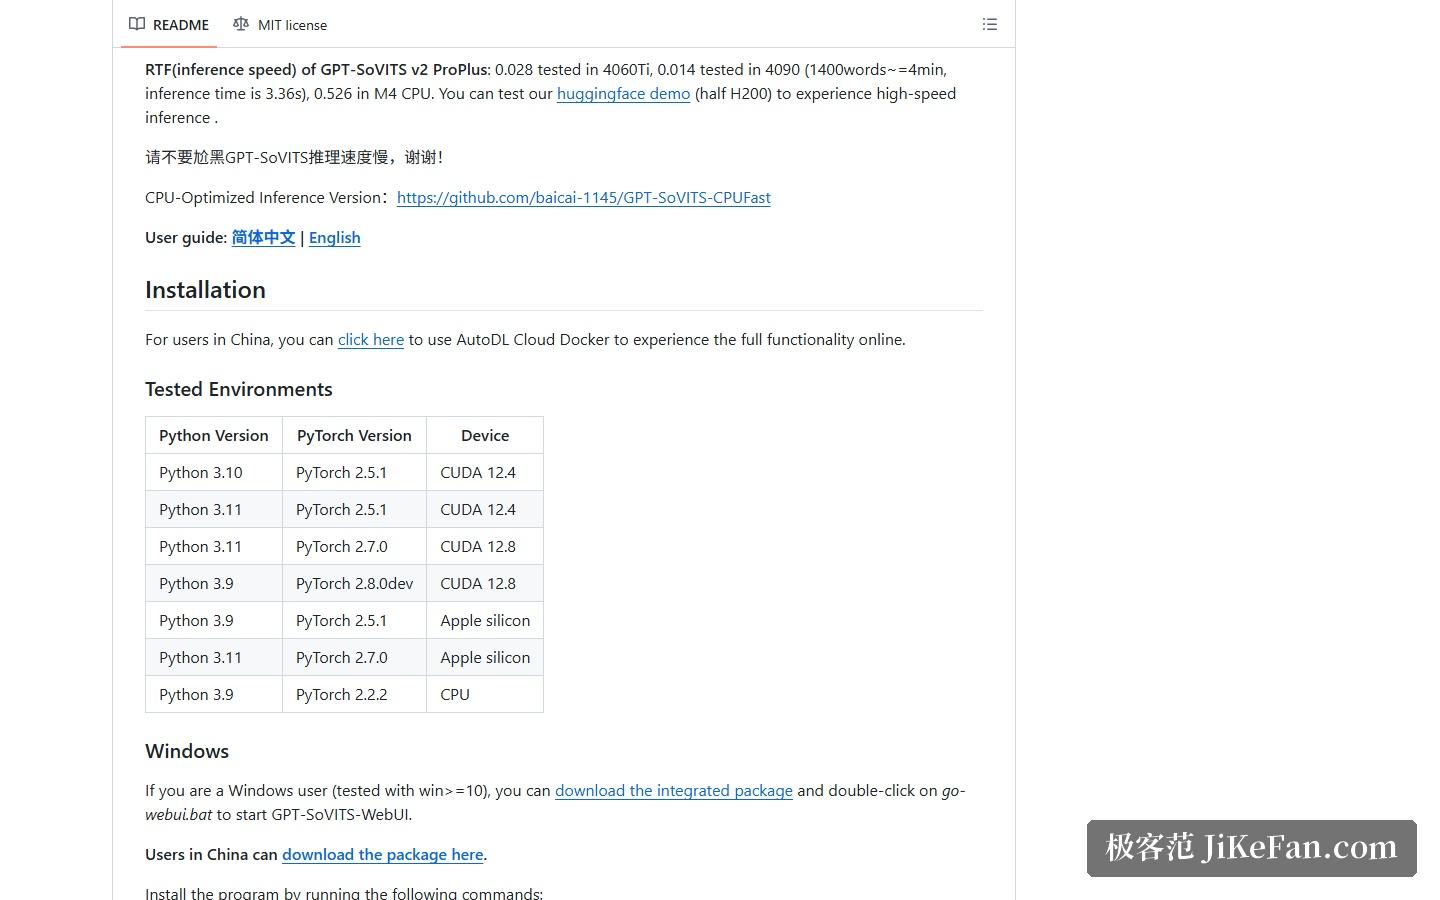
官方给了几条路。最省事的是 Windows 集成包:下载解压后双击启动脚本,WebUI 就打开了。想在命令行里管理环境的话,Windows 有 PowerShell 安装脚本,Linux 与 macOS 有 shell 脚本,都能指定设备类型和模型下载源。再往下是手动安装与 Docker 两条路,前者需要自己装好依赖和 FFmpeg,后者官方提醒轻量镜像不含语音识别与人声分离模型,需要额外下载。
环境方面,官方列出的测试组合覆盖 Python 3.9 到 3.11、PyTorch 2.2 到 2.7,设备既有走独立显卡的桌面组合,也有纯 CPU 的轻量组合。有一点要提前知道:官方说明在部分平台上用 GPU 训练出来的模型质量明显不如其他设备,因此项目在这些平台上暂时改用 CPU 训练,速度会慢不少。
它适合谁
如果你的需求是「训练一个属于自己或某个指定音色的语音模型,并且希望数据留在本地」,GPT-SoVITS 的定位正好对上:数据量要求低、工具链完整、许可证是 MIT,用起来限制不多。
但它需要一张能用得上的显卡,或者接受 CPU 推理的慢速度;在部分平台上训练环节的耗时会明显更长,这一点要有心理准备。另外,声音克隆这件事的边界不在技术而在授权:用别人的声音,尤其是公众人物的声音做内容,可能涉及人格权与声音权,动手前先把权利来源确认清楚。
一分钟数据训练一个 TTS 模型,放在几年前是难以想象的。工具越强大,越需要使用者自己守住那条线——能用和该用,始终是两件事。