
RVC:开源音色转换框架,10 分钟语音数据即可训练,端到端延迟 170 毫秒
RVC 全名 Retrieval-based-Voice-Conversion-WebUI,官方定位是「简单易用的语音音色转换/变声器框架」。它做的事和语音合成不同:不是从文字生成语音,而是把一段已经录好的声音,换成另一个音色。
这类工具过去的门槛不低,RVC 把门槛压到了两个数字上:训练至少需要 10 分钟语音数据,实时变声的端到端延迟是 170 毫秒。
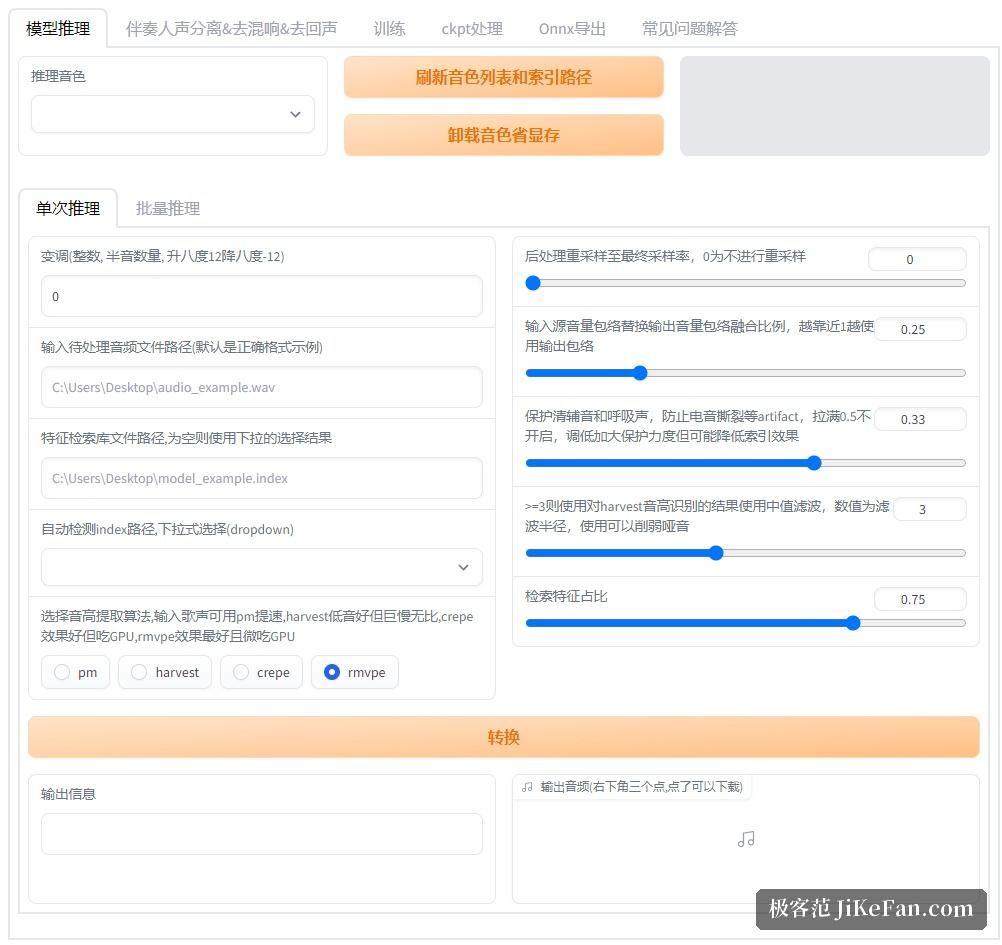
它和语音合成有什么不同
语音合成输入文字、输出语音;RVC 输入的是语音本身。你给它一段录音,它输出内容相同、音色换成目标模型的版本——改变的是「谁在说」,而不是「说了什么」。
官方在简介里列的第一条特性是:使用 top1 检索把输入源特征替换为训练集特征,用来杜绝音色泄漏。检索到的特征来自训练集本身,输出因此更贴近目标音色,而不是把输入源的口音与音质一并带过去。
10 分钟数据就能训练
官方建议至少收集 10 分钟低底噪语音数据,用少量数据训练也能得到较好结果。这个量级意味着不需要专业录音棚,一段安静的室内录音基本够用。
硬件要求同样不高,官方明确写了「即便在相对较差的显卡上也能快速训练」。底模由接近 50 小时的开源高质量 VCTK 训练集训练而成,官方称无版权方面的顾虑;此外还能在 ckpt 处理选项卡里用 ckpt-merge 做模型融合来改变音色。
装起来:依赖按显卡分三档
这个分支面向 64 位 Python 3.12,Ubuntu 侧推荐 24.04。依赖按硬件分三档:纯 CPU 与 AMD、Intel 显卡用一份依赖文件;NVIDIA 显卡再按新旧分开——RTX 50 系先装 CUDA 12.8 版 Torch,RTX 50 系以前先装 CUDA 11.8 版 Torch,之后再装各自对应的依赖文件,注意是先装 Torch 再装依赖文件。装完可用一条命令打印 Torch 与 CUDA 版本,先确认环境再往下走。
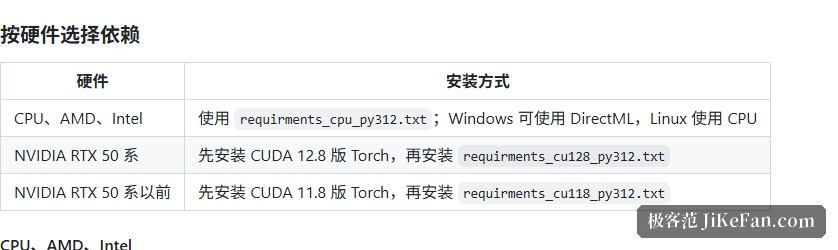
AMD 与 Intel 显卡走的是 CPU 依赖方案:Windows 上可用 DirectML,Linux 上直接用 CPU。非 NVIDIA 平台不是不能跑,但要接受算力上的落差。
模型要放对位置
WebUI 会自动创建运行目录,但模型要自己下载并放到指定位置。官方要求保持固定结构:特征提取用的 hubert_base、音高提取用的 rmvpe 权重、训练用的 pretrained 与 pretrained_v2、人声分离用的 pymss_weights,以及存放用户模型的 weights 与存放索引的 indices。
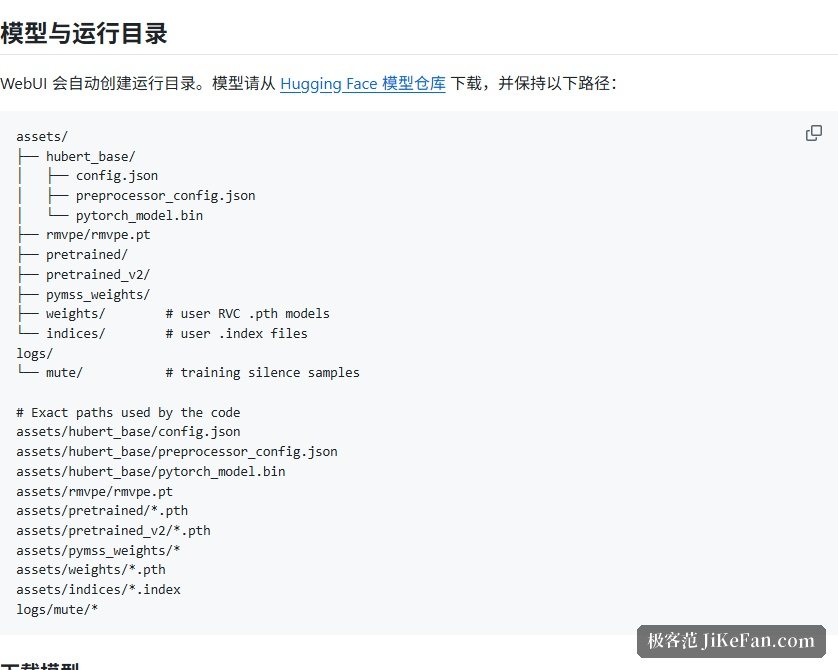
下载同样走命令行工具,按用途分几组:推理与特征提取必需一组,v1/v2 训练必需另一组,人声分离可选一组;仅 Windows 上的 DirectML 环境还需额外一份 onnx 格式的音高权重。另外 Windows 要自己把 FFmpeg 的两个可执行文件放进项目根目录。
实时变声与延迟
官方给了网页界面与单独的实时变声界面两个入口。延迟是这里最值得看的一项——官方称已实现端到端 170 毫秒,若使用 ASIO 输入输出设备可以做到端到端 90 毫秒,但官方也坦言这非常依赖硬件驱动的支持。
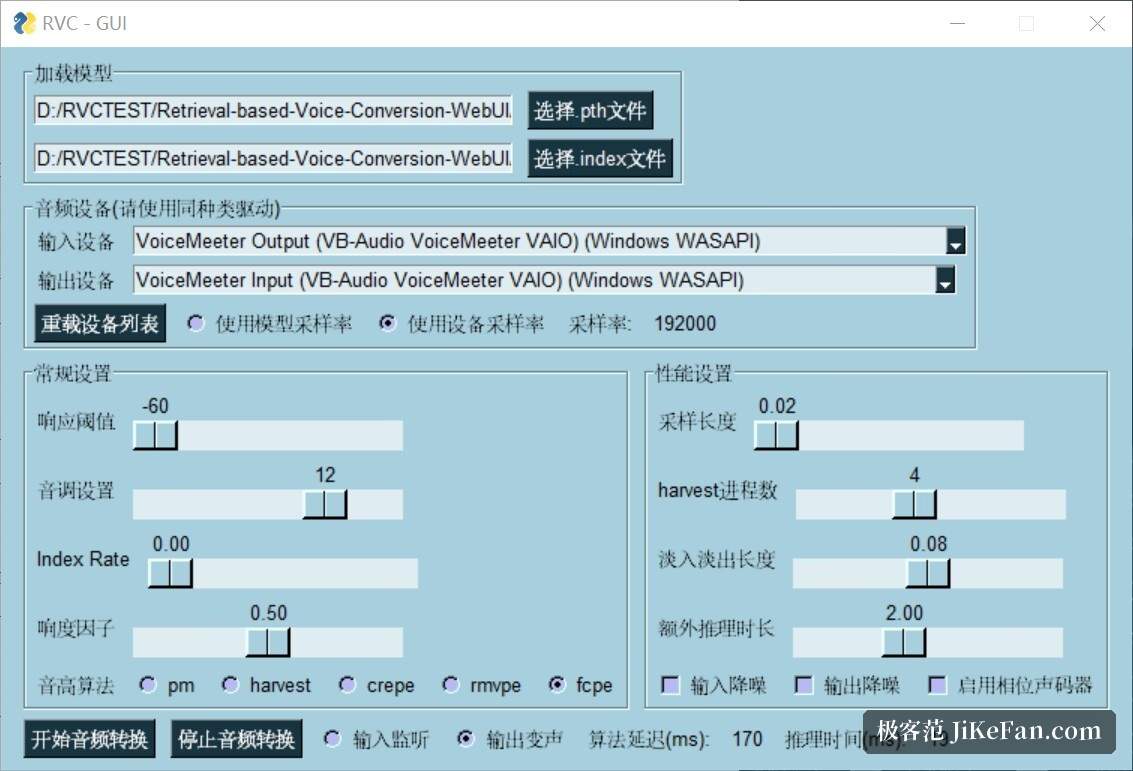
能压到这个量级,音高提取算法是关键一环。官方采用的是 InterSpeech2023 的 RMVPE 算法,评价是「根绝哑音问题,速度快、资源占用小」;界面里也可切回 pm、harvest 或 crepe。
启动方式与许可
启动命令就一条,默认监听 7865 端口,没有桌面环境的 Ubuntu 服务器可以加参数跳过自动打开浏览器;用户模型放 weights 目录、索引放 indices 目录。
许可以 MIT 许可证开源,底模用的是开源 VCTK 数据集、官方称无版权方面的顾虑。有一点需要自己把关:音色转换处理的是他人的声音,把结果用于公开内容时,请先确认已取得相应授权。
音色转换这类工具的进步,把「声音」从一种生理特征变成了可以建模的参数。技术上的便利是一回事,用在哪里是另一回事——模型能做的事,和应该做的事,从来不是同一个问题。