
Ornith 는 9B 에서 397B 까지, 훈련 문제를 모델이 스스로 낸다
요약
DeepReinforce 의 Ornith 는 문제 내기와 발판 세우기, 풀이 쓰기를 모델 스스로 하게 하고, 규모는 9B 에서 397B 까지 세 가지다. MIT 허가로 나오며 256K 문맥과 자체 배치를 지원한다.
추천- 이름
- Ornith
- 버전
- 1.5
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsmacOSLinux
- 공식 사이트
- https://ornith.ai
- 업데이트
- 2026-10-10 14:39
Ornith 는 무엇을 훈련할지와 어떻게 훈련할지를 함께 모델 스스로에게 맡긴 공개 프로그래밍 모델 가족이며, 이름은 그리스어의 새에서 왔다.
Ornith 는 인공지능 연구 실험실 DeepReinforce 에서 나왔고 대리인 방식 프로그래밍 과제를 겨냥한다. 정해진 훈련 절차 안에서 모델을 더 정확하게 다듬는 데 머물지 않고, 훈련 자체를 짜는 권한도 모델에게 돌려준다. 훈련 문제는 모델이 내고, 푸는 발판은 모델이 세우고, 마지막 풀이의 궤적도 모델이 만든다. 파는 쪽은 이 길을 스스로 나아짐이라 부르고 가족 전체의 본줄기로 삼는다.
지금까지 두 세대가 나왔다. 2026 년 6 월의 Ornith-1.0 은 스스로 발판을 세우는 틀을 내놓았고, 2026 년 8 월의 Ornith-1.5 는 그 틀을 발판과 풀이의 공동 최적화에서 온전한 자기 개선 순환으로 넓혔다.
스스로 세우는 발판에서 자기 개선 순환으로
Ornith-1.0 의 핵심은 발판을 배울 수 있는 대상으로 다루는 것이다. 보통의 강화 학습에서는 도구 호출 순서, 오류 뒤의 다시 시도 규칙, 기억을 짜는 방식이 사람이 쓴 고정 뼈대에 의해 정해지고 모델은 그 안에서 풀이만 낸다. Ornith-1.0 은 모델이 훈련의 매 바퀴에서 먼저 과제 설명을 보고 더 정교한 발판 한 판을 제안하고, 그 발판 아래에서 풀이 궤적을 만든다. 풀이가 보상을 받으면 그 보상이 발판을 쓰는 단계와 풀이를 쓰는 단계로 함께 돌아간다. 여러 번 되풀이하면 과제 종류별 진행 방식이 스스로 드러나고, 사람이 종류마다 지정할 필요가 없다.
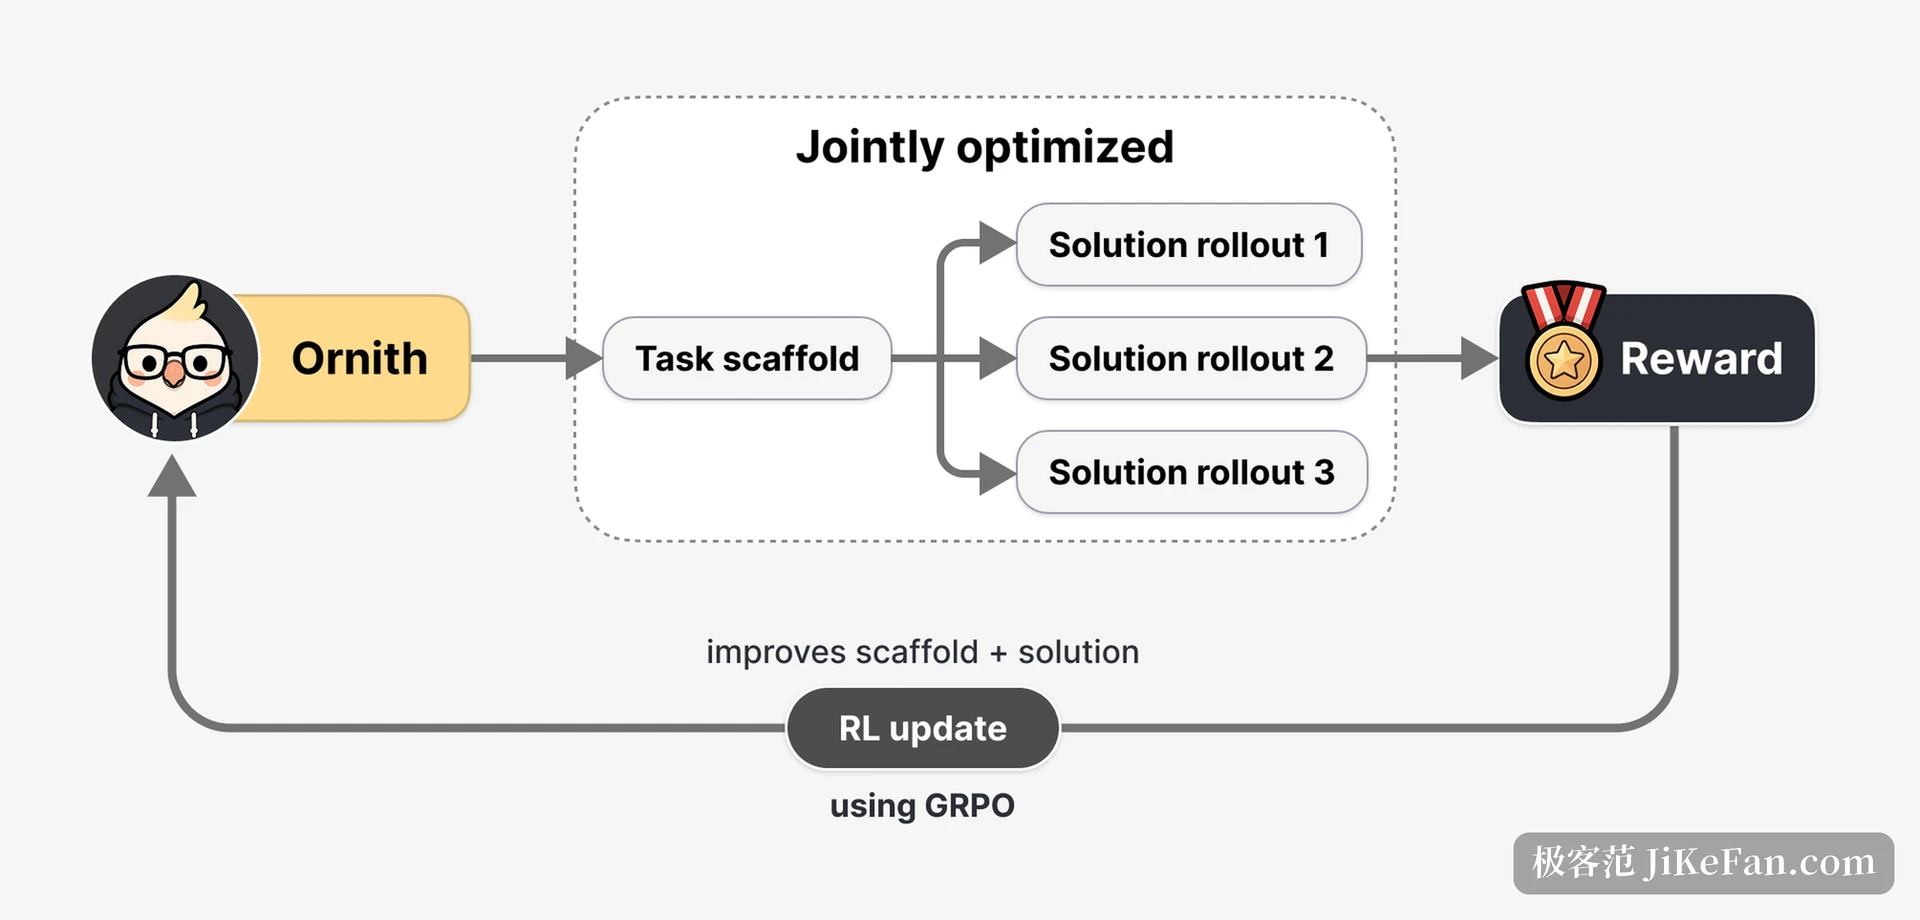
Ornith-1.5 는 이 생각을 한 걸음 더 민다. 훈련 순환이 두 단계에서 세 단계가 된다. 모델이 먼저 앞보다 어려운 새 과제를 내고, 그 과제에 맞는 발판을 세우고, 마지막으로 그 발판 아래에서 풀이 궤적을 낸다. 보상이 세 단계를 지나므로 모델이 배우는 것은 더 정확히 푸는 법만이 아니라 더 값진 과제를 내는 법과 더 효과적인 발판을 세우는 법까지 포함한다.
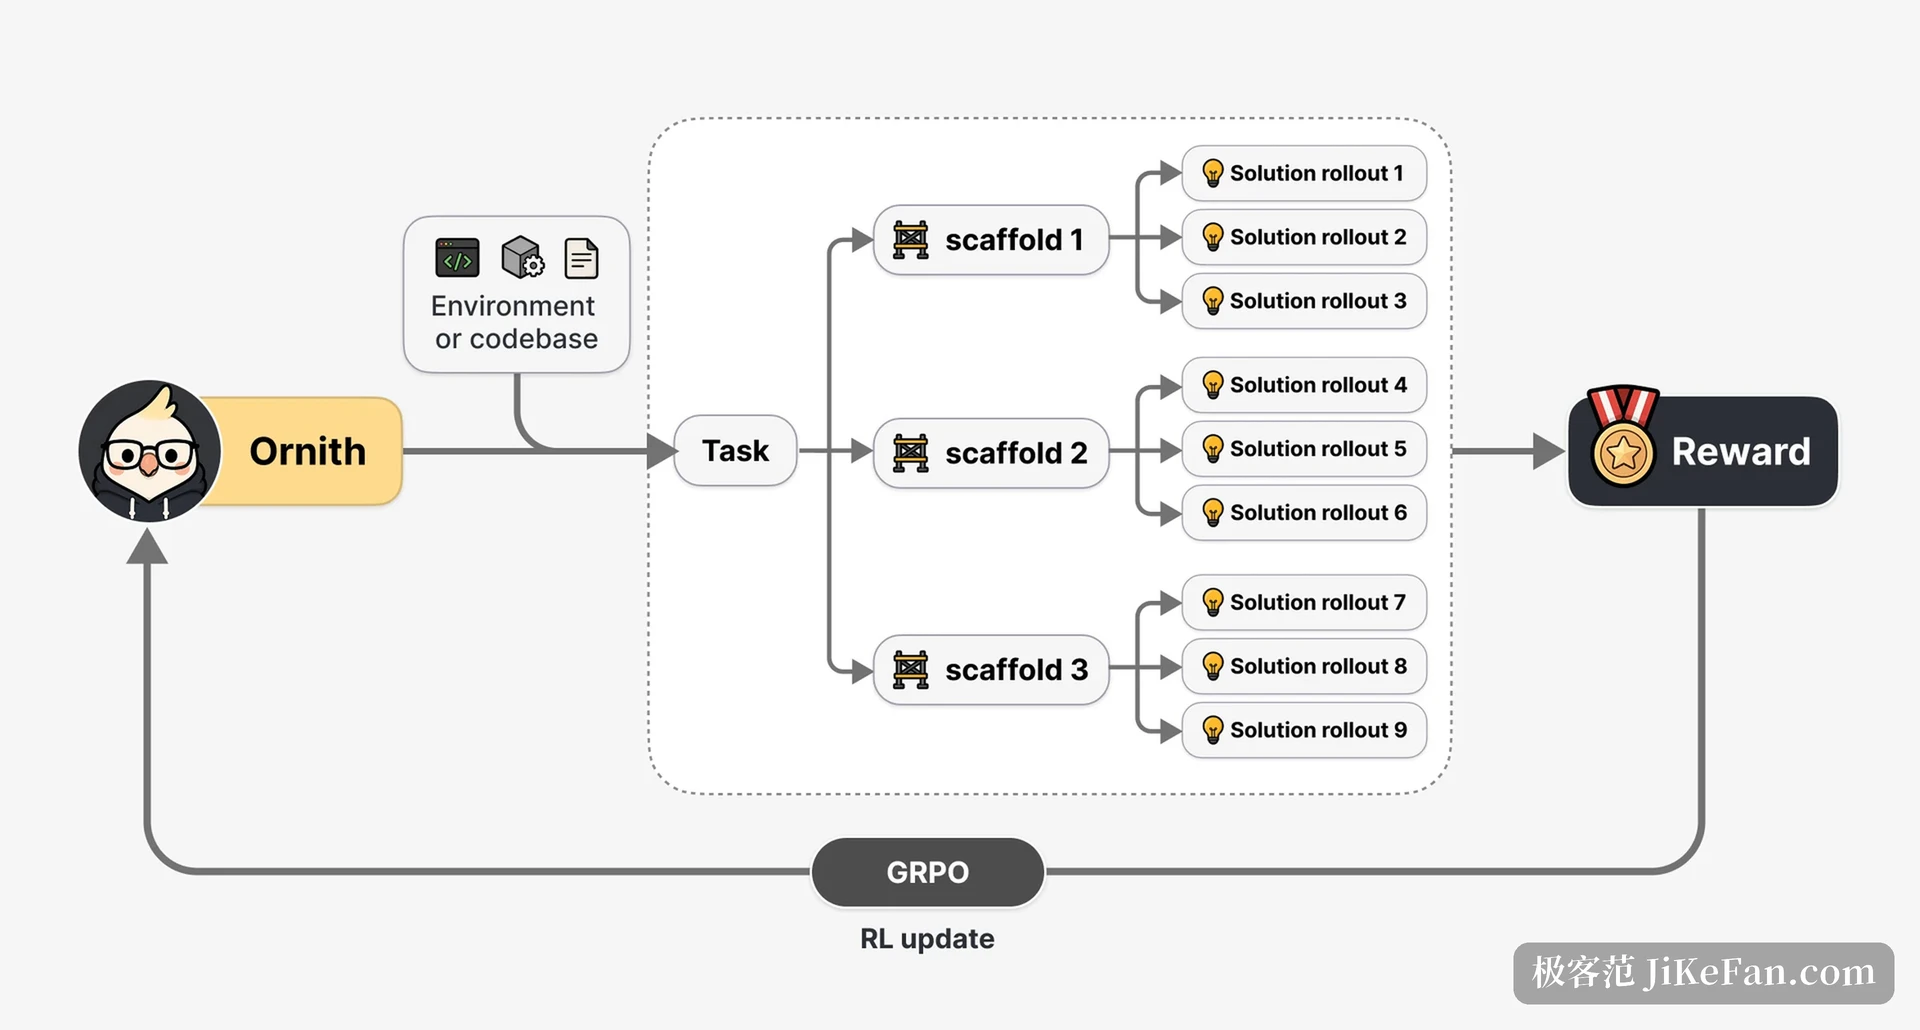
과제를 내는 방식, 세 보상을 곱한다
모델이 스스로 과제를 내게 하면 가장 뚜렷한 위험은 무른 상대만 고르거나 비슷한 과제를 되풀이해 내는 것이다. Ornith-1.5 는 세 신호를 곱해 방향을 묶는다. 유효함, 전선의 어려움, 새로움이다. 유효함은 과제와 발판이 분명히 정해지고 확인할 수 있는 배움의 자리를 이루는지 본다. 발판이 돌지 않거나 평가 기준이 과제 규격과 맞지 않으면 이 항목이 곧바로 영이 되고 과제 전체의 보상도 사라진다.
전선의 어려움은 모델이 그 과제에서 실제로 성공하는 비율로 어림한다. 비율이 0.2 에 가까울수록 어려움 보상이 높고, 모델이 그 종류를 갈수록 확실히 풀면 그 과제의 보상은 스스로 내려가 과제를 내는 방향이 더 어려운 쪽으로 밀린다. 새로움은 되풀이를 누르기 위해 지금 과제와 지난 과제의 완충 사이의 가장 큰 비슷함을 거꾸로 세어 매긴다. 셋을 곱한다는 것은 확인할 수 있고 버거우며 되풀이가 아닌 과제만 보상을 받는다는 뜻이다.
세 규모와 공식 평가
Ornith-1.5 는 세 규모를 내어 데이터 센터에서 단말까지 온 구간을 덮는다. 397B 전문가 혼합 판은 최상위 상황을 향하고, 35B-A3B 판은 기호 하나에 약 3B 값만 움직이며, 9B 빽빽한 판은 카드 한 장과 가장자리 기기를 향한다. 앞 세대의 Ornith-1.0 은 이 셋 말고도 31B 빽빽한 모델을 하나 더 내놓았다. 가족의 확인점은 같은 OpenAI 호환 접점을 함께 쓴다.
규모
Terminal-Bench 2.1
SWE-bench Verified
하드웨어
397B MoE
86.1
86.0
여러 카드 노드
35B-A3B MoE
68.5
79.0
중간 규모 팀
9B Dense
47.0
70.6
한 장과 단말
이 가운데 9B 판에서는 값을 줄인 Mobile 판이 갈라져 나오고, 파는 쪽은 iPhone 과 Android 기기에서 바로 돈다고 한다. 세 모델 모두 256K, 곧 262,144 기호의 문맥 창을 지원하고 YaRN 배율 4.0 을 쓰면 약 백만 기호까지 늘어난다.
어떻게 돌리는가, 자체 추론과 공개 허가
Ornith 가족은 추론 모델이라 기본으로 조수의 답이 먼저 think 추론 덩어리를 내고 그다음 최종 답을 낸다. 공식 조리법은 이 생각의 사슬을 따로 된 항목으로 돌려주고 도구 호출 해석도 열어 두어, 여러 대리인 편성 틀에 붙이기 쉽다.
돌리는 방식에서 Ornith 는 맡겨 쓰는 접점도 값표도 없고, 모든 능력이 모델 가중치로 나와 직접 배치해야 한다. 파는 쪽은 vLLM 과 SGLang 같은 추론 더미의 배치 조리법을 주고 긴 문맥을 위한 전용 설정도 내놓았다. 값을 줄인 형식은 GGUF 와 MLX 를 덮어 llama.cpp 와 Ollama 로 이 기계에서 돌릴 수 있다.
가중치는 MIT 허가로 나오고, 파는 쪽은 세계 어디서나 얻을 수 있고 지역에 묶이지 않는다고 설명한다. 연구 용도와 상업 배치 모두 따로 허락받는 단계가 필요 없다.
Ornith 는 무엇을 훈련할지와 어떻게 훈련할지를 함께 모델 스스로에게 맡긴다. 과제 내기와 발판 세우기, 풀이 쓰기가 닫힌 순환을 이루고 유효함과 어려움, 새로움을 곱한 보상이 방향을 묶는다. 세 규모로 데이터 센터에서 휴대전화까지 여러 하드를 덮고, MIT 허가와 순전한 자체 배치로 쓰는 자유를 온전히 얻는다.