
DBeaver Community, 다루는 데이터베이스를 한 창에 모아
요약
관계형과 비관계형 데이터베이스를 같은 클라이언트에서 다루며, 브라우저와 SQL 편집기, 결과 창이 한 창에 모인다. 표와 텍스트 파일 가져오기와 내보내기가 되고, 모델링에서는 표와 관계를 끌어다 배치한다.
추천- 이름
- DBeaver Community 데이터베이스 관리
- 버전
- 26.2.1
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsmacOSLinux
- 공식 사이트
- https://dbeaver.io/
- 업데이트
- 2026-10-14 22:00
문제는 좀처럼 데이터베이스 하나로 끝나지 않는다
데이터를 상대로 일하는 사람은 시간이 지나면 작은 컬렉션을 갖게 된다. 운영 환경은 한 엔진, 로컬 복사본은 다른 엔진, 고객 프로젝트는 또 다른 엔진, 거기에 누군가 보낸 표 하나가 더해져 무언가에 넣어야 조회할 수 있다. 흔한 답은 엔진마다 다른 클라이언트를 쓰는 것이고, 각자 단축키도 다르고 결과를 어디에 두는지에 대한 생각도 다르다. DBeaver Community는 반대로 간다. 하나의 프로그램이 모두와 대화하므로 한 데이터베이스에서 익힌 손버릇이 다음으로 그대로 옮겨 간다.
데이터베이스의 논리대로 짜인 창
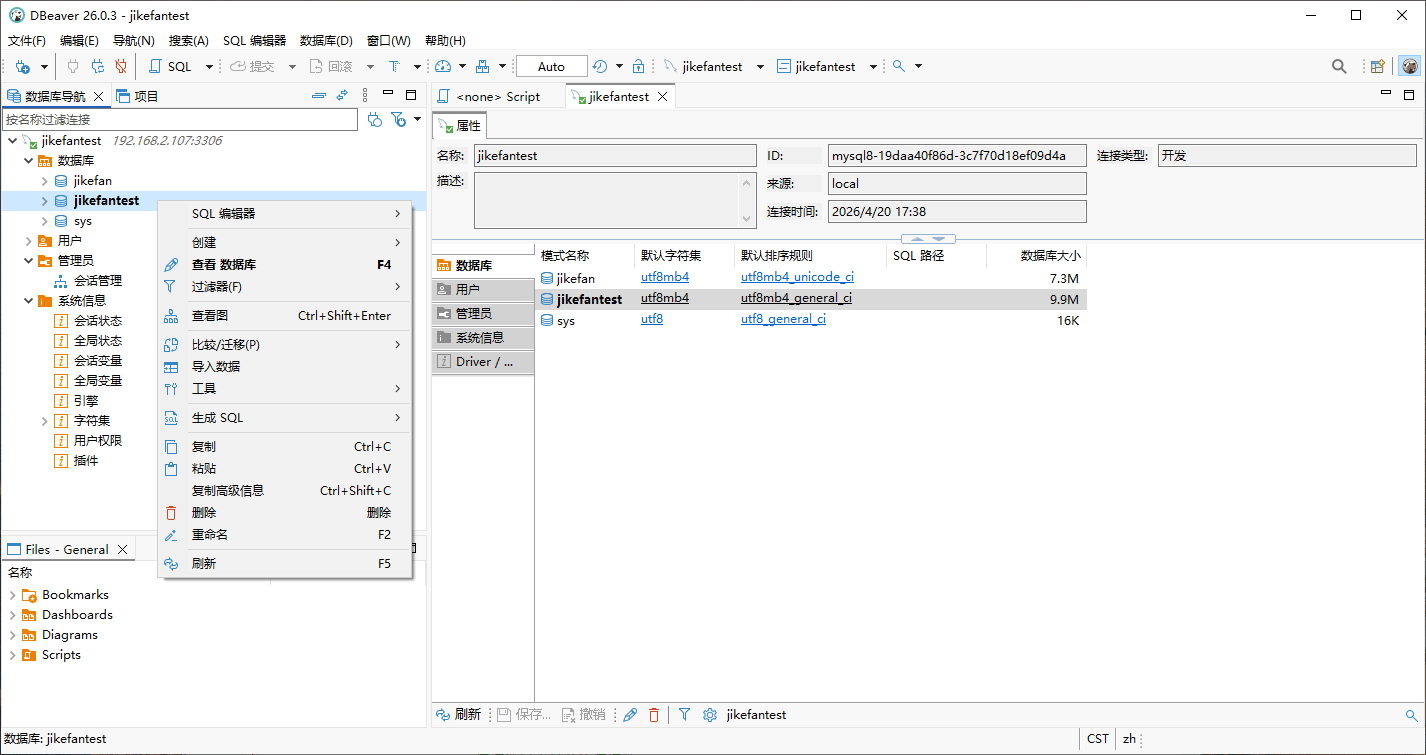
기본 창은 일의 흐름을 따른다. 한쪽에는 브라우저가 있어 연결, 스키마, 표를 나무로 보여 주므로 질의를 쓰지 않아도 데이터의 모양이 보인다. 가운데는 SQL 편집기다. 그 아래나 옆에 결과 창이 온다. 작업 중에 이 셋 사이를 끊임없이 오가므로, 그것들이 같은 자리에 있다는 것은 답이 질문 옆에 나타난다는 뜻이고, 먼저 배치를 맞춰야 하는 다른 창에 나타난다는 뜻이 아니다. 오른쪽 클릭 메뉴와 도구 모음에는 자주 반복하는 작업이 실려 있다. 표를 열고, 행을 걸러 내고, 값을 고치고, 있어서는 안 될 데이터를 지우는 일이다.
관계형과 비관계형을 같은 자리에
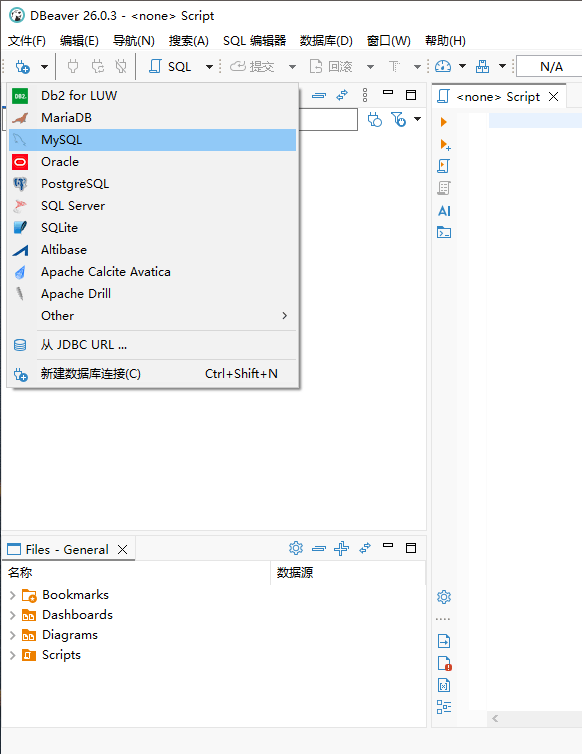
지원 엔진 목록이 많은 사람에게 설치 이유가 된다. MySQL, PostgreSQL, Oracle 같은 관계형 체계가 들어 있고 MongoDB나 Cassandra 같은 비관계형 저장소도 마찬가지다. 이 혼합은 실무에서 값을 한다. 현대의 시스템은 한 분류에 머무는 일이 드물다. 이전 작업은 옛 엔진에서 읽어 새 엔진에 쓴다. 설계 회의에서는 관계형 스키마를 유연한 부분을 맡는 저장소와 나란히 놓고 본다. 둘 다 같은 클라이언트에서 닿는다면 그런 일은 상황을 갈아타는 연속이 아니라 탭 두 개가 된다.
하루 종일 질의를 쓰는 사람을 위한 편집기
구문 강조는 최소한의 조건이고 갖춰져 있다. 더 쓸모 있는 것은 스키마를 아는 자동 완성이라 표와 열 이름을 외우지 않아도 나타난다. 정리 기능은 디버깅 중에 옆으로 자란 질의를 다듬어 다음 날 아침에도 읽히게 만든다. 엔진마다 방언이 있고 편집기는 지금 쓰는 쪽을 따른다. 서로 바꿔 쓸 수 있는 척하지 않는다. 하루가 질의의 연속인 사람에게 이것은 사치가 아니라, 한 번 쓰고 끝나는 일과 이름을 잘못 써서 다시 쓰는 일의 차이다.
데이터를 들이고 내보내기
가져오기와 내보내기는 데이터베이스 도구가 자리를 얻는지, 귀찮은 일이 되는지의 갈림길이다. DBeaver는 CSV와 표 형식을 읽고 같은 형식으로 되쓰며 그 사이에 열 대응을 한다. 데이터가 오가는 두 방향을 정확히 덮는다. 남의 파일이 행이 되고, 행이 남을 위한 파일이 된다. 큰 양을 다루는 사람에게 스크립트가 아니라 클라이언트 안에서 한다는 것은 실행 전에 대응을 확인할 수 있다는 뜻이고, 오후 하나를 아끼는 부분이 바로 거기다.
스키마는 설명하지 말고 그린다
시각적 모델링은 늦게 발견하고 나서 놓지 못하는 기능이다. 표, 관계, 제약을 끌어다 놓을 수 있어서 스키마는 읽는 문장이 아니라 보는 것이 된다. 이 방식으로 데이터베이스의 새 영역을 설계하면 문제가 일찍 드러난다. 빠진 외래 키는 그림에서는 뚜렷하고 명령 목록에서는 보이지 않는다. 같은 그림은 대화에서도 쓸모가 있다. 정의를 인용하는 것보다 상자를 가리키는 쪽이 의견 차이를 더 빨리 정리한다.
기본 목록이 끝나면 밖으로 연결한다
여기서 개방성은 라이선스만의 문제가 아니다. 프로그램이 오픈소스라서 연결 계층을 넓힐 수 있고, 처음부터 들어 있지 않은 데이터베이스의 드라이버를 더할 수 있다. 드문 엔진이나 프로토콜이 바뀐 판을 쓰는 팀은 제공자가 알아차리기를 기다리지 않는다. 작은 확장도 같다. 특정 작업 흐름에 맞는 도구는 요청으로 올리는 대신 끼워 넣는다.
왜 결국 어디에나 설치되는가
수백만 명이 쓴다는 말은 중요한 의미에서는 확인이 된다. 개발자, 데이터베이스 관리자, 분석가라는 꽤 다른 일을 하는 세 집단의 기계에 동시에 깔려 있기 때문이다. 개발자는 편집기와 결과 표를 원한다. 관리자는 연결과 권한, 그리고 표에 실제로 무엇이 있는지 보는 수단을 원한다. 분석가는 데이터의 일부를 밖으로 꺼내고 싶어 한다. 하나의 클라이언트가 셋 모두에 응하기 때문에 누군가 명령하지 않아도 조직 안으로 퍼진다.
무료이고, 환경을 가리지 않고, 범위에 솔직하다
비용이 들지 않고 Windows, macOS, Linux에서 돈다. 여기서 설명하는 것은 커뮤니티 판이다. 더 많은 것을 필요로 하는 팀을 위해 무거운 판도 있고, 무료 판이 정말 쓸 만하게 남아 있다는 점이 이 도구를 개인의 손에 붙잡아 둔다. 비즈니스 인텔리전스 체계를 대체하지 않고 그렇게 이름 붙이지도 않는다. 하는 일은 더 좁고 더 자주 필요하다. 눈앞의 데이터베이스에 연결하고, 질의를 쓰게 하고 확인하며, 데이터를 들이고 내보내고, 스키마의 모양을 보여 준다.
어디서 시작할까
합리적인 첫걸음은 이미 아는 데이터베이스 하나에 연결해 그날은 브라우저만 쓰는 것이다. 다음에 편집기를 열고 평소 다른 곳에서 쓰던 질의를 써 본다. 두 번째 걸음은 이해하는 스키마로 모델링 보기를 시험하는 것이다. 도구가 단순한 질의 화면과 다르게 느껴지는 지점이 거기다. 나머지는 이 두 습관에서 자연스럽게 나온다.