
-
RVC transforme une voix enregistrée en une autre, avec dix minutes d'audio
Un cadre libre pour convertir le timbre d'une voix et la changer en direct. Il demande au moins dix minutes de parole propre pour l'entraînement, atteint 170 millisecondes de latence de bout en bout et fournit deux interfaces.
-
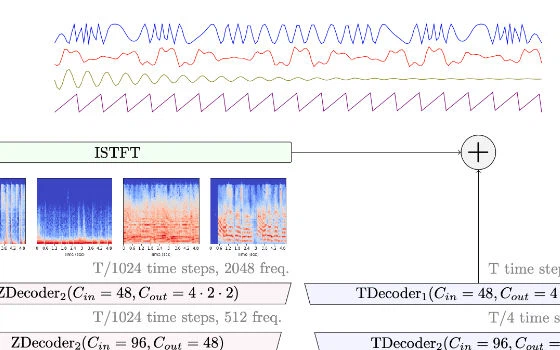
Demucs sort quatre pistes d'un morceau en une ligne de commande
Un modèle libre de séparation de sources qui découpe un morceau mixé en batterie, basse, voix et accompagnement restant. Une seule ligne de commande suffit, Python peut l'appeler, et le code est sous MIT.
-
Ultimate Vocal Remover sépare voix et instrumental, sans rien préparer
Un outil libre qui découpe un morceau en voix et accompagnement grâce à des modèles de séparation de sources. Le paquet officiel embarque l'interface, Python, PyTorch et les dépendances : rien à préparer en amont.
-
WhisperX ajoute l'horodatage au mot et l'étiquette du locuteur
Une chaîne qui comble deux manques de Whisper : l'horodatage s'arrête à la phrase et le traitement par lots n'existe pas. WhisperX aligne de force pour dater chaque mot, étiquette les locuteurs et annonce 70 fois le temps réel sur large-v2.
-
Buzz garde la transcription sur votre machine, Whisper travaille dessous
Un outil de bureau qui transcrit et traduit l'audio sur votre propre ordinateur, Whisper en dessous. Il accepte fichiers et liens, transcrit en direct depuis un micro, distingue les voix et exporte texte brut, SRT et VTT.
-
Whisper existe en six tailles, et la mémoire graphique tranche
Un modèle de reconnaissance vocale généraliste qui enchaîne transcription, traduction vers l'anglais et détection de langue. Six tailles vont d'environ 39 millions à environ 1,55 milliard de paramètres, code et poids sous licence MIT.
-
IndexTTS s'installe chez soi et laisse régler émotion et débit par paramètre
Un système de synthèse vocale zero shot à faire tourner sur sa propre machine. Un seul extrait de référence suffit pour cloner une voix, l'émotion, le débit et la prononciation restent des paramètres, et les poids relèvent d'une licence propre au projet.
-
F5-TTS livre du code MIT et des poids non commerciaux, installés en une ligne pip
Un projet open source de synthèse vocale fondé sur le flow matching, avec paquet pip, inférence en ligne de commande et interface web Gradio. Le code est en MIT, les poids pré-entraînés sont non commerciaux à cause des données d'entraînement.
-
CosyVoice couvre 9 langues et 18 dialectes chinois, avec clonage zéro-shot
Un modèle de synthèse vocale open source dont la dernière génération gère le clonage zéro-shot interlangue, 9 langues étrangères et plus de dix dialectes et accents chinois, publié sous licence Apache 2.0.
-
GPT-SoVITS affine un modèle vocal avec une minute d'audio, cinq secondes en zéro-shot
Une interface Web de synthèse vocale open source. Cinq secondes d'une voix humaine suffisent en zéro-shot, une minute de données d'entraînement permet d'affiner un timbre plus proche, et l'inférence traverse cinq langues dont le mandarin, l'anglais, le japonais, le coréen et le cantonais.
-
第 1 / 1 页