
DupeGuru : trouver les doublons est de l'arithmétique, supprimer est un jugement
Résumé
DupeGuru est un chercheur de doublons gratuit pour Windows, macOS et Linux : désigner un dossier ou un disque, comparer par nom, taille et contenu, puis décider soi-même quelles copies partent.
Recommander- Nom
- DupeGuru
- Version
- 4.3.1
- Tarif
- Gratuit
- Open source
- Open source
- Mis à jour
- 2026-10-06 22:15
Personne ne crée de doublons exprès
DupeGuru est un outil gratuit pour trouver les fichiers en double et les éliminer afin de récupérer de l'espace disque, et il fonctionne sous Windows, macOS et Linux. Avant le programme vient pourtant la question de l'origine des doublons, car personne ne les fabrique volontairement. Ils s'accumulent : un dossier copié sur un disque puis recopié en arrière, un téléchargement refait deux fois parce que le premier avait été oublié, une photothèque importée deux fois sous des noms de dossiers différents, un projet archivé avant et après une petite modification. Chaque geste pris seul était raisonnable, et la somme est un disque où un cinquième de l'espace contient deux fois les mêmes octets.
Ce que fait l'outil est de l'arithmétique : désigner des dossiers ou un disque entier, laisser comparer, et il rend des groupes de fichiers identiques. Ce qu'il ne peut pas faire, c'est décider. Cette partie reste à la personne, et la qualité du résultat dépend bien plus de ce jugement que de la vitesse de la recherche.
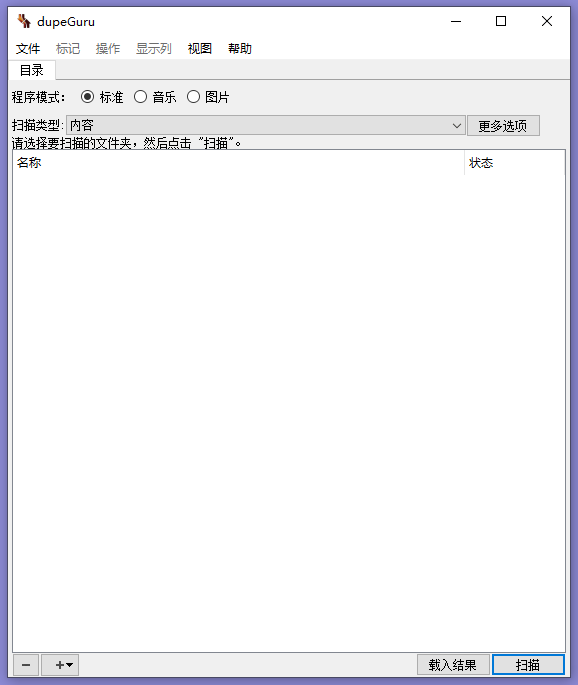
Trois façons de comparer, par vérité croissante
La comparaison porte sur les noms, les tailles et les contenus, et il vaut la peine de comprendre que ces trois éléments ne sont pas également fiables. Le nom est la preuve la plus faible qui existe : le même fichier renommé deux fois ressemble à deux fichiers, et deux fichiers complètement différents portant le même nom ressemblent à des doublons. La taille est bien plus forte, car deux fichiers de même longueur sont au moins plausiblement liés, et c'est aussi le contrôle le moins coûteux, ce qui explique que tout outil sérieux s'en serve comme première barrière.
Le contenu est la seule vraie réponse, et lire chaque octet de chaque fichier est bien trop lent. La solution habituelle est un condensat : une empreinte calculée à partir du contenu, assez courte pour être comparée et assez spécifique pour que deux fichiers différents n'en partagent pas une. Le calculer seulement pour les fichiers dont la taille correspond déjà transforme une recherche de plusieurs heures en quelques minutes.
La subtilité restante : les contenus peuvent être identiques alors que les fichiers ne sont pas interchangeables. Deux photographies qui se ressemblent diffèrent par leurs métadonnées ; deux documents qui se lisent pareil diffèrent par leur historique de révision. Une comparaison de contenu est une affirmation sur des octets, et ce que ces octets signifient est une question séparée, à laquelle il faut encore répondre avant de supprimer quoi que ce soit.
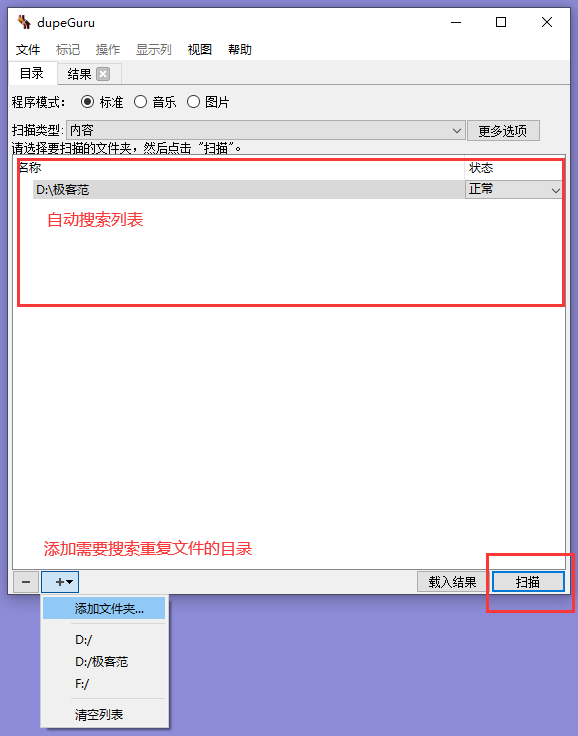
Quelle copie garder est une décision, pas un calcul
Chaque groupe de doublons pose la même question, et il n'y a pas de réponse universelle. La copie située dans le dossier réellement sauvegardé vaut plus que celle du bureau. La copie avec l'horodatage d'origine vaut plus que celle dont la date a été réécrite par un transfert. La copie vers laquelle un autre document pointe vaut plus que celle que rien ne référence. Un outil peut exposer tout cela — le chemin, la date, la taille — mais il ne peut pas le peser, parce que les poids vivent dans la tête de la personne.
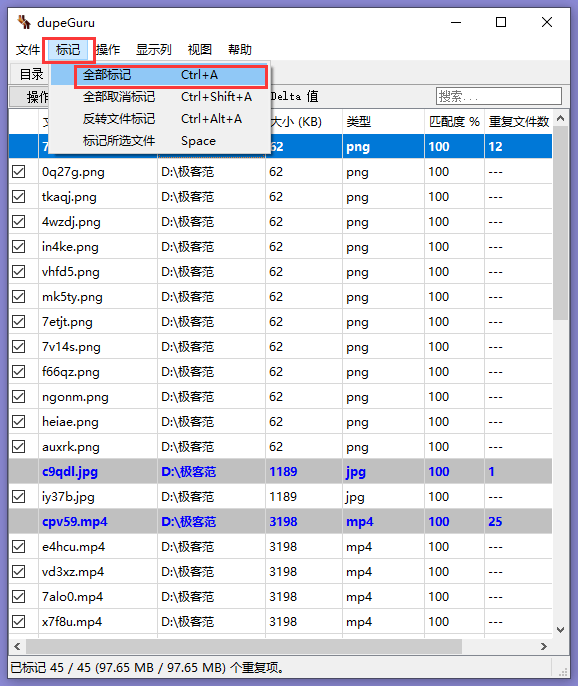
C'est pourquoi les options manuelle et automatique ne devraient pas être traitées comme équivalentes. La suppression automatique est une vraie économie de travail quand la recherche était étroite et la règle évidente ; c'est une catastrophe quand un dossier d'exports presque identiques est aplati parce que la règle était généreuse. Le schéma qui survit au contact du réel est simple : garder la première passe petite et ennuyeuse, regarder les groupes, et supprimer d'une manière qui laisse une trace.
Trier les résultats fait partie de l'analyse
Pouvoir sauter directement aux fichiers les plus gros ou les plus petits de la liste semble une commodité et constitue en réalité une stratégie. Les plus gros doublons sont là où se trouve l'espace ; si l'objectif est la capacité, le travail commence donc là. Les plus petits sont en général les restes d'une centaine de téléchargements, et les enlever relève du rangement plutôt que du besoin. Trier par taille transforme une longue liste indifférenciée en ordre de priorité, et la priorité est ce qui rend un nettoyage terminable.
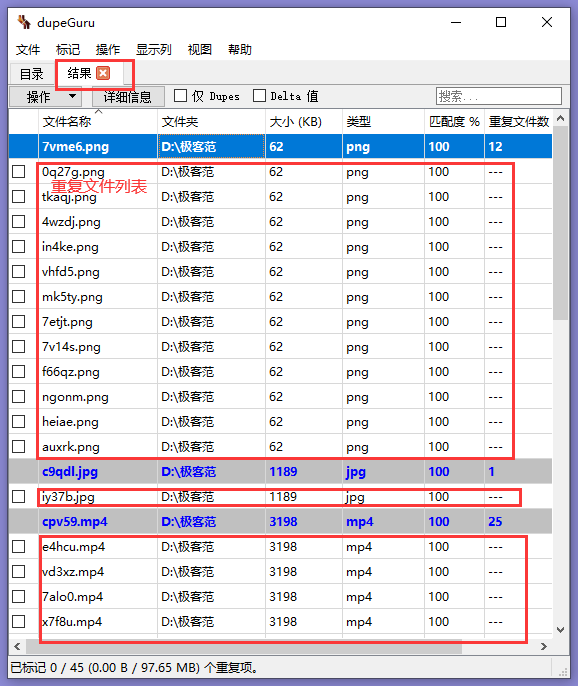
Les exclusions tiennent une recherche honnête
Pouvoir ignorer des dossiers et des fichiers, et exclure certains types de fichiers, n'est pas un détail. Certains répertoires ne doivent pas être touchés du tout : dossiers système, images de machines virtuelles, stockage de conteneurs, structure interne d'une photothèque ou d'une base de courrier, où une partie supprimée signifie une application cassée. D'autres contiennent des fichiers qui ressemblent à des doublons sans en être : les liens durs, où un second nom n'est qu'une autre porte vers les mêmes données et où supprimer une porte ne libère rien.
Exclure par type est l'autre moitié utile. Les fichiers multimédias méritent l'analyse, car une vidéo en double est vraiment de l'espace perdu ; les petits fichiers de configuration et les vignettes valent rarement le risque, car ils sont identiques pour de bonnes raisons et quelque chose dépend peut-être de l'existence de chacun.
Ce que la suppression fait réellement à un système de fichiers
Il aide de savoir ce qui est gagné. Retirer un doublon libère l'espace qu'occupait ce fichier, et rien d'autre ; cela ne rend pas la copie restante plus rapide à lire, et sur un disque à mémoire flash cela ne rend même pas la machine plus vive, car le disque n'a jamais été ralenti par la copie supplémentaire. Le gain est en capacité et en clarté de l'arborescence, pas en performance, et attendre le mauvais bénéfice est la raison pour laquelle on finit déçu par une tâche qui a fonctionné exactement comme prévu.
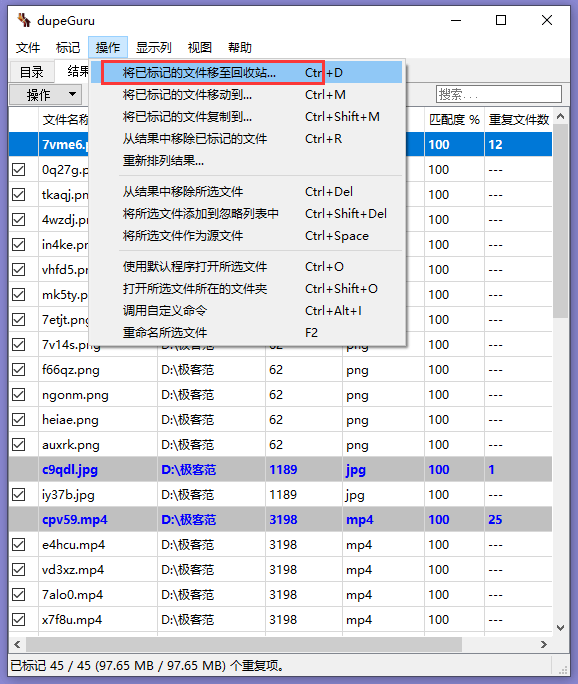
L'autre chose à savoir : la suppression est ici généralement celle de tous les jours, ce qui signifie que les fichiers partent dans un endroit récupérable plutôt que de disparaître. C'est une consolation, mais cela veut aussi dire que l'espace n'est réellement rendu qu'une fois la corbeille vidée — et c'est cette étape qui transforme une liste bien tenue en gigaoctets disponibles.
Là où il trouve sa place
Ce n'est ni un analyseur de stockage ni un outil de sauvegarde. Il répond bien à une seule question : lesquels de ces fichiers sont le même fichier. Pour une collection de photos importée deux fois, un dossier de téléchargements devenu décharge, ou un disque qui s'est rempli sans qu'arrive rien de visiblement nouveau, cette question unique est la bonne. Gratuit, libre et disponible sur les trois systèmes de bureau, c'est le genre d'utilitaire qui reste inutilisé un an puis fait gagner un après-midi.