
Baidu Comate : un assistant de code IA qui vit dans l'éditeur
Résumé
Baidu Comate est un assistant de code IA fondé sur le modèle de langage de Baidu, proposé en greffon pour les IDE courants : complétion, génération à partir de commentaires, tests unitaires, refactorisation, explication et questions techniques.
Recommander- Nom
- Baidu Comate
- Version
- 20240514
- Tarif
- Payant
- Open source
- Propriétaire
- Mis à jour
- 2026-10-06 08:39
Un assistant en greffon, pas une destination
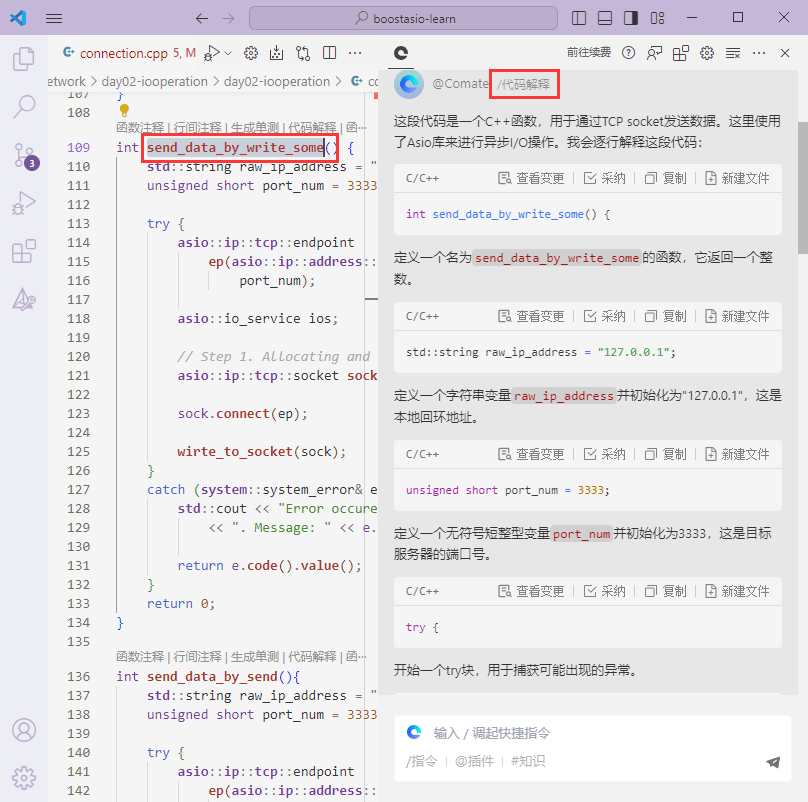
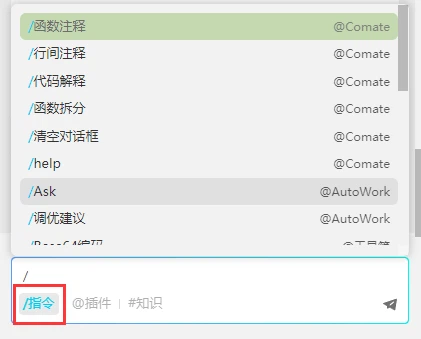
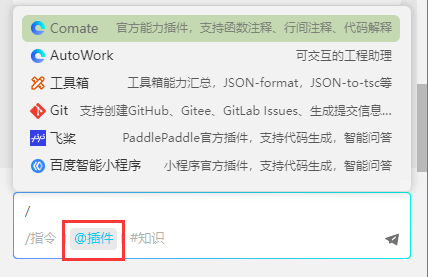
Baidu Comate est un assistant de code IA fondé sur le modèle de langage de Baidu, entraîné à la fois sur du code open source public et sur les données accumulées par l'entreprise au sujet du travail de développement réel. La décision décisive tient à la livraison : il arrive sous forme de greffon pour les environnements de développement que les gens utilisent déjà — Visual Studio Code, IntelliJ IDEA, PyCharm, GoLand, WebStorm, CLion, PhpStorm, Android Studio entre autres — plutôt que comme une application séparée avec son propre éditeur.
Ce choix n'est pas cosmétique. Un assistant de code n'est utile que s'il voit le contexte dans lequel le code s'écrit, et un éditeur séparé doit tout se faire raconter depuis le début. Vivre dans l'environnement existant signifie que l'assistant hérite gratuitement des fichiers ouverts, de la structure du projet et de la position du curseur, et que le développeur garde ses raccourcis, sa configuration de débogage et ses habitudes.
Complétion et génération sont deux promesses
Un tel outil sait faire deux choses, souvent confondues. La complétion propose le prochain jeton, la fin d'une ligne, le corps d'un bloc qu'on vient d'ouvrir : elle continue ce qu'on est déjà en train d'écrire, et sa valeur vient de ce qu'elle devine juste sur le futur immédiat. La génération produit une fonction entière à partir d'une description, et sa valeur vient de ce qu'elle comprend correctement l'intention.
Les deux reposent sur le même mécanisme, la prédiction sur une fenêtre de contexte, et partagent le même défaut : le modèle est fluide sur des choses qui n'existent pas. Une complétion qui invente le nom d'une méthode sur une bibliothèque à moitié mémorisée est pire que pas de complétion, car la lire coûte de l'attention et la tester coûte du temps. L'habitude qui rend ces outils rentables n'est pas d'accepter plus de suggestions, c'est de les lire.
Écrire d'abord le commentaire
Générer du code à partir d'un commentaire ressemble à un tour de passe-passe et constitue sans doute la façon la plus disciplinée d'employer un tel modèle. Un commentaire qui dit ce qu'une fonction doit faire, ce qu'elle reçoit et ce qu'elle renvoie est une spécification en miniature ; l'écrire d'abord force la réflexion qu'on saute d'habitude, et le corps généré devient un brouillon qu'on peut confronter à la phrase au-dessus.
Un second avantage s'oublie facilement : la spécification survit. Les lecteurs suivants reçoivent la phrase qui explique l'intention, pas seulement le code qui l'implémente par hasard. Que le corps ait été écrit par une personne ou suggéré par un modèle compte bien moins que la véracité de la phrase au-dessus.
Les tests unitaires sont la meilleure cible possible
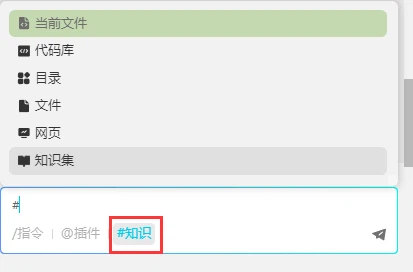
De tout ce que produit cette catégorie d'outil, les tests sont ce qui se défend le mieux. La raison est structurelle et non technique : un test est exécutable et rend un verdict. Une fonction suggérée peut être plausible et fausse sans que personne ne le remarque pendant un mois ; un test suggéré passe au vert ou non, et dans les deux cas on a appris quelque chose en quelques secondes.
Pouvoir générer des tests pour une seule fonction, ou par lots sur un module, change l'économie d'une tâche chroniquement sautée. Les tests sont la première chose abandonnée sous pression d'un délai, parce qu'ils sont fastidieux et que leur absence ne se voit que bien plus tard. Un outil qui produit un premier jet — les cas évidents, les bornes, une ou deux entrées délibérément inconfortables — transforme une heure d'ennui en dix minutes de relecture et de complément. La relecture n'est pas optionnelle : les tests générés vérifient souvent ce que le code fait plutôt que ce qu'il devrait faire, ce qui décrit le défaut dès que le défaut existe.
Suggestions de refactorisation et le problème de l'équivalence
L'outil repère ce que le métier appelle des mauvaises odeurs — des fonctions devenues trop longues, des conditions imbriquées qu'on pourrait aplatir — et propose une restructuration, par exemple la division d'une longue fonction en plusieurs au nom clair. Comme manière de voir la forme d'un problème, c'est réellement utile : une fonction longue est difficile à lire précisément parce que ses parties n'ont pas de nom.
Le risque mérite d'être énoncé clairement. Une refactorisation n'est correcte que si le comportement est inchangé, et un modèle n'a aucun moyen de le garantir. Il peut produire du code qui se lit admirablement et modifie subtilement un cas limite, notamment autour de la gestion d'erreur, des valeurs nulles et de l'ordre des effets de bord. C'est pourquoi l'association qui fonctionne est refactorisation plus tests : avec une suite qui échoue bruyamment, une restructuration est une proposition vérifiable en quelques secondes ; sans elle, c'est une réécriture déguisée en rangement.
Lire du code est l'autre moitié du travail
Expliquer une fonction, entière ou sur une sélection, répond à un coût facile à sous-estimer : comprendre du code écrit par quelqu'un d'autre, ou par soi-même il y a six mois. L'explication n'est pas la vérité sur le programme — c'en est une hypothèse, et le programme est la vérité — mais une hypothèse en langage ordinaire est exactement ce dont on a besoin avant de décider où regarder.
Les questions techniques fonctionnent de la même manière. Interroger un message d'erreur ou une interface renvoie immédiatement quelque chose de lisible, ce qui vaut mieux que l'ancienne boucle : chercher, ouvrir quatre onglets, reconstruire une réponse. La prudence reste la même : les réponses sur le comportement d'une bibliothèque sont celles qui se trompent avec le plus d'assurance, et la documentation reste l'autorité.
La couverture des langages est une question pratique
La prise en charge de bien plus d'une centaine de langages — du C, C++, Java, Python, Go, PHP et Rust côté serveur à HTML, JavaScript, CSS et les divers dialectes de feuilles de style et de gabarits côté client, jusqu'à Objective-C, Kotlin et Swift côté mobile — n'est pas un argument publicitaire. La plupart des projets réels ne sont pas monolingues : un dépôt contient l'application, les scripts de construction, la configuration, les migrations de base de données et la documentation, en quatre ou cinq syntaxes différentes. Un assistant qui n'en parle qu'une est un assistant qui disparaît sans arrêt.
La réserve honnête : largeur et profondeur se concurrencent. La performance est la meilleure sur les langages les plus répandus, simplement parce que les données d'entraînement y sont les plus denses, et les suggestions dans un dialecte rare se lisent avec plus de méfiance que celles en Java.
Là où il trouve sa place, et ce qu'il ne répare pas
L'outil traite les parties mécaniques de l'écriture logicielle : produire un premier jet, remplir du code répétitif, écrire les tests que personne ne veut écrire, expliquer l'inconnu. Il ne décide pas de ce que le programme doit faire et ne porte pas la responsabilité de ce qu'il produit. Deux conséquences. Tout ce qu'il émet doit être relu comme si un inconnu l'avait écrit, parce que c'est le cas ; et du code qui vient d'un modèle mérite une question que le code d'un collègue reçoit rarement — d'où vient-il, et quelle licence porte-t-il. Cette question compte dans toute organisation soucieuse de provenance, et c'est la seule qu'un assistant ne peut pas trancher à votre place.