
Strata 0.2.10 oeffnet 128K Kontext auf einer 8 GB Karte und macht Qwen3.8 lokal schneller
Zusammenfassung
Strata 0.2.10 tauscht den Standard-Spekulativdecoder gegen einen Entwurf von 625 MB und laesst eine 8 GB Karte einen 128K Kontext oeffnen, waehrend Voll-Sharding auf zwei Linux-Karten die Codebearbeitung fast verdoppelt.
Empfehlen- Name
- Strata
- Version
- 0.2.10
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsmacOSLinux
- Webseite
- https://github.com/Niko1221/Strata
- Aktualisiert
- 2026-11-03 23:00
Zwei Dinge tun am meisten weh, wenn ein grosses Modell auf dem eigenen Rechner laeuft. Das eine ist zu wenig Speicher auf der Karte fuer einen langen Kontext. Das andere ist eine Geschwindigkeit, bei der das Arbeiten keinen Spass macht. Strata 0.2.10 greift beides gleichzeitig an: der Standarddecoder fuer Spekulation wird durch einen kleinen Gehilfen von etwas ueber sechshundert Megabyte ersetzt, und eine 8 GB Karte oeffnet jetzt einen Kontext von 128K.
Was diese Fassung aendert
Strata ist ein Client fuer grosse Modelle, der auf dem eigenen Rechner laeuft, in C++ geschrieben, unter MIT-Lizenz, auf GitHub gehostet und derzeit bei knapp vierzigtausend Sternen. Die Positionierung ist eng und klar: Consumer-Hardware, zwei Zugaenge ueber eine Desktop-Anwendung und ein Terminal, nach der Installation ein Modell waehlen und mit Reden, Coden oder Bilderlesen beginnen, ohne Konto und ohne Server im Weg.
Die Versionsnummern brauchen Sorgfalt. Anwendung und Terminal stehen beide auf 0.2.10, die Steuerungskomponente und die Engine-Pakete dagegen auf 0.1.56. Die Versionshinweise nennen die Punkte sachlich: DFlash2 wird der Standardentwurf, die Engine fuer Voll-Sharding ueber mehrere Karten schaltet sich unter Linux automatisch ein, ein neues Modell namens ISTA-DAS Coder kommt dazu, der Mac kann Bilder lesen, und 128K Kontext funktioniert schon ab einer 8 GB Karte.
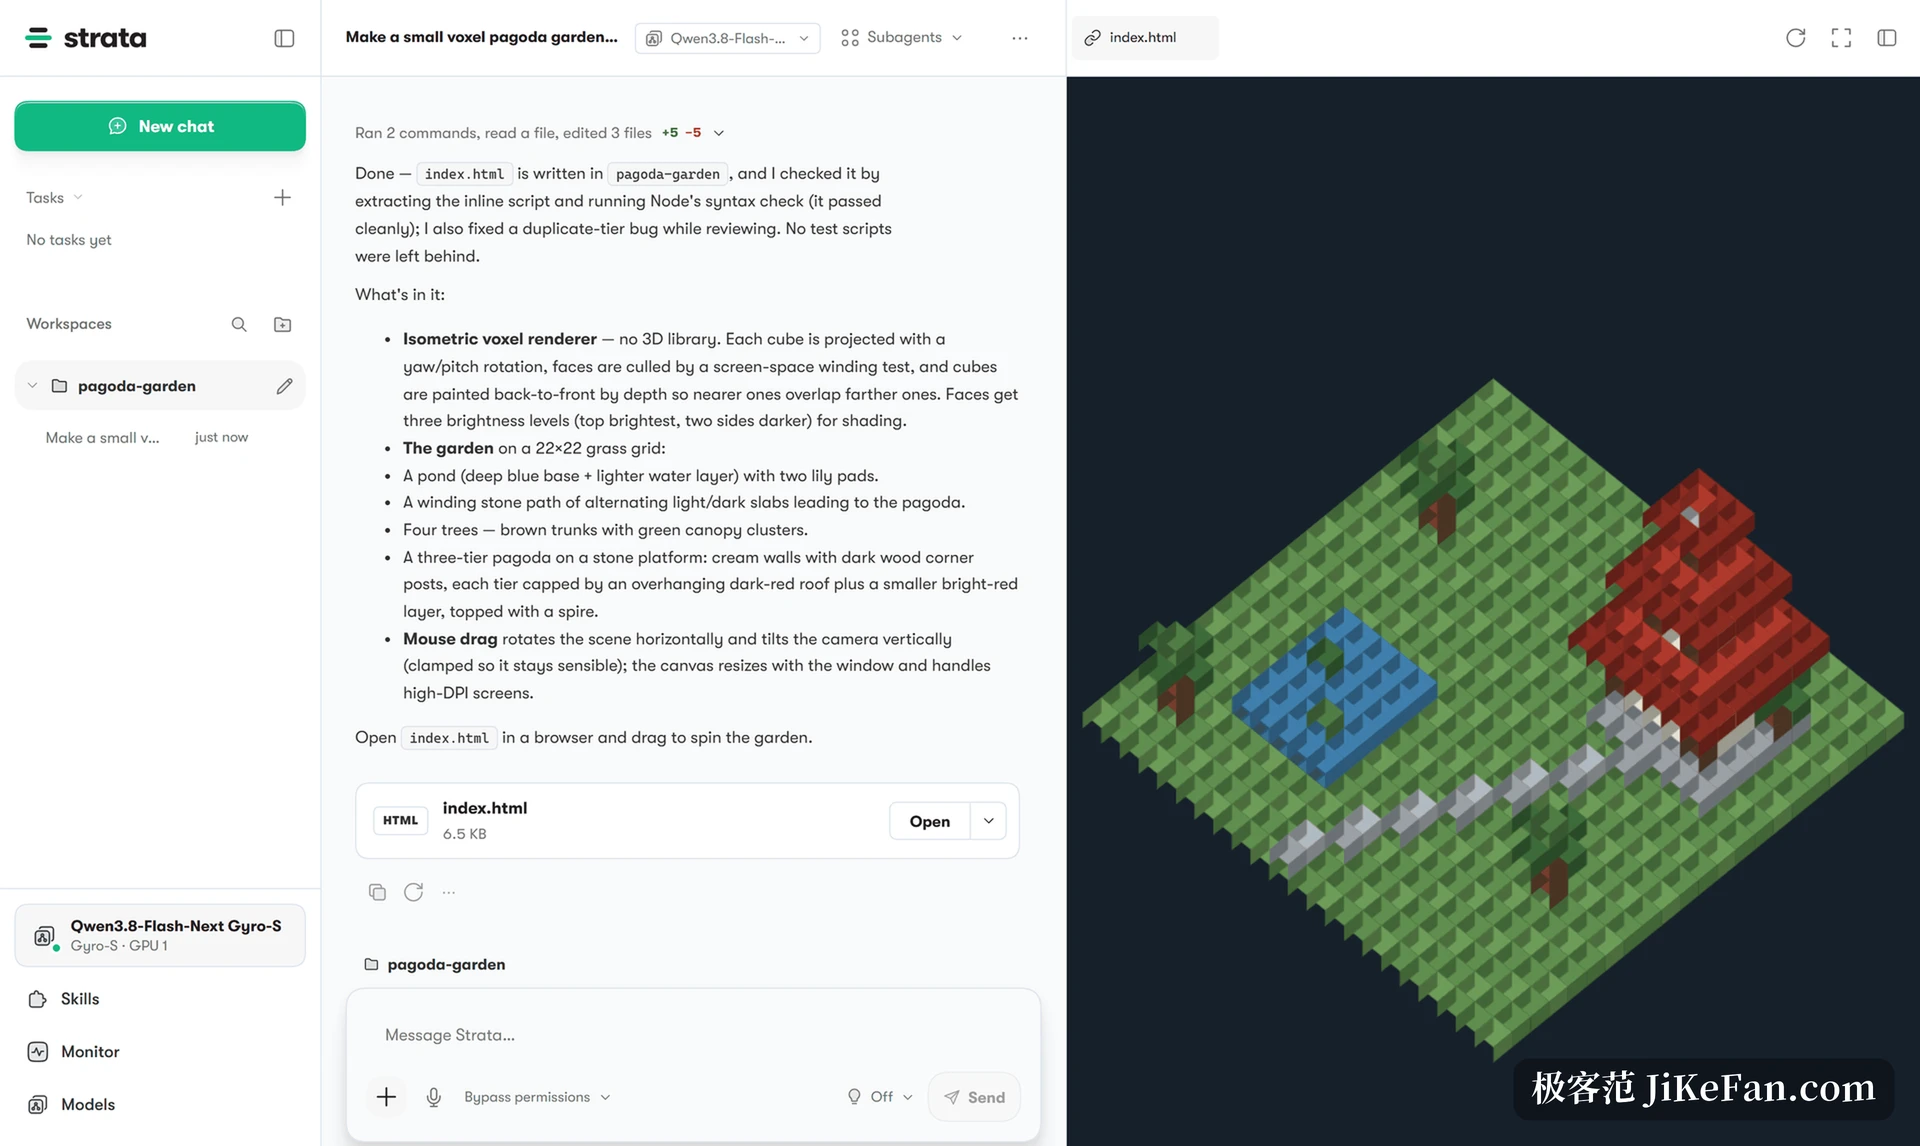
Sechshundert Megabyte ersetzen eine Spekulativschicht von fuenf Gigabyte
Spekulative Dekodierung laesst ein kleines Hilfsmodell raten, was als naechstes kommt, und das Hauptmodell prueft diese Vermutungen im Buendel; je mehr davon zutrifft, desto weniger Zeit geht in die Erzeugung Zeichen fuer Zeichen. Die vorige Fassung nutzte eine Spekulativschicht namens MTP mit etwa 5.2 GB Grafispeicher; diese nutzt DFlash2 mit rund 625 MB, und die Differenz gibt etwas ueber vier Gigabyte frei.
Der freie Speicher wird unmittelbar zu nutzbarem Kontext. Der veroeffentlichte Vergleich, gleiche Engine und gleiche Dateien: auf einer Ryzen AI Max Maschine unter Windows gewinnen kurze Antworten 12 Prozent und lange Antworten 8.8; auf einer RTX PRO 5000 mit gieriger Dekodierung 7.9; auf einem Apple M5 Max 7.4; auf einem DGX Spark 5.8. Es gibt auch einen Gegenfall, eine Intel Arc A750 laeuft 2.6 langsamer als mit MTP, und die Hinweise sagen das offen.
Der Preis ist Nebenlaeufigkeit. DFlash2 bearbeitet einen Anfrage nach der anderen, mehrere gleichzeitig bedeuten den Rueckgriff auf MTP, und dasselbe gilt, wenn die Modellfamilie nicht Qwen3.8 ist. Die automatische Wahl steckt im Programm: auf automatisch entscheidet Hardware und Szenario, eine falsche Wahl laesst sich von Hand uebergehen, und pro Lauf wird nur ein Entwurf geladen statt beide.
Wie 128K in 8 GB Grafispeicher passt
Langer Kontext frisst Cache. Auf einer 8 GB Karte scheiterte das Oeffnen von 64K oder mehr bisher beim Start, sobald der Expertencache voll war, und Nutzer fielen auf etwa 48K zurueck. Diese Fassung aendert die Platzierung der Ressourcen: wird der Grafispeicher knapp, wandern Daten dynamisch zwischen ihm und dem Arbeitsspeicher, die gewuenschte Kontextlaenge bleibt so weit wie moeglich erhalten, und notfalls laeuft ein Teil des Caches in den Arbeitsspeicher oder sogar auf die SSD.
Die gemessenen Zahlen sehen so aus: mit der Testmaschine auf die Bedingungen einer 8 GB Karte begrenzt, erzeugte Qwen3.8 in der Quantisierung IQ3_S mit 128K im DFlash2 Modus 63 bis 73 Token pro Sekunde und las einen 32K langen Prompt in 19.8 Sekunden, wobei noch 390 MB Grafispeicher frei blieben. Auf einer echten Intel Arc A750 mit 8 GB gelangen alle vier Startkombinationen fuer 128K mit 12.7 bis 14.8 Token pro Sekunde. Eine 12 GB Karte bleibt unberuehrt und behaelt ihr Tempo.
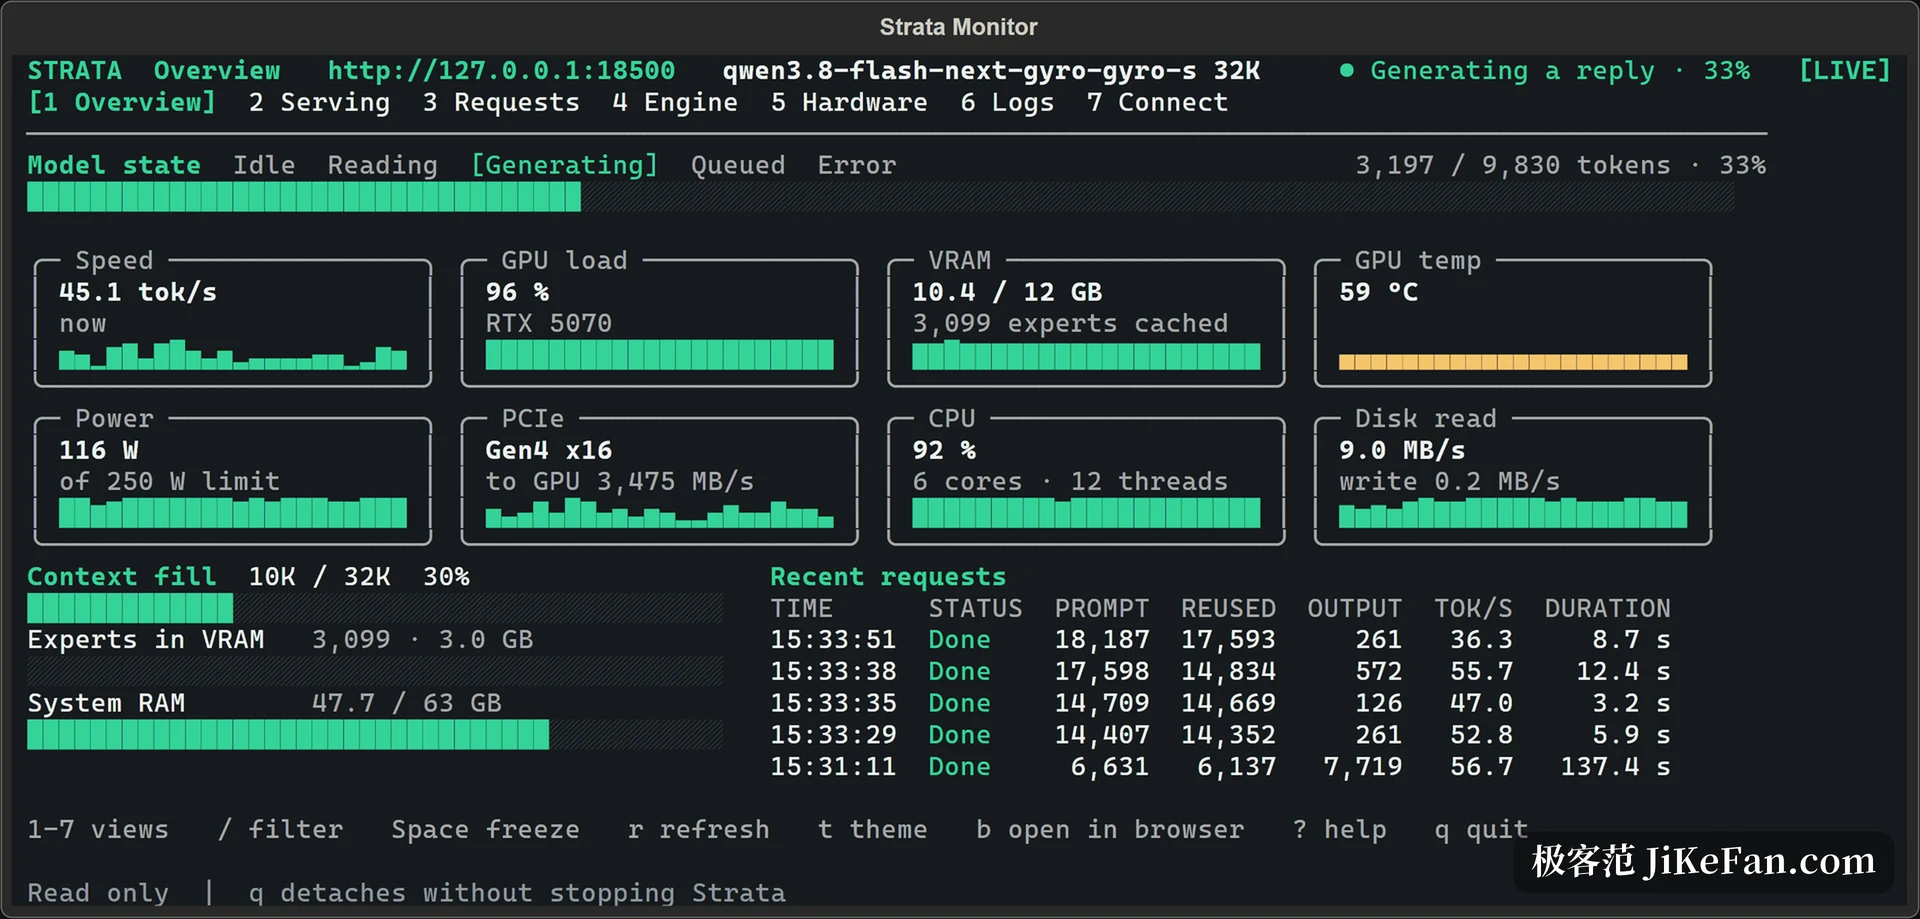
Dieser Weg hat eine Schwelle. Sobald der Druck auf Arbeitsspeicher und Platte verteilt wird, steigen die Anforderungen an den Arbeitsspeicher der Maschine, und die Faustregel aus der Gemeinschaft lautet 32 GB zum Anfangen, 48 GB um bequem zu sein, 64 GB um nicht mehr daran zu denken. Auch die Platte braucht Platz, denn die Modelldateien sind nicht klein.
Zwei Karten zusammen, und Codebearbeitung fast verdoppelt
Der alte Weg mit mehreren Karten ist die Schichtteilung: jede Karte besitzt einen Teil der Schichten und reicht das Ergebnis weiter. Diese Fassung schaltet im Linux-Terminal standardmaessig eine andere Teilung ein, Voll-Sharding genannt: jede Karte haelt ein Stueck jeder Schicht, und alle Karten lesen Gewichte und rechnen im selben Moment. Der Gewinn ist eine gleichmaessigere Verteilung des Speichers; der Preis sind staendig getauschte Zwischenergebnisse, weshalb die Bandbreite der Verbindung zaehlt.
Das Projekt hat zwei RTX A6000 unter Linux gemessen: Codebearbeitung stieg von 195 Token pro Sekunde auf 377 bis 394, neuer Code von 139 bis 144 auf 189 bis 232, gewoehnlicher Text von 93 auf 139 bis 146, und eine Agentenschleife von 112 bis 119 auf 165. Das Lesen eines langen Prompts wird etwas langsamer, ein 32K Prompt von 7.65 auf 10.1 Sekunden, also Durchsatz gegen Latenz des ersten Tokens getauscht.
Das automatische Einschalten hat strenge Bedingungen: Linux, zwei NVIDIA Karten mit Rechenleistung 8.6 oder 12.0, oder vier Radeon AI PRO R9700 mit bestimmten Quantisierungsdateien; das Modell muss Qwen3.8 sein, das die Engine verarbeiten kann; alle gerouteten Experten muessen in den Grafispeicher passen; und etwa 43 GB freier Arbeitsspeicher muessen uebrig bleiben. Sind die Bedingungen nicht erfuellt, geht es zurueck zur Schichtteilung, das Programm nennt den Grund, und abschalten laesst es sich ebenfalls.
Zwei Dinge nebenbei behoben
Das erste ist der Start unter Windows. In manchen Hintergrundstart-Szenarien wurde die Prioritaet fuer Plattenlesen so weit abgesenkt, dass das Laden des Modells deutlich langsamer wurde; diese Fassung hebt sie wieder an. Das zweite ist die Bildeingabe auf dem Mac: auf einem M5 Max wurden acht Bildanfragen achtmal richtig gelesen, die Erzeugung mit Bild lief mit 19 bis 22 Token pro Sekunde gegen 21 bis 22 bei reinem Text, der Bildturm belegte zusaetzlich 319 MB Grafispeicher, und der Speicherhoechstwert der Engine blieb bei 74 GB, also gleichauf mit dem Textfall.
Das neue ISTA-DAS Coder nimmt von den 384 Experten in DeepSeek-V4.1-Flash je Schicht 192; auf vier R9700 Karten dekodiert es mit 59.2 Token pro Sekunde, auf einer einzelnen Karte mit 22.8, und auf einem Apple M5 Max mit 19.1 bis 22.5. All diese Zahlen stammen aus den Versionshinweisen und wurden auf verschiedenen Maschinen erhoben, ein Vergleich quer darueber sagt wenig; die Groessenordnung ist der Punkt.
Wer aktualisieren sollte
Wer eine Consumer-Karte mit 8 GB bis 12 GB besitzt und einen langen Kontext will, sollte wechseln, denn damit wird ein Szenario, das gar nicht startete, zu einem, das laeuft. Wer zwei Karten hat und Qwen3.8 unter Linux faehrt, gewinnt durch Voll-Sharding ziemlich direkt. Wer nur eine grosse Karte hat und ueberwiegend redet, merkt nach dem Update vor allem, dass der erste Start etwa 1.2 GB Entwurfsdateien zusaetzlich laedt.
Eine Warnung: solche Projekte iterieren schnell, und eine Versionsnummer pro Tag ist normal. Die Dokumentation ist bei Hardware, Quantisierungsstufen und Nebenlaeufigkeit recht genau, und es lohnt sich, sie gegen die eigene Konfiguration zu lesen, statt Parameter anderer Leute zu uebernehmen.