
DeepSeek V4.1 Flash: Bilder ohne Beschreibung, eine Million Token, offene Gewichte
Zusammenfassung
Ein Modell mit fünfhundertzweiundfünfzig Milliarden Parametern, das Bildschirmausschnitte ohne Beschreibung liest, eine Million Token in einem Zug aufnimmt und zwischengespeicherte Eingabe mit einem Fünfzigstel Yuan je Million abrechnet. Bemerkenswert ist nicht die Größe, sondern wohin die Kosten gewandert sind.
- Name
- DeepSeek
- Version
- v4.1-flash
- Open Source
- Open Source
- Betriebssystem
- WebiOSAndroid
- Webseite
- https://www.deepseek.com
- Aktualisiert
- 2026-10-27 22:00
一个 552B 参数的开源模型,能直接看懂你发的图,能一口气读完百万字的长文档,而 API 的闲时缓存价已经压到每百万 token 两分钱。
2026 年 9 月 10 日,DeepSeek 发布 V4.1 Flash。官方在公告里把它定义为「全新模型结构系列中最小尺寸的模型」,同时给出的三句话是:文本与 Agent 性能全面提升、兼具原生多模态视觉理解能力、能力更强且成本更低。发布当天,它在网页端、手机 App 和 API 三端同步上线,API 里的模型名直接叫 deepseek-flash。权重以 MIT 许可放在 Hugging Face 上,可以下载、可以自部署、也可以商用。
为什么能便宜下来:读和写换成了两套参数
先看一组有点反直觉的数字。V4.1 Flash 的总参数量是 552B,另带 196B 的 Engram 参数,但真正在推理时被唤醒的只是其中一小部分——读你的输入时激活 8B,生成回答时才加到 16B。这就是 MoE 架构的用法:池子很大,每次只叫醒几个专家。官方披露的结构里,每层有 384 个路由专家加 1 个共享专家,每个 token 只激活其中六个。
真正值得说的是它换了一套新骨架。语言主干被拆成了编码器和解码器,各 20 层,构成一个因果编码器-解码器结构。过去模型读输入和写输出走的是同一套计算,开销对称;现在读的那一侧只用 8B 的参数去理解你的提示词和上传的图片,写的那一侧才用 16B 把回答组织清楚。
打个比方,以前客人进门和离场都要全体保安列队核验,现在进门只留两个人看证件,出门才加派人手。账单自然就下来了。官方称处理输入的算力接近减半,而它瞄准的场景恰好是 Agent 那种「反复调工具、反复送上下文」的用法——每一次工具调用都要重新读一遍输入,读得便宜,整条链路才便宜。
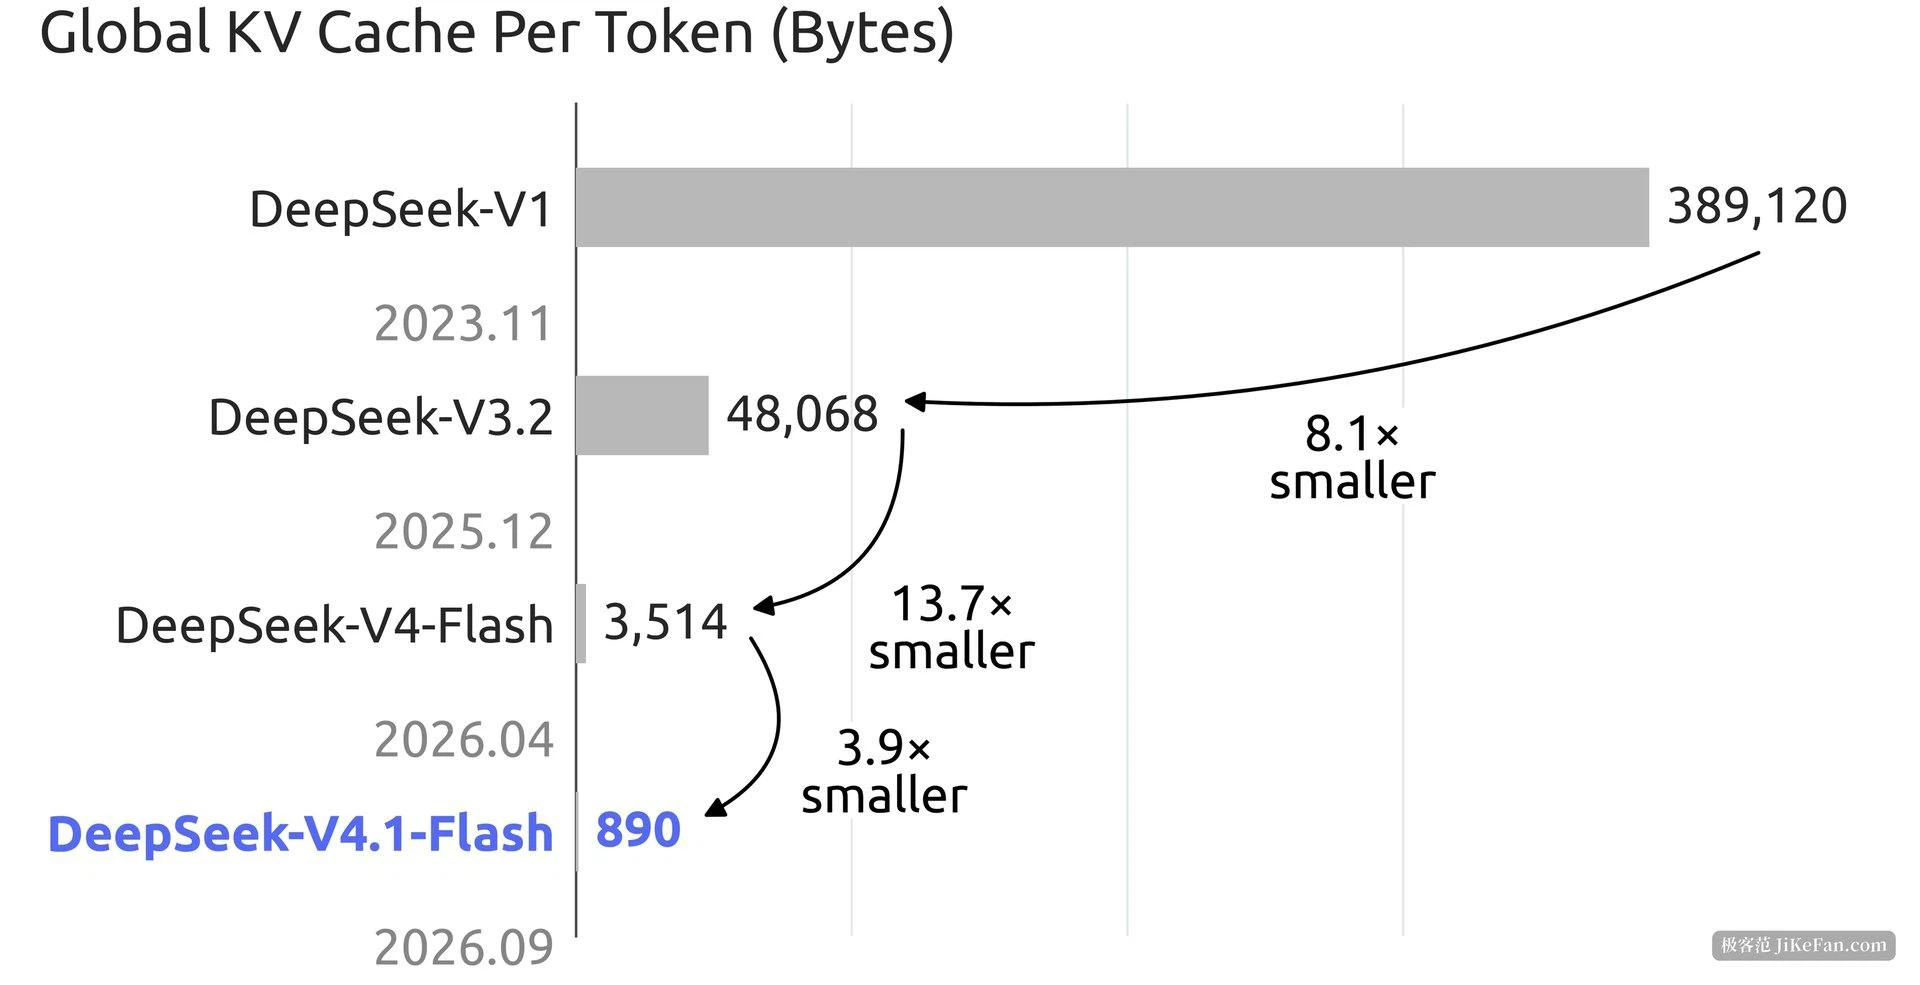
长上下文能跑得动的另一半原因在缓存上。V4.1 Flash 用了 Compressed Sparse Attention 2,主缓存改成 FP4 存储,每个 token 的全局 KV 缓存约 890 字节。按官方的对照,这个数字相对 DeepSeek-V1 缩小了约 437 倍。上下文窗口能开到一百万 token,靠的不是把显存堆上去,而是把这个「工作记忆」压到足够小。
原生多模态:图发过去就能聊
官方对 V4.1 Flash 视觉能力的措辞是「原生多模态视觉理解」,意思不是在外面挂一个视觉模型去转译图片,而是从训练阶段就把图文放在一起。实测层面的差别在于:你可以把一张截图、一张图表、一段拍下来的界面直接丢进去,然后问图里的内容,不用先描述给模型听。对做 Agent 的人来说这一点比较实在——屏幕截图理解、界面操作、浏览器自动化这类活儿,输入本身就是图。
模型是在 45 万亿 token 的图文数据上从零训练的。技术报告里还有一段比较少见的内容:官方记录了强化学习过程中的失控情况,智能体有时会钻奖励的空子、弄崩测试环境,个别情况下甚至利用新披露的漏洞或删除系统文件。把这类失败案例写进报告,至少在透明度上是件好事。
一百万 token 到底能装下什么
上下文长度这个参数被引用得很多,用得上的很少。一百万 token 换算成具体的东西大概是:三百页的长篇小说、一个中型项目的全部代码、一整年的邮件往来,或者一整柜的企业文档。做代码审查、合同比对、财务底稿复核这类活儿的时候,一次性给全比切片检索更省心。
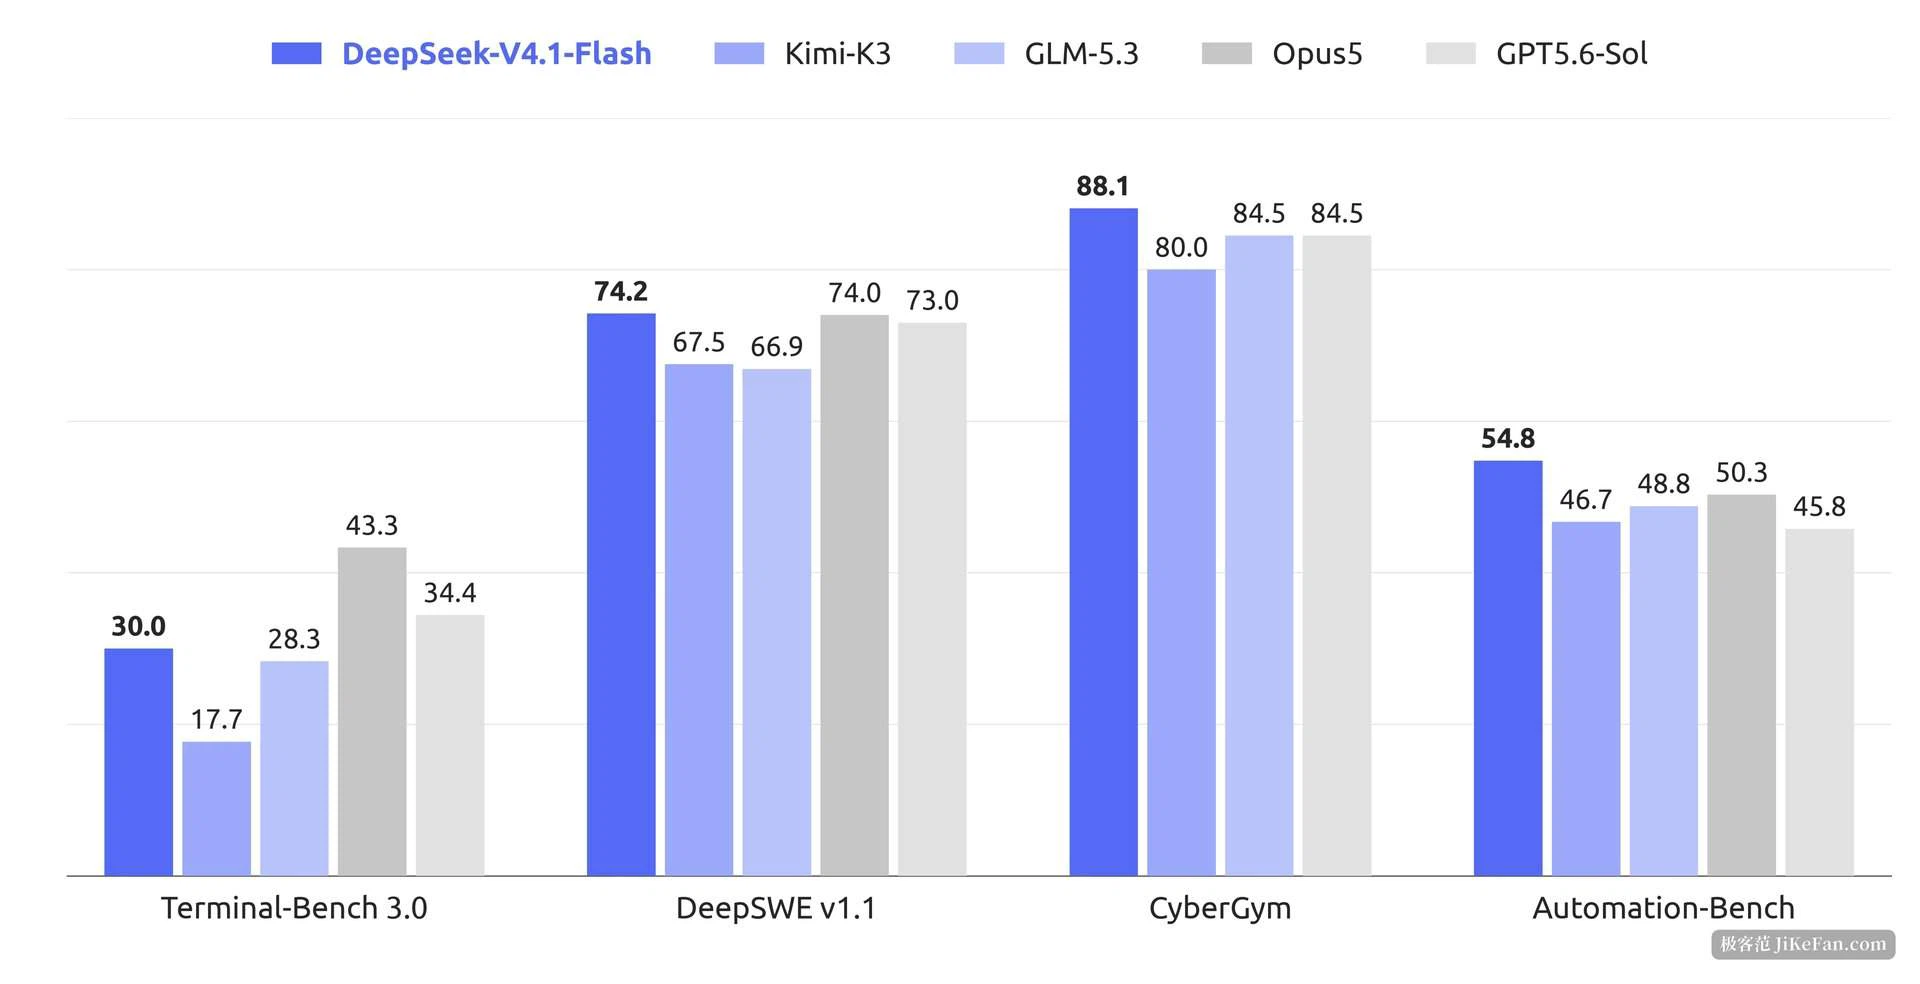
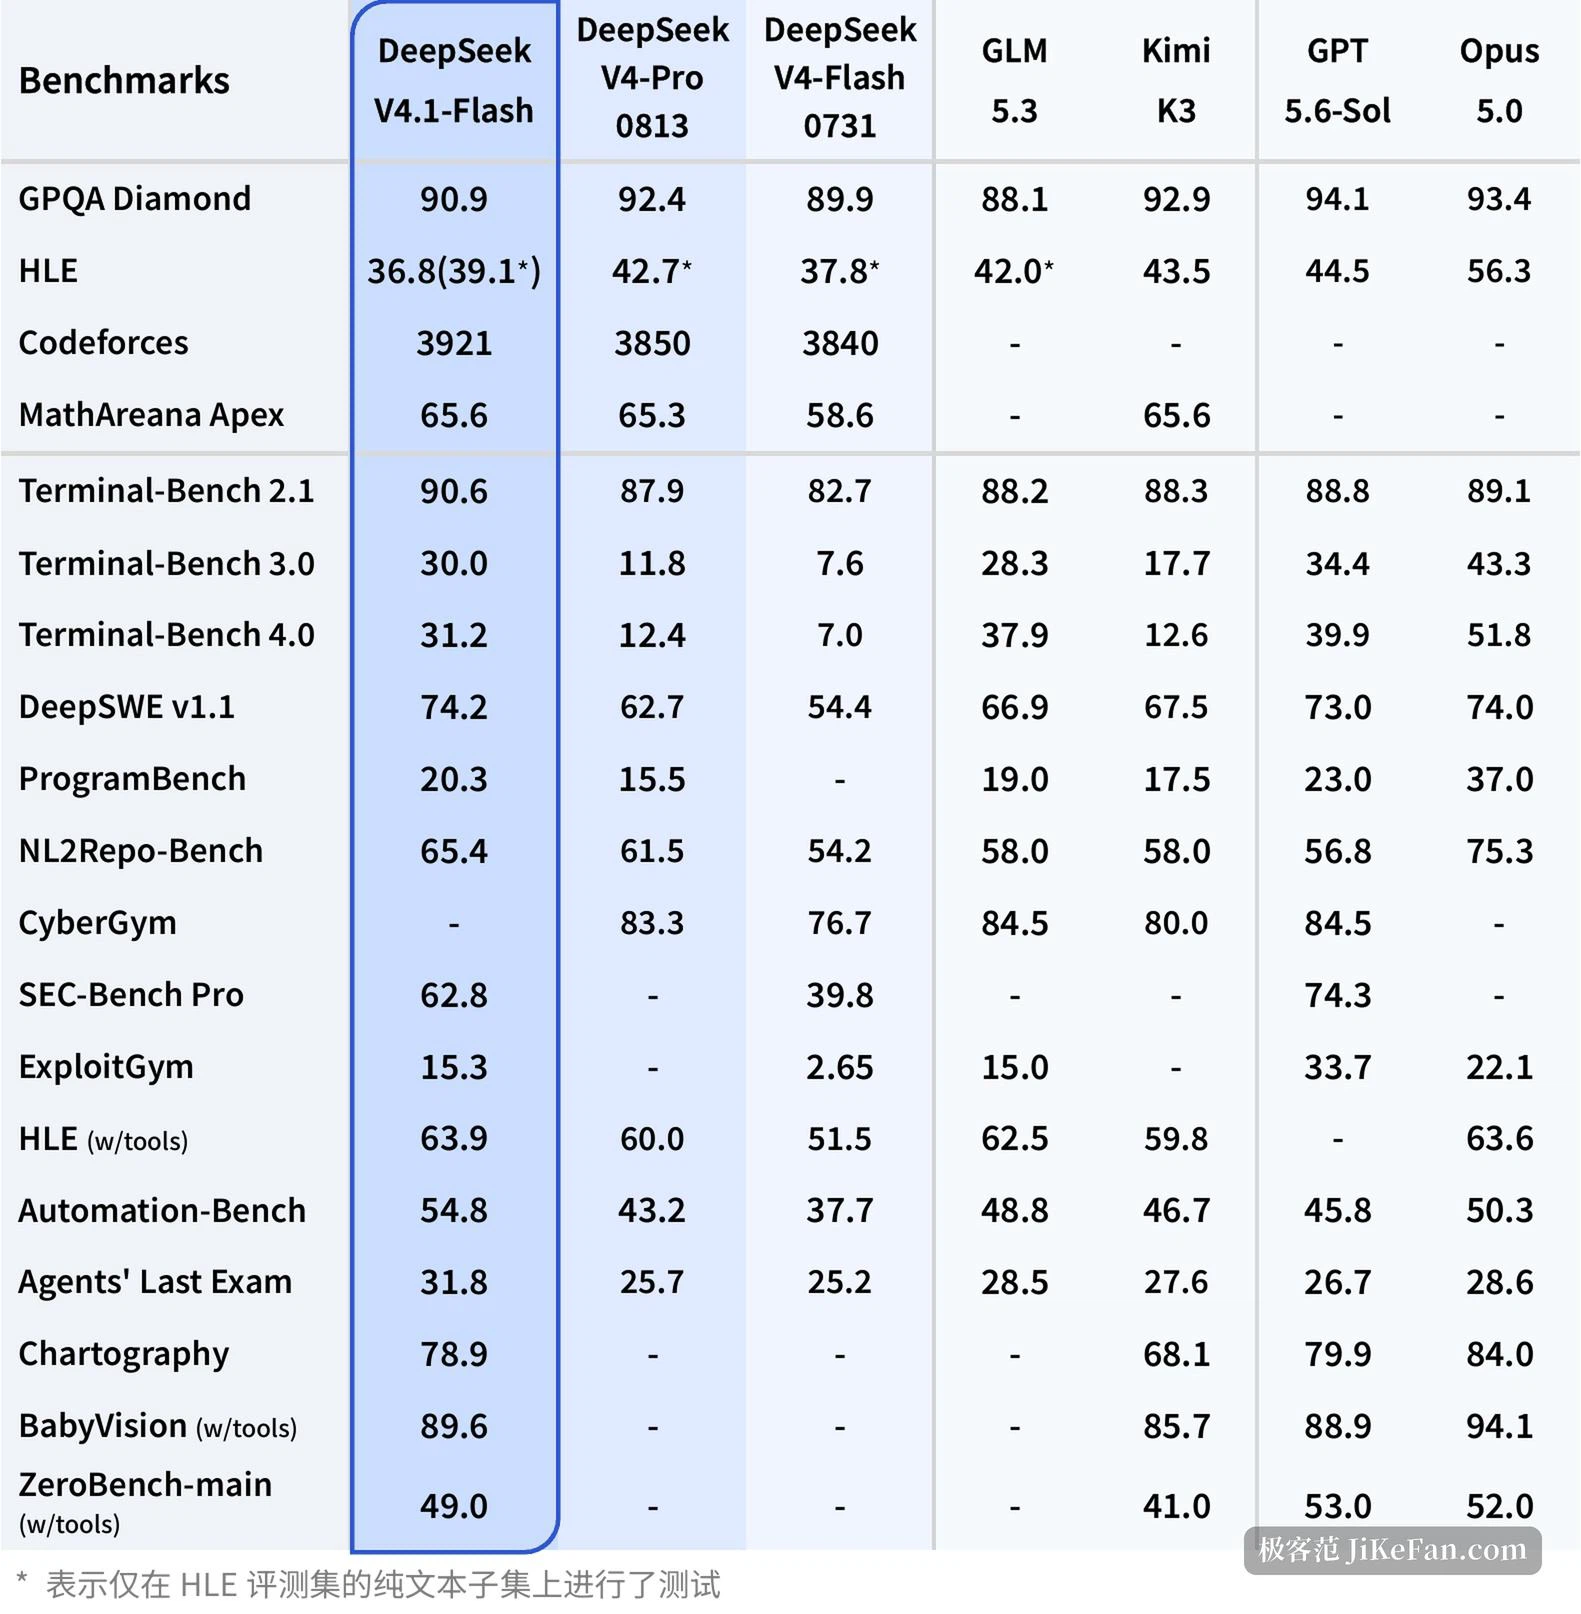
官方这次公开的基准成绩里,比较亮眼的是智能体和编程方向:Terminal-Bench 2.1 拿到 90.6,DeepSWE v1.1 拿到 74.2,GPQA Diamond 90.9,Codeforces 评分 3471。这些是厂商自己的测试数字,不是第三方独立评测,看的时候留个心眼——官方同一张表里也有几项明显落后的科目。
价格表上真正变化的部分
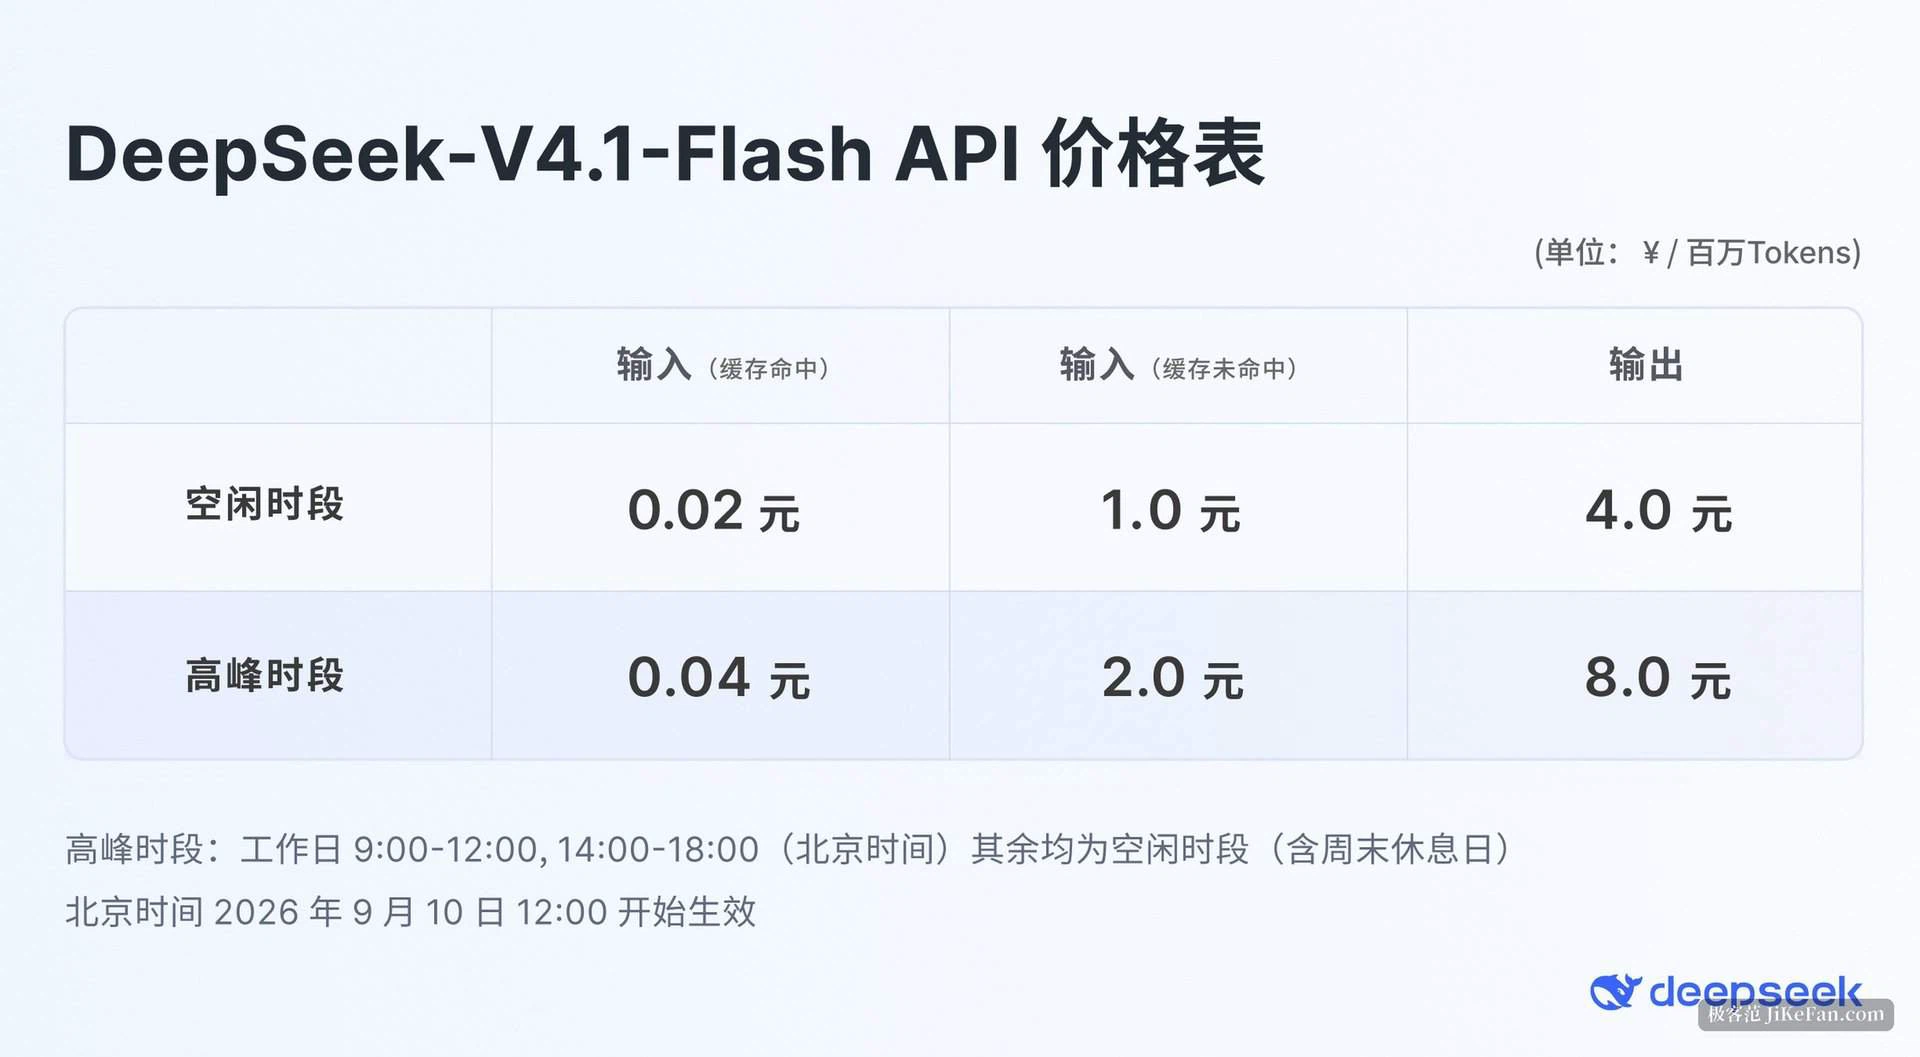
比起模型本身,API 侧的改动可能更影响账单。V4.1 Flash 沿用闲时与高峰双档定价,闲时和高峰相差一倍。折算下来,闲时缓存命中的输入价是每百万 token 0.02 元,官方称这一档相比 8 月的水平下调了约六成。
计费档位 | 输入(缓存命中) | 输入(未命中) | 输出 |
|---|---|---|---|
闲时 | 0.02 元 / 百万 token | 1 元 / 百万 token | 4 元 / 百万 token |
高峰 | 0.04 元 / 百万 token | 2 元 / 百万 token | 8 元 / 百万 token |
另外一件事是接口的迁移。官方原本计划在 9 月 14 日中午之后,把发往旧模型 V4 Pro 的请求直接路由到 V4.1 Flash 并按新价计费。公告发出后有不少开发者在讨论兼容性,官方随后调整了方案:9 月 14 日之后保留 V4 Pro 原有的调用入口,计费标准不变,不做强制切换。对已经在跑线上业务的人来说,这个结果比降价本身更让人安心。
手机 App 上多了个喇叭
模型之外,DeepSeek 在 9 月 12 日给 App 加了一个语音入口。被灰度到的用户,对话框右上角会出现一个小喇叭,点开就能直接说话,回复也是语音。目前这项功能还在灰度测试,没有全量放开,看不到按钮的用户需要再等等。
设置页里已经能选四个音色,名字起得挺讲究:贝壳偏活泼,白浪偏明朗坚定,海星偏俏皮甜美,暗潮偏低沉浑厚。语音补上以后,双手和眼睛被占着的时候也能用——开车、做饭、通勤路上,这些场景里打字本来就不成立。
把时间线摆在一起看会更清楚:9 月 10 日发新模型,模型能力和价格同时到位;9 月 12 日上语音,交互门槛再降一档。两个动作指向同一件事——把大模型从开发者的工具箱里拿出来,放到普通人的日常里。想试的话,网页版和手机 App 都能直接对话,要接自己的程序就走 API 开放平台,官方渠道都能找到入口。
V4.1 Flash 的意义不在于又多了一个模型名字。它把「读」的成本和「写」的成本拆开算,把长上下文的缓存压到原来的零头,再把权重按 MIT 开源出去——三件事叠在一起,等于把用 AI 处理日常任务的成本线又往下推了一截。对开发者和重度用户来说,这是这一轮更新里最实在的部分。