
八 GB 的顯示卡也能開 128K:Strata 0.2.10 換掉推測層,本機跑 Qwen3.8 提速了
摘要
本機跑大模型最卡人的兩件事:顯示卡記憶體不夠,長上下文開不起來;速度太慢,等不下去。Strata 0.2.10 把預設推測層換成只佔 625 MB 的小模型,八 GB 的卡因此能撐到 128K 上下文。
推薦- 軟體名稱
- Strata
- 版本
- 0.2.10
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsmacOSLinux
- 更新時間
- 2026-11-03 23:00
在本機跑大模型,最難受的兩件事:一是顯示卡記憶體不夠,長上下文根本開不起來;二是速度慢到讓人不想用。Strata 0.2.10 同時往這兩頭下手,把預設的推測解碼器換成一顆六百多 MB 的小幫手,又讓八 GB 的卡也能把上下文開到 128K。
這一版動了什麼
Strata 是一套跑在自己電腦上的大模型客戶端,以 C++ 撰寫、MIT 授權、程式碼放在 GitHub 上,目前將近四萬顆星。定位很窄也很清楚:給消費級硬體用,桌面應用與終端機兩個入口,裝完挑一個模型就能開始對話、寫程式、讀圖片,不必註冊帳號,也不經過任何伺服器。
版本編號得講清楚:應用與終端機都是 0.2.10,控制元件與各引擎套件則是 0.1.56。官方在發布說明裡把重點列得很直白——DFlash2 成為預設草稿器、Linux 上多卡全卡切分引擎自動啟用、新增 ISTA-DAS Coder 模型、Mac 上能讀圖、八 GB 顯示卡起步就能支援 128K 上下文。
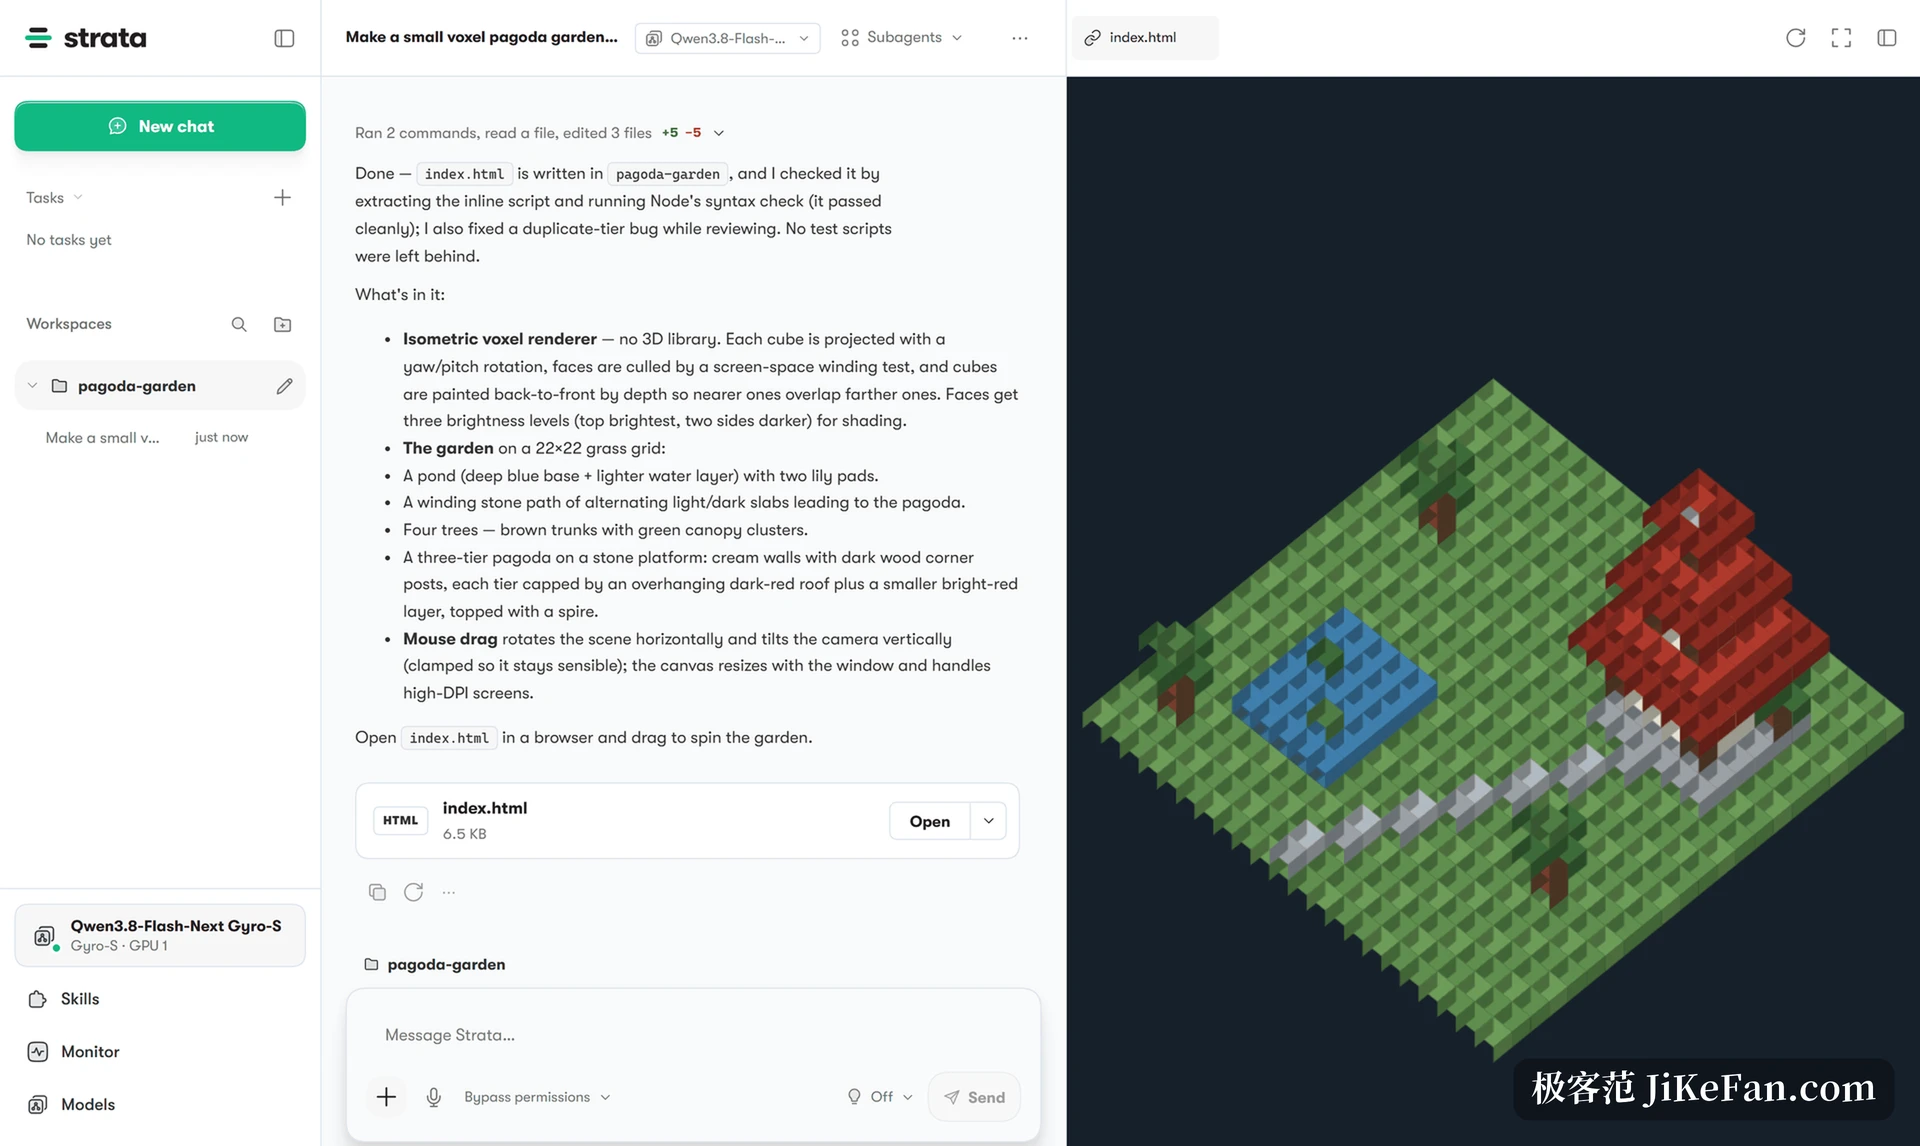
用六百 MB 換掉五 GB 的推測層
推測解碼的思路,是讓一個體積很小的輔助模型先猜接下來會講什麼,再交給主模型批次核對,猜中得越多,省下的逐字生成時間就越多。Strata 上一版用的推測層叫 MTP,佔顯示卡記憶體大約 5.2 GB;這一版換成 DFlash2,只佔 625 MB 上下,一來一往就空出四 GB 多。
空出來的記憶體直接變成可用的上下文。官方給的對照是同一套引擎與檔案:Ryzen AI Max 的 Windows 機器上,短回答快 12%、長回答快 8.8;RTX PRO 5000 以貪心解碼計算是 7.9;Apple M5 Max 是 7.4;DGX Spark 是 5.8。也有反例,Intel Arc A750 比 MTP 慢 2.6,官方照實寫了出來。
代價是併發。DFlash2 一次只處理一個請求,要同時跑多個就得切回 MTP,模型家族不是 Qwen3.8 時也一樣。這套自動選擇寫在程式裡:選自動就按硬體與情境挑,挑錯了也能手動指定,每次執行只載入一個草稿器,不會兩個一起上。
八 GB 顯示卡記憶體怎麼塞進 128K
長上下文吃的是快取。以前在八 GB 的卡上開 64K 甚至更高,專家快取一滿就直接啟動失敗,使用者只能退回四十八 K 左右。這一版改了資源擺放方式:記憶體吃緊時,在顯示卡記憶體與系統記憶體之間動態搬移資料,盡量保住使用者設定的上下文長度,必要時把一部分快取攤到系統記憶體、甚至固態硬碟上。
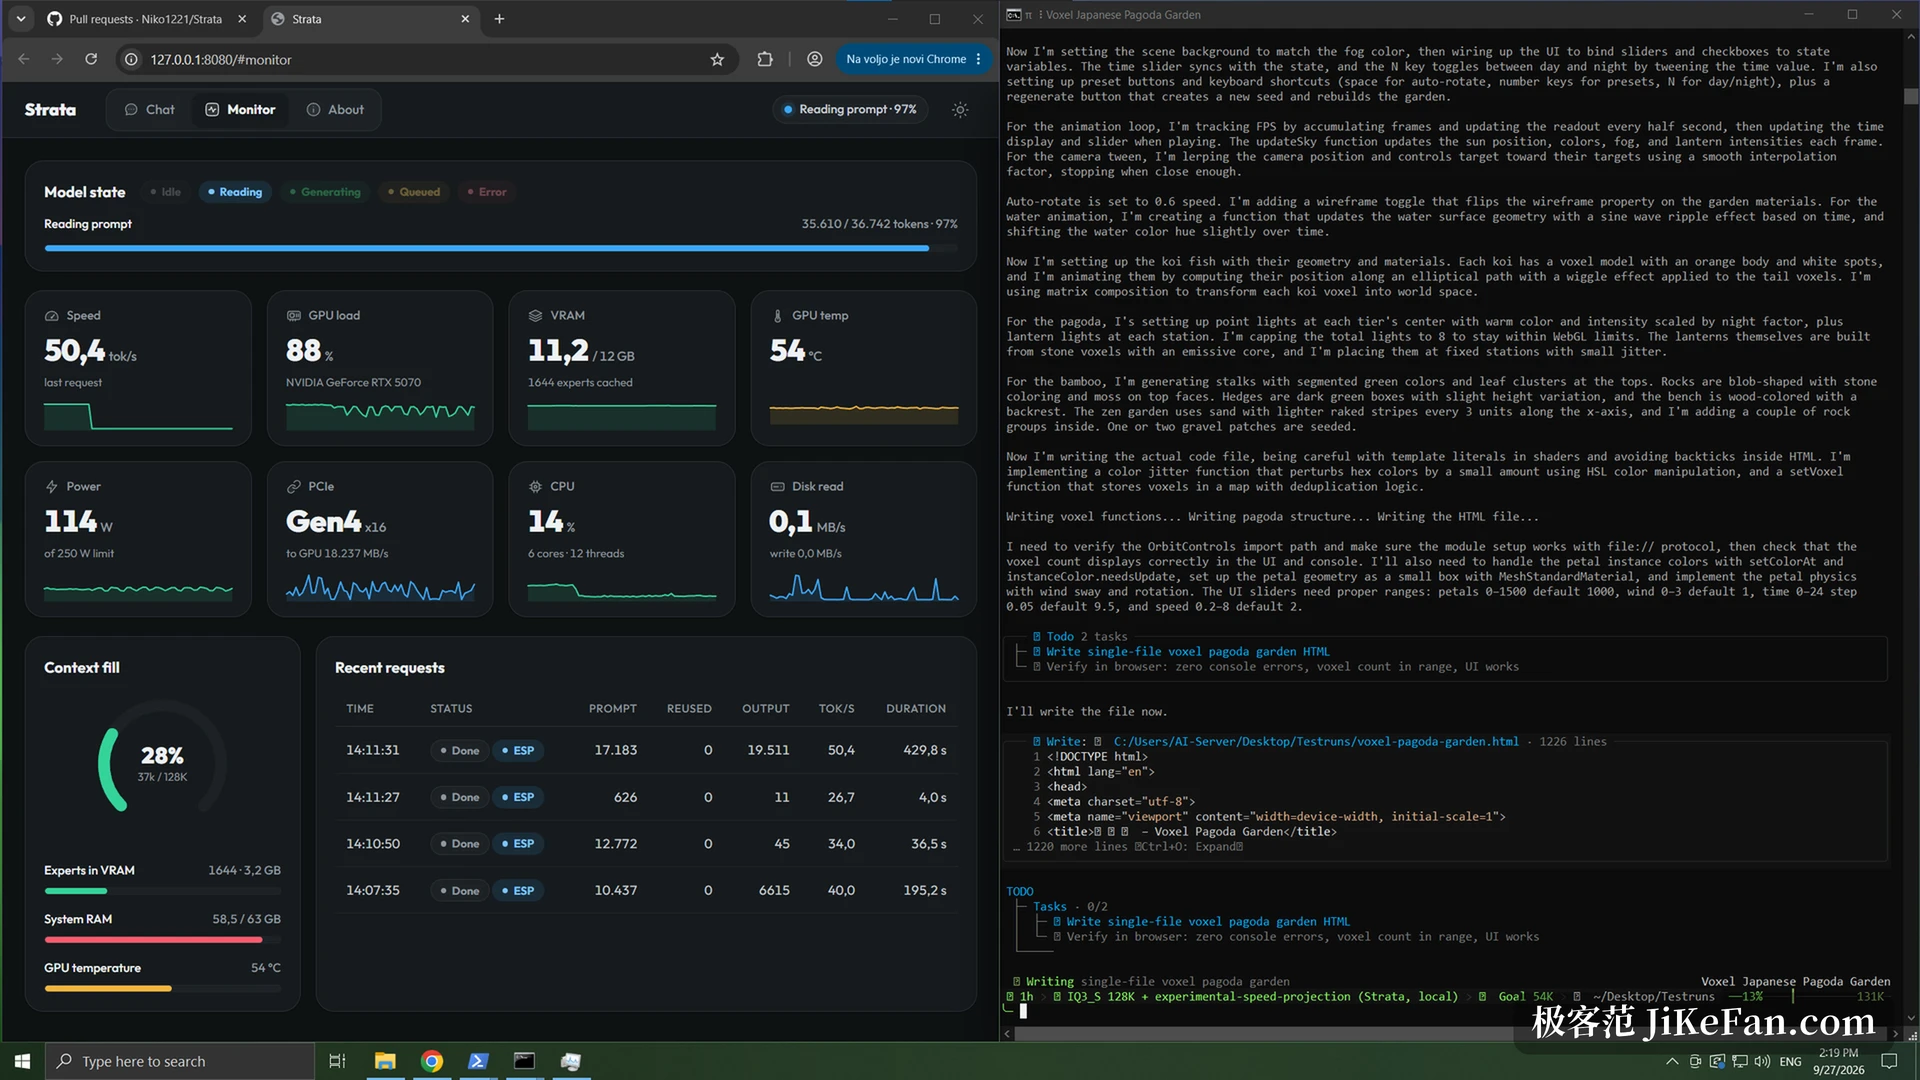
實測數字是這樣:把測試機限制成八 GB 卡的條件,跑 Qwen3.8 的 IQ3_S 量化版本開 128K,DFlash2 模式生成 63 到 73 Token 每秒,讀一份 32K 的提示花了 19.8 秒,此時顯示卡記憶體還剩 390 MB。換成真實存在的 Intel Arc A750 八 GB 卡,四種 128K 啟動組合全部成功,速度 12.7 到 14.8 Token 每秒。十二 GB 的卡不受影響,速度維持原樣。
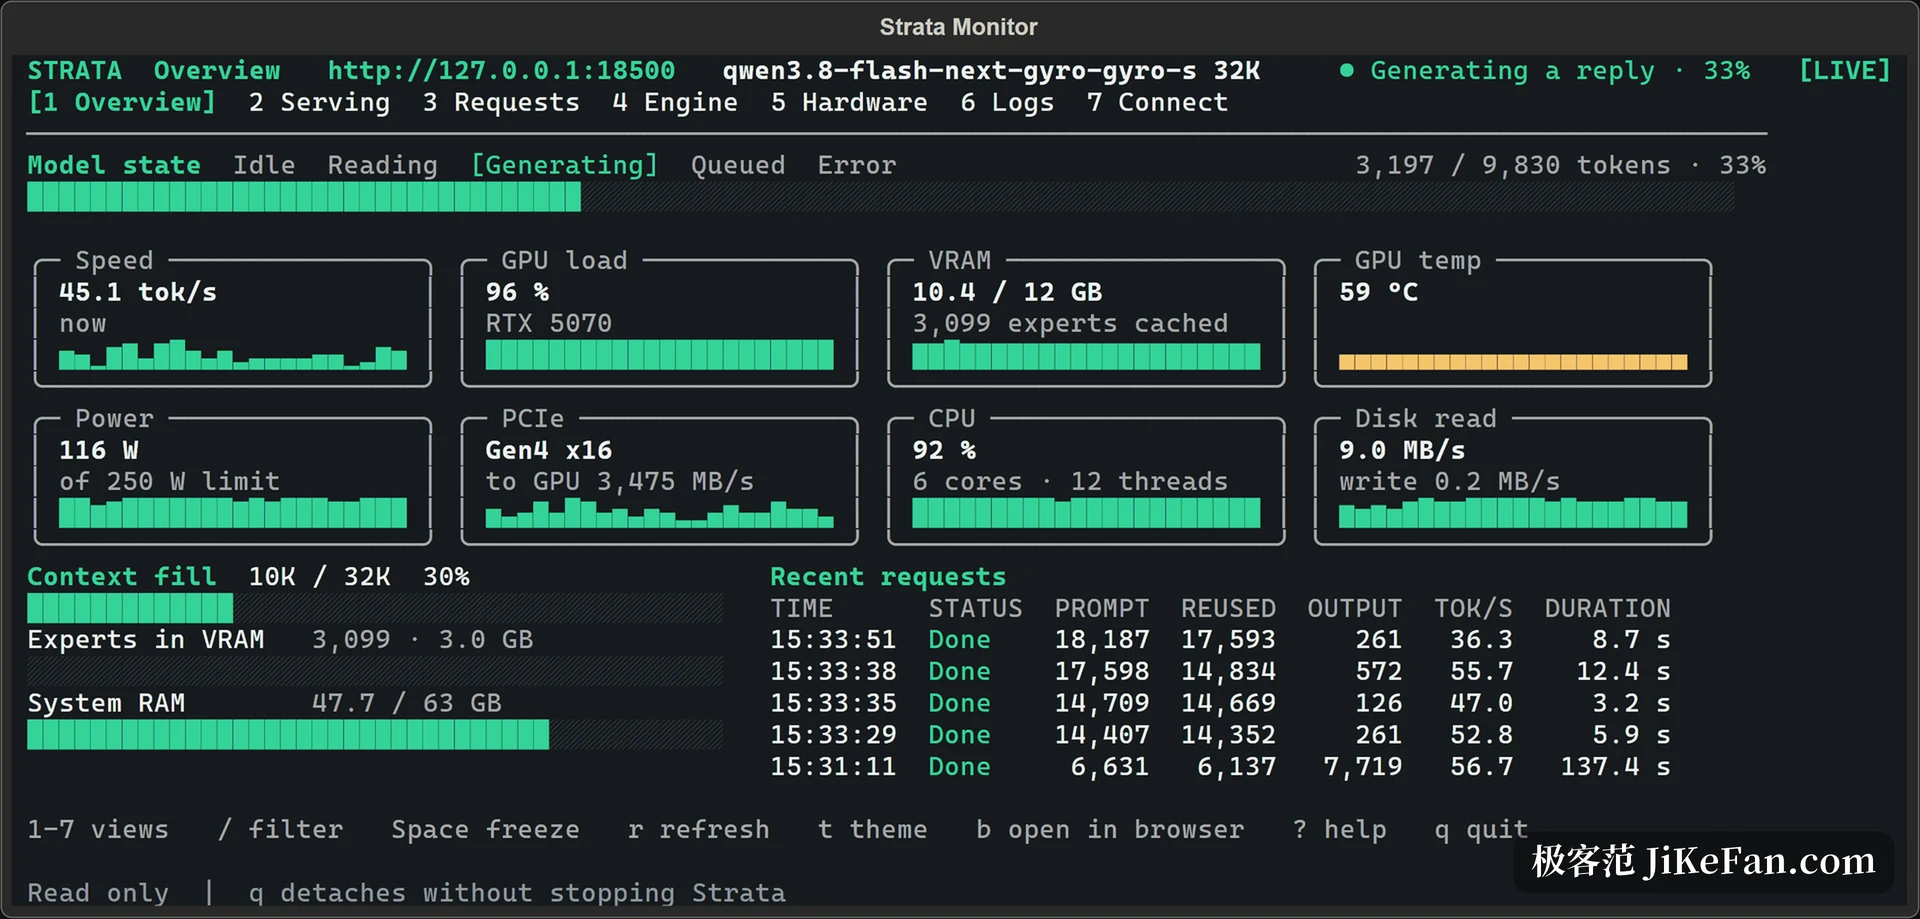
這條路不是沒有門檻。壓力被系統記憶體與硬碟分走之後,對整機記憶體的要求就跟著上來,社群裡的經驗值是 32 GB 起步、48 GB 剛好、64 GB 才算從容。硬碟也得留位置,模型檔本身就不小。
兩張卡一起跑,程式碼編輯接近翻倍
多卡的老做法是分層切:每張卡負責模型的一部分層,算完再把結果傳給下一張。這一版在 Linux 的終端機裡預設啟用另一種切法,叫全卡切分——每張卡都持有每一層的一部分,所有卡同時讀權重、同時計算。好處是記憶體攤得更平均,壞處是卡與卡之間要頻繁交換中間結果,對互連頻寬有要求。
官方用兩張 RTX A6000 在 Linux 下測了這組對照:程式碼編輯從 195 Token 每秒漲到 377 到 394,寫新程式碼從 139 到 144 漲到 189 到 232,一般文字從 93 漲到 139 到 146,跑代理迴圈從 112 到 119 漲到 165。讀長提示反而略慢,32K 的提示從 7.65 秒變成 10.1 秒,算是用首字延遲換吞吐量。
自動啟用有嚴格條件:必須是 Linux,必須是兩張運算能力 8.6 或 12.0 的 NVIDIA 卡,或四張 Radeon AI PRO R9700 搭配特定量化檔;模型得是引擎吃得下的 Qwen3.8,所有路由專家都要裝進顯示卡記憶體,還要留出約 43 GB 的空閒記憶體。條件不滿足就老實回到分層切,程式會說明原因,也可以手動關掉。
順手補上的兩處
一是 Windows 上的啟動體驗。某些背景啟動情境下,磁碟讀取優先權被壓得很低,模型載入會明顯變慢,這一版把優先權調了回來。二是 Mac 上的圖片輸入:在 M5 Max 上八次圖片請求八次讀對,帶圖生成 19 到 22 Token 每秒,純文字是 21 到 22,圖片塔額外佔 319 MB 顯示卡記憶體,而引擎的記憶體峰值仍是 74 GB,與純文字時持平。
另外新增的 ISTA-DAS Coder 用的是 DeepSeek-V4.1-Flash 的 384 個專家裡每層取 192 個的設定,在四張 R9700 上解碼 59.2 Token 每秒,單卡 22.8,Apple M5 Max 上 19.1 到 22.5。這些數字都出自官方發布說明,取自不同機器,橫向比較意義有限,看個量級就好。
誰該更新
手上有八 GB 到十二 GB 消費級顯示卡、又想用長上下文的人,這一版值得換,因為它把原本根本開不起來的場景變成跑得動。雙卡使用者如果正好在 Linux 上跑 Qwen3.8,全卡切分的收益相當直接。至於只有一張大記憶體卡、平時也就聊聊天的人,升級後能感受到的差別,主要是首次啟動會多下載約 1.2 GB 的草稿器檔案。
要提醒的是,這類專案迭代很快,版本號一天一個也是常事,官方文件對硬體、量化等級與併發設定寫得相當細,動手之前值得對著自己的配置讀一遍,別直接照抄別人的參數。