
網站想存成 Markdown?Scrapling 0.5.1 連瀏覽器一起交出來
摘要
過去要把整站留成純文字,得自己寫爬蟲、自己清格式。Scrapling 0.5.1 用 Python 把抓取與轉存收在一起;改版後元素自己找回來,AI 也能接手操作。
推薦- 軟體名稱
- Scrapling
- 版本
- 0.5.1
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsmacOSLinux
- 更新時間
- 2026-11-10 23:00
Scrapling 是一個用 Python 寫的網頁抓取框架,把發請求、開瀏覽器、解析頁面、整站採集和匯出放進同一個程式庫。11 月 4 日發布的 0.5.1 版做了兩件事:把瀏覽器工作階段開放給外部程式接管,讓代理學會看動效和拖放;順手把「整站轉成乾淨 Markdown」這條路修得更順。需要給自己攢語料、或者想讓 AI 自己去讀公開網頁的人,值得花十分鐘了解它。Windows、macOS 與 Linux 上都能跑。
先把網頁洗成 Markdown,再交給模型
大模型讀原始 HTML 吃虧。導覽列、腳本、樣式、廣告位全在裡面,真正有用的正文夾在中間,按字數計費的時候,這些雜訊照樣付錢。Scrapling 的減法做在轉換階段:呼叫 markdown() 之後,腳本、樣式、隱藏元素一律清空,頁面上用 CSS 藏起來的白字、標了 aria-hidden 的區塊、HTML 註解和零寬字元也一併剔除。
這一步不經過任何大模型,純本機字串處理,抓一萬頁也不產生模型費用。省下的不只是錢。餵進去的語料乾淨,下游切塊的品質才穩,檢索出來的片段不會帶著半屏選單項目。
整站轉 Markdown 有現成樣板。設好允許的網域、指定正文選擇器、給一個頁數上限,跑完得到一個資料夾的 .md 檔案,外加一份 JSONL,每條記錄帶來源、標題和正文,可以直接倒進知識庫。檔案庫、部落格、產品手冊這類結構規整的站點,用它整理語料最省事。
元素帶指紋,頁面改版不用重寫選擇器
抓取腳本最脆的地方是選擇器。站點換一套 CSS 類名,昨天還能跑的程式今天就回傳空清單,一層層翻日誌才發現是類名變了。Scrapling 的自適應元素追蹤換了個思路:第一次定位時把元素的位置、屬性、文字特徵記成指紋,頁面結構變動之後,它按相似度重新找那個「換了位置但還是同一個東西」的節點。
配套的相似元素比對對付另一個常見場景。一頁幾十張結構相同的卡片,要挑出特定的那一個,先找到參照元素,再按結構相似度往外擴,比手寫 nth-child 穩。
一次請求和一整個站,寫法是同一套
- Fetcher
- 發普通 HTTP 請求,帶上與真實瀏覽器一致的 TLS 指紋和請求標頭,靜態頁、公開介面夠用。
- 瀏覽器類抓取器
- 用 Playwright 驅動 Chromium 渲染,等 JavaScript 執行完再取內容,也能掛在已經開著的瀏覽器上。
- Spider
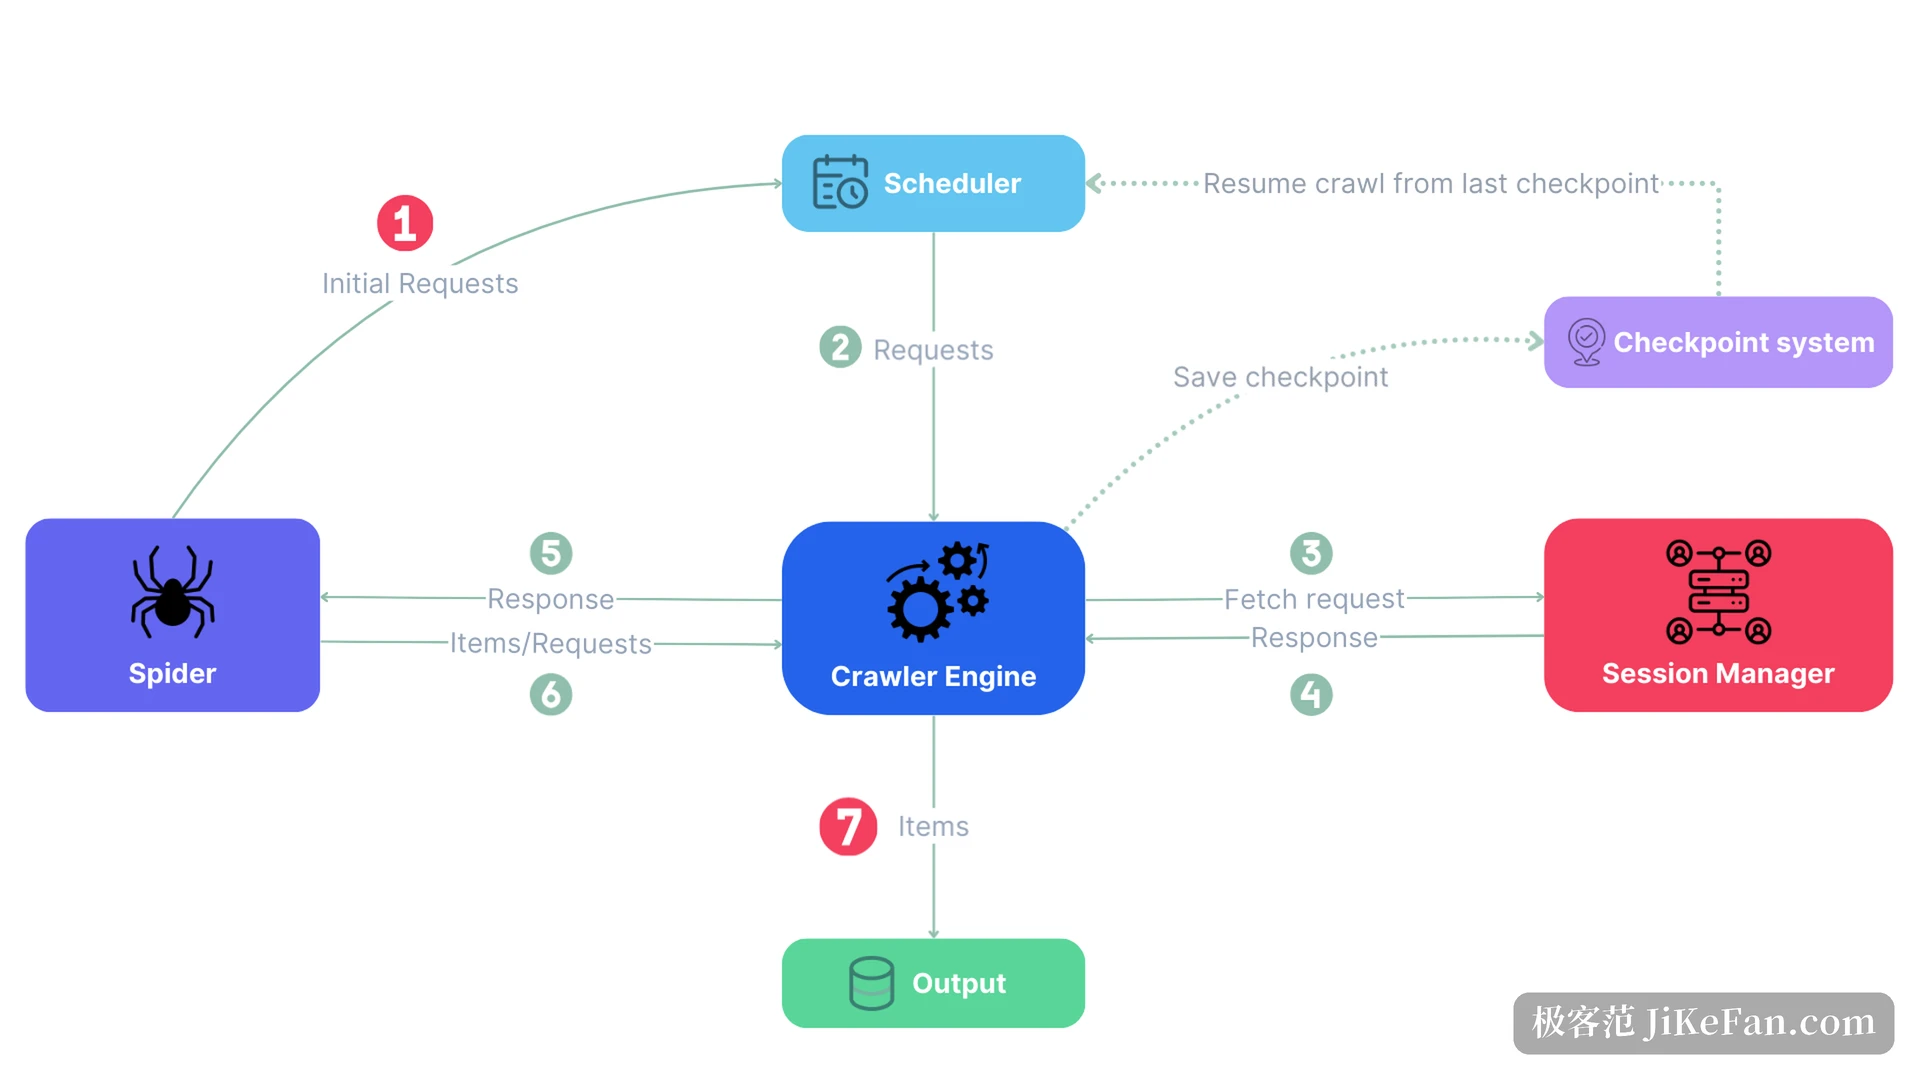
- 並發採集,自動限速,按 Ctrl+C 存下進度、下次接著跑,結果匯出成 JSON、JSONL、CSV 或 XML。
三種抓法共用同一套解析介面。同一份選擇器程式,換一個 fetcher 就能從靜態頁搬到動態頁,不必為了渲染 JavaScript 另起一套寫法。頁面背後那些 XHR 請求也能錄下來,介面回傳的資料往往比渲染後的 HTML 更規整。
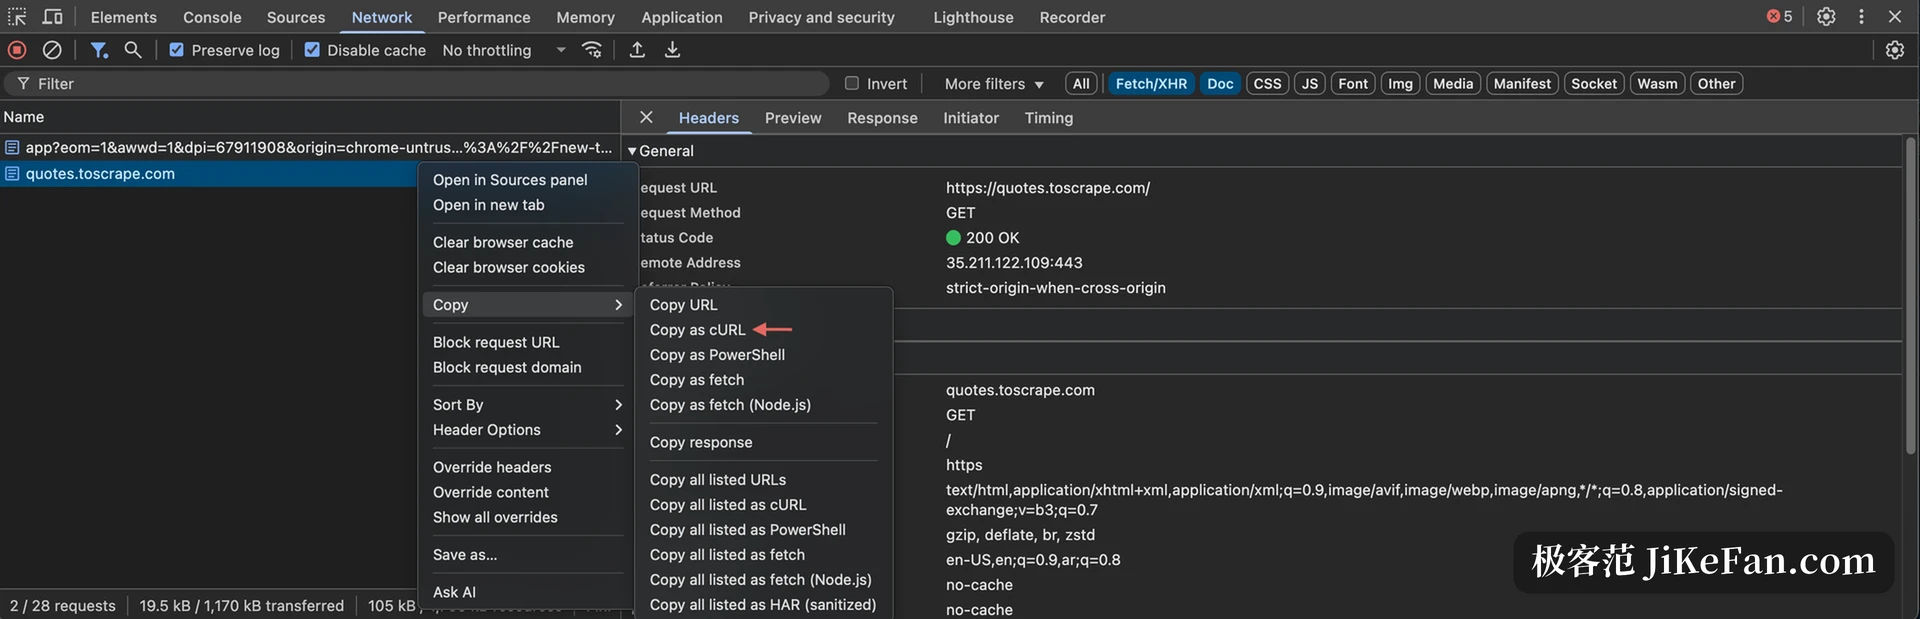
還有一個順手的小細節。平常在瀏覽器裡除錯介面,右鍵「複製為 cURL」能得到一條完整的請求;這條指令貼進 Scrapling 的互動式 shell,會自動轉成可重複使用的採集語句,先跑通,再改寫進腳本。省掉了從零拼請求標頭那一遍。
0.5.1 補上的三個口子
| 版本 | 時間 | 主要變化 |
|---|---|---|
| 0.5 | 2026-10-17 | MCP 伺服器補齊完整瀏覽器流程,新增網路請求錄製與登入狀態存取,支援開放的 Shadow DOM,可選廣度或深度優先。 |
| 0.5.1 | 2026-11-04 | 新增遠端工作階段類別,可直接接管已在執行的 Chromium;代理能看動效、能按住滑鼠拖放。 |
遠端工作階段這一項,意義在把瀏覽器和採集行程拆開。它透過 CDP 端點連上一台已經開著的 Chromium,預設沿用原有上下文,登入狀態直接繼承,斷開工作階段時已開的分頁還留著。以前要帶著登入資訊跑採集,只能在腳本裡反覆存取狀態檔。
動效和拖放是給代理準備的。單張截圖只記錄一瞬間,動畫、捲動之後的位置變化、滑桿這類控制項,靜態圖看不出前因後果。0.5.1 讓它按一組連續畫面理解頁面在動什麼,也能按住滑鼠、移動、中途停下來檢查、再放開。工具描述同時做了壓縮,同樣的能力佔掉更少的上下文預算。
給代理的入口不止一個
MCP 伺服器負責動手。開頁面、點擊、填表、捲動、截圖、讀介面回應都做成了工具,用戶端接上之後,一句「把這一頁的參數整理成表格」就能跑完。代理技能負責另一件事:它是一份隨版本更新的手冊,編碼助理寫 Scrapling 程式時按需查閱,省得憑舊記憶拼錯介面。命令列和互動式 shell 是第三條路,適合先把一次請求跑通,再落回腳本。
這三條路對應三種人。做資料管線的人多半只用 Python 介面;習慣在終端機裡試錯的人喜歡 shell;把採集交給代理的人,碰的是 MCP。
邊界還是那條邊界
能力越強,越要先想清楚抓什麼。公開檔案、公開報價、公開發布的政策檔案,屬於常規用途。對方站點明確寫了不許自動存取,或者內容要登入才看得到,那就別碰。Scrapling 的 Spider 可以選擇遵守 robots.txt,也支援按網域限定範圍,把採集留在目標站內,不跑偏。頻率同樣值得克制,一天一兩次足夠看清變化,沒必要把對方伺服器當成壓力測試的對象。
Scrapling 0.5.1 的價值不在「能抓」,而在「抓完還能直接用」:網頁進它就變成乾淨的 Markdown,元素換了位置它自己認回來,代理也能接手操作。整套東西開源、可本地跑,代價是它終究是個需要寫程式的工具,指望開箱即用的人會失望。真正吃得上這份便利的,是已經在自建知識庫,或者正在給代理搭取數鏈路的人。