
先替資料立一本詞典,再讓 AI 報數:Auto-Ontology 0.1
摘要
模型把「營收」認成另一欄,SQL 跑得過、數字卻是錯的。開源的 Auto-Ontology 先從資料庫長出業務詞典,每個答案都附上 SQL 與執行步驟,可以逐條核對。
推薦- 軟體名稱
- Auto-Ontology
- 版本
- 0.1
- 收費
- 免費
- 開源
- 開源
- 作業系統
- LinuxWeb
- 更新時間
- 2026-11-10 23:00
Auto-Ontology 是 NVIDIA 開源的語意層,做法是先從既有資料庫裡長出一份業務詞彙表,再讓代理照著這份詞彙表回答。它要解的是查資料時最常見的翻車:模型把「營收」讀成另一個欄位,SQL 跑得過,數字卻是錯的。想用自然語言查業務庫、又不敢直接相信模型輸出的人,可以看看它怎麼把這一步變成能核對的流程。專案以 Apache 2.0 開放,前端是網頁介面,後端跑在容器裡,接上一個模型端點就能起來。
查資料缺的不是翻譯,是一本詞典
把自然語言翻成 SQL,技術上早就能做,難的是含意。同一個「客戶數」,在訂單表裡數的是下過單的帳號,在客戶表裡數的是建過檔的公司;「營收」可能含稅也可能不含,可能是已開票金額也可能是應收。模型不知道貴公司按哪個口徑算,只會挑一個看起來合理的欄位。
Auto-Ontology 的順序是先補這層上下文:資料在哪、叫什麼、能不能用、該怎麼用、從哪裡來、哪些東西跟它相似。這些資訊平常散在資料字典、SQL 腳本與資深同事的腦子裡,它做的事是把它們收進一個可以查詢的結構,再交給代理。
詞典裡裝三類東西
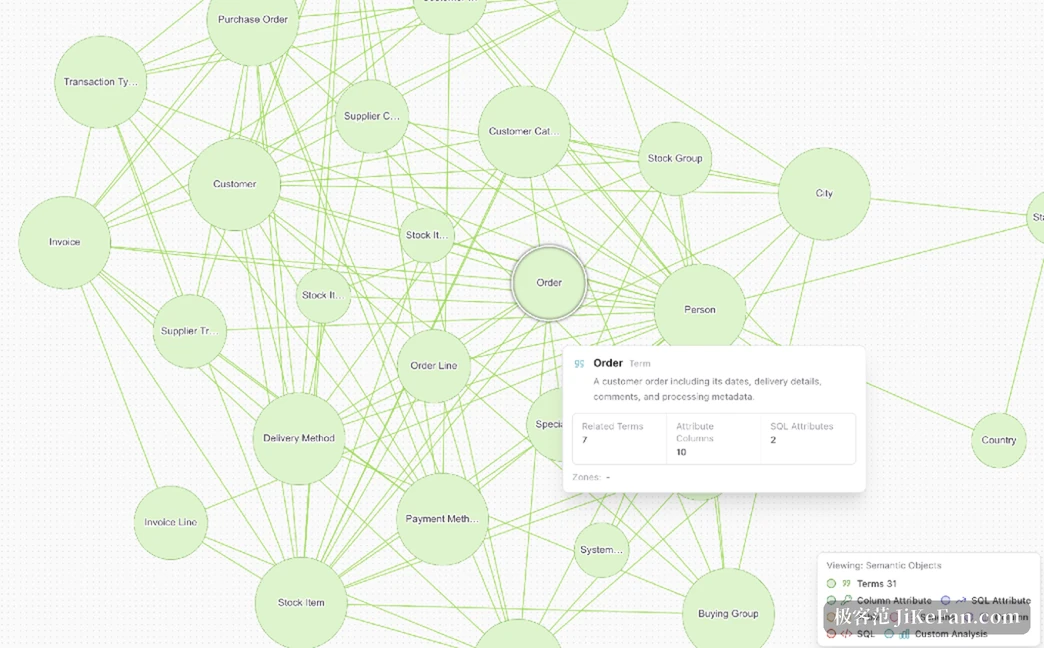
術語是業務概念,例如「客戶」「發票行」,帶描述與同義詞,並對應到具體欄位。SQL 屬性是掛在術語底下、經人審過的算式,例如毛利率,代理因此重複使用同一套演算法,而不是另外造一個。關係記錄表與表怎麼連,包含橋接表,由鍵與資料結構推斷而來。
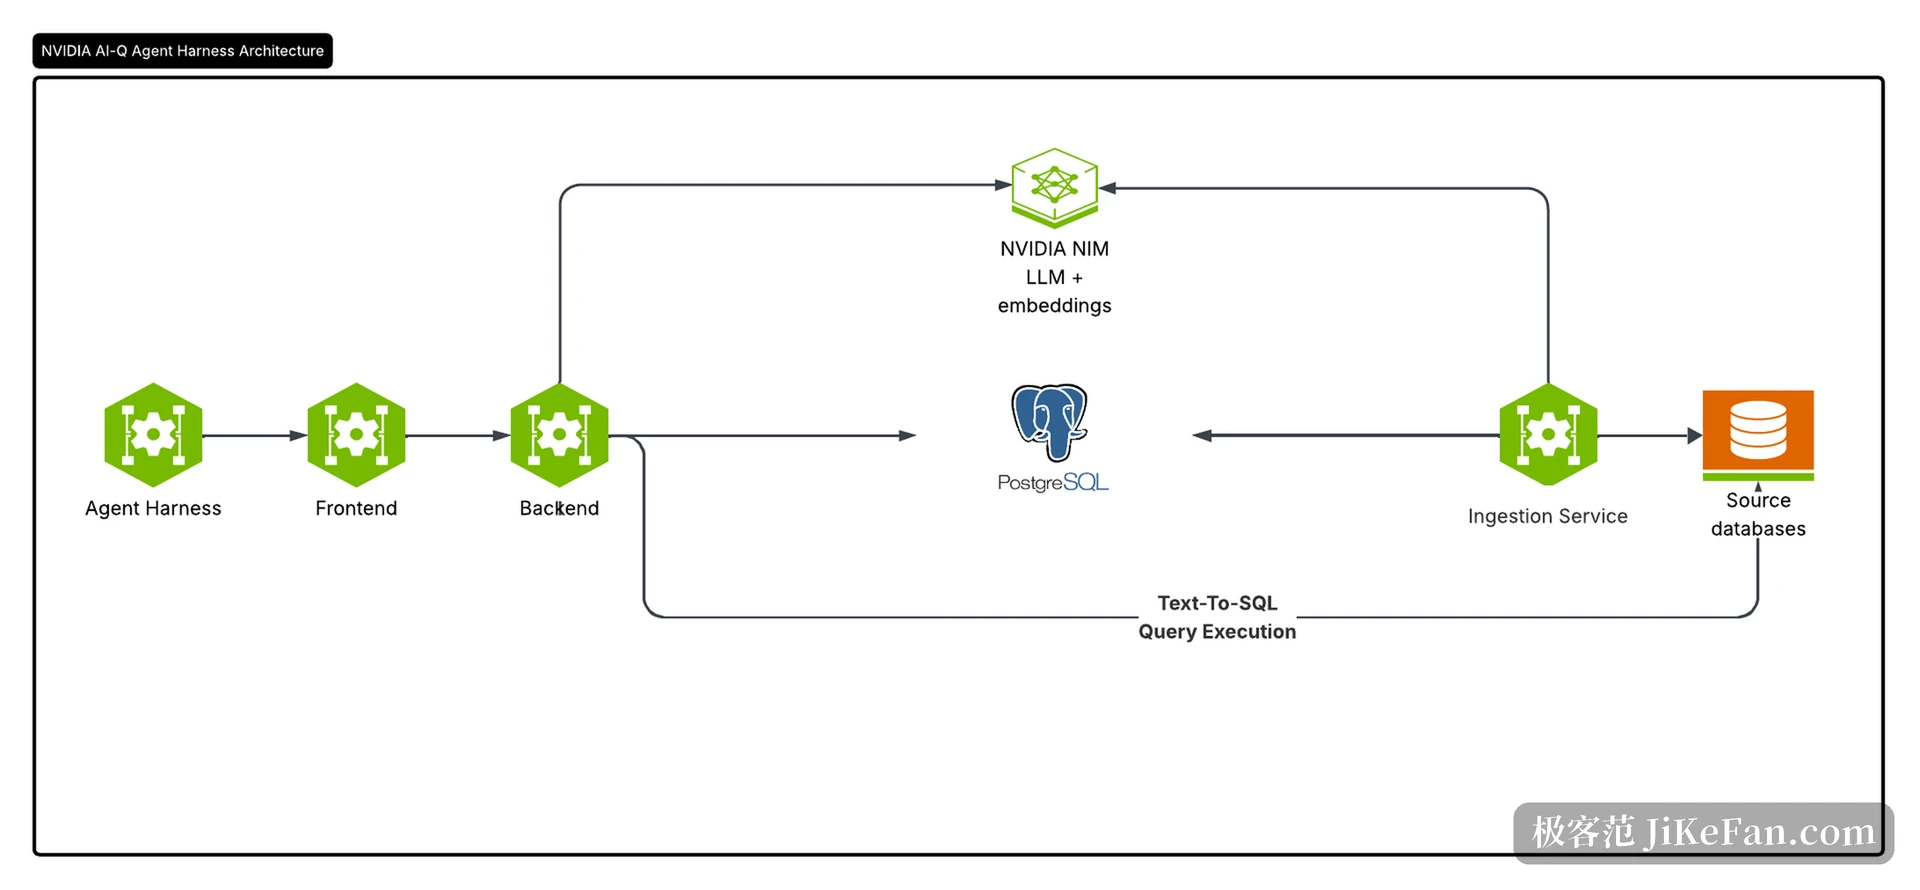
生成分四步。攝取服務先讀來源庫,抽出結構、為欄位做輪廓、取樣值;接著逐表抽出術語並對應到欄位;再推斷表之間的連接,並從歷史查詢裡建議 SQL 屬性;最後把術語、關係與屬性寫進 Postgres,同時把向量存進 pgvector 供檢索使用。
跑完之後,您在介面上看到的是一張可以點開的語意圖。官方範例用的是微軟那套 Wide World Importers 範例銷售庫,一次編譯產出 31 個術語;選中「訂單」,右側會列出描述、關聯術語、對應到的欄位與 2 條 SQL 屬性。數字不大,卻足以說明這套結構長什麼樣子。
機器起草,人簽字
自動生成的東西不能直接上線。專案把「認證」做成獨立環節:先在對話裡拿真實問題試,或透過 MCP 呼叫檢查工具;發現術語描述不對、SQL 屬性算錯,就在介面上改;改完再逐項認證。只有認證過的名稱、描述與算式,才會被當成可信定義,參與後續的回答。
這一步看著笨,卻是整件事的關鍵。語意層的價值不在於自動生成得多快,而在於每條定義背後有人負責,認證狀態就是那個負責的記號。
報數之前多走一步驗證
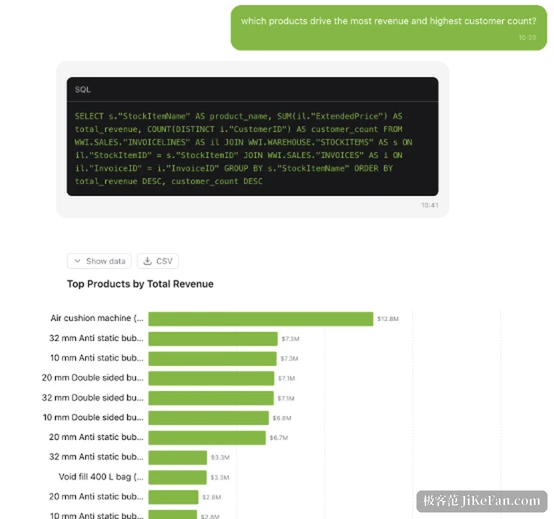
回答一個問題要走五關:判斷意圖、抽出問題裡的實體;用向量檢索找出候選術語、欄位與屬性;據此寫 SQL;把過濾值與整條查詢拿去資料庫裡試,不通過就修;最後執行,並把答案、SQL 與執行步驟一起回傳。
第四關是它跟一般問答工具拉開距離的地方。很多工具寫完 SQL 就直接跑,跑出空結果或離譜數字也照樣送出。這裡會先確認「賓州」這類過濾值在庫裡到底存不存在、寫法對不對,查詢本身也先試跑一遍。
還有一層是拒答。官方範例裡問「某產品 2015 年 6 月的廣告投放回報」,範例庫沒有廣告資料,覆蓋度只有 0.5,它不會硬編一個數字,而是回一句「這份資料裡沒有廣告花費,要不要改看那個月的營收,或者廣告資料存在別的庫裡」。這種回答比一個看起來精確的錯數字有用得多。
接進代理,走 MCP
專案自帶一個以 FastMCP 寫成的伺服器,對外只提供唯讀工具:查部署是否就緒、搜術語、取術語的欄位與 SQL 屬性、判斷某個問題在現有本體裡能不能答,以及直接提問拿回答案與資料列。每次呼叫都按登入使用者的權限執行,不是一把萬能鑰匙。
它同時支援 Apache Ossie 這個語意模型交換標準,能匯入匯出 YAML。也就是說,您手上既有的語意模型不必推倒重來,兩邊可以互轉,這一點對已經有資料倉儲治理體系的團隊比較友善。
代價與適用面
它不是裝完就能用的那一種。部署走 Docker Compose 或 Helm,需要一套 Postgres 17,還得接上 NVIDIA 的模型端點,託管版或自建都行,推理與向量化都從那裡走。預設設定裡連模型都是先放好的,要換模型得改環境變數。
適合的場景很明確:庫多、口徑亂、又想讓業務單位自己查資料。先把一兩個核心庫接進來,編譯一遍本體,人工認證幾十個術語,再放開給代理用,這條路是通的。不適合的場景也一樣明確:只有一個庫、欄位名稱本身就清楚的小團隊,這套東西的維護成本會超過收益。
Auto-Ontology 值得注意的地方,不是它能把問題翻成 SQL,而是它承認「模型不知道貴公司的口徑」,於是先把口徑做成人能審、機器能查的一層。數字對不對,最後仍要有人點頭;它做的是讓點頭這件事有地方落筆。