
Vidu sépare le son et le temps réel en deux gammes, et Q3 sort quatre pistes d'un coup
Résumé
Dialogue, narration, effets et musique sortent dans le même export que l'image, ce qui supprime le rendu muet suivi d'un doublage. La seconde gamme couvre le direct : l'avatar répond en conversation, et décors comme tenues changent sans interrompre le flux.
- Nom
- Vidu
- Version
- 20260916
- Tarif
- Gratuit
- Open source
- Propriétaire
- Système
- WindowsmacOSiOSAndroid
- Mis à jour
- 2026-10-06 16:30
Vidu vient de Shengshu Technology et se divise proprement en deux : une gamme Q de modèles vidéo et une gamme S bâtie autour du temps réel. La page d'accueil met en avant deux promesses — 16 secondes où l'image et le son arrivent ensemble, et l'interaction en direct. La première appartient à Vidu Q3, la seconde à Vidu S2.
Q3 est écrit pour la fiction, et le son part avec l'image
La page de Q3 se présente comme un modèle vidéo à support audio natif. Le titre annonce une fabrication pour la fiction, le sous-titre promet une scène complète d'un seul tenant, et l'explication de la sortie directe est concrète : le son et l'image quittent le système ensemble, avec quatre types de pistes — dialogue, narration, effets et musique — produites dans le même passage. Une scène finie atterrit donc en un seul export au lieu de passer par l'ancienne routine du rendu muet suivi d'un doublage.
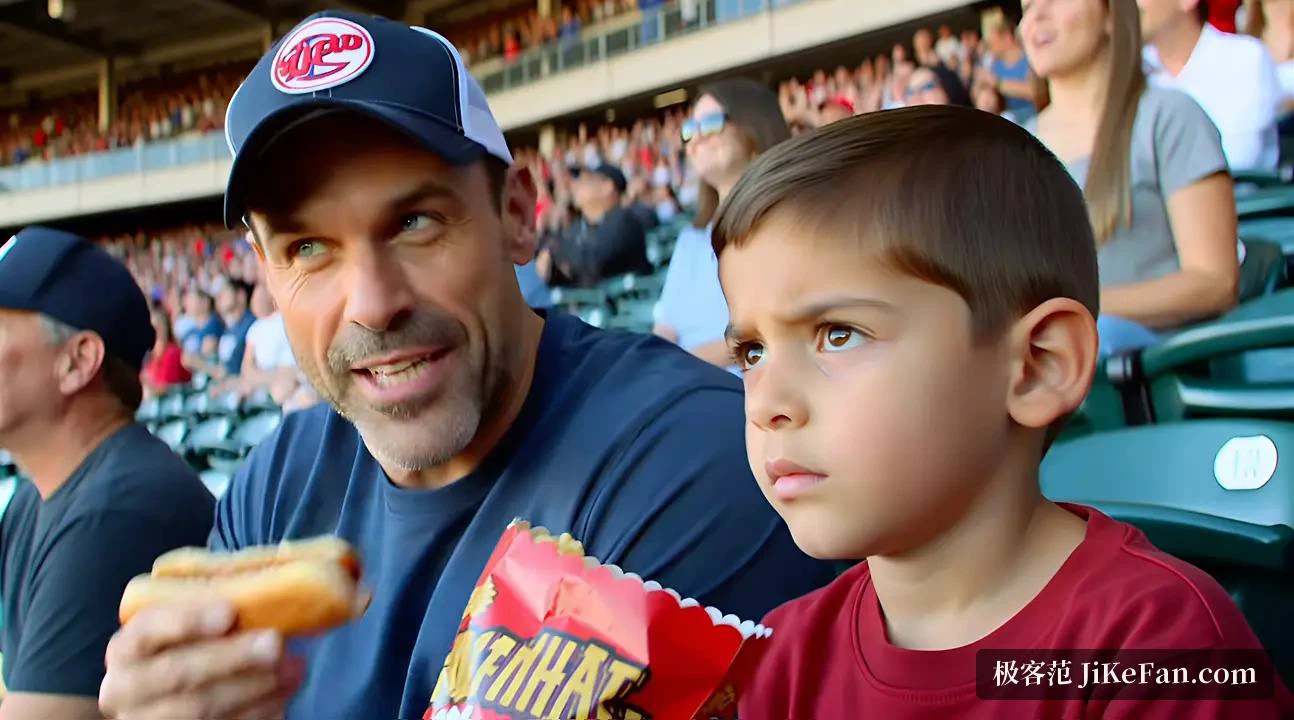
16 secondes en un passage, trois langues
La durée est le second chiffre net : une seule génération rend un clip complet de 16 secondes. La page justifie cela par l'absence de collage, donc par un rythme qui ne casse pas et une histoire qui avance ; la FAQ répond de la même façon, 16 secondes au maximum par passage. Côté langues, la ligne multilingue cite une sortie en anglais, en japonais et en chinois.
Pris ensemble, Q3 vise un seul problème : garder le son, le mouvement des lèvres et la langue alignés dans une courte unité narrative. Un point distinct traite le dialogue à plusieurs, pour que plusieurs personnages parlent naturellement dans la même prise au lieu d'être traités un par un.
Pour la fiction animée, les séries courtes et les plans cinématographiques
Un autre point revendique une maturité professionnelle : le modèle est pensé pour le travail narratif, fiction animée, cinéma, séries courtes. La FAQ décrit le public comme des créateurs et des équipes qui ont besoin d'une narration continue et d'un minutage précis — animation portée par l'intrigue, plans cinématographiques, drame court, publicité narrative. Le contrôle du plan travaille image par image, la langue de caméra et le rythme se spécifient jusqu'aux points narratifs, ce qui rapproche le travail de la mise en scène plutôt que du rendu. La page d'accueil élargit encore : animation ou prise de vues réelles, publicité ou court métrage, tout tient dans la même enveloppe de 16 secondes d'image et de son.
S2 sépare l'interaction en direct du montage en direct
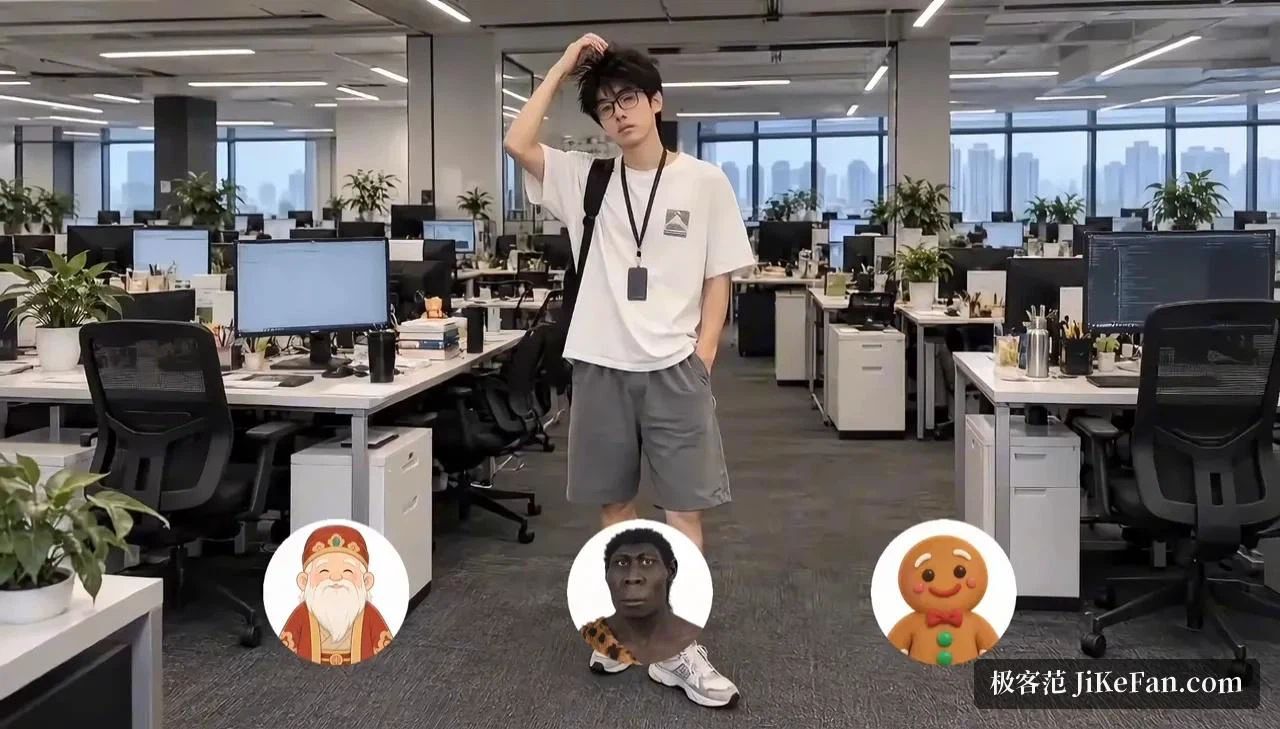
La gamme S raisonne autrement : générer et sortir en même temps. Sous S2 vivent deux produits. S2-Avatar est le modèle interactif, il prend la parole en direct et un contrôle gestuel complexe, s'appuie sur des images de référence pour l'interaction avec des objets, le changement de garde-robe et la substitution de décor, et rend l'humain numérique en 720P+ — contre 480P sur le S1 précédent, qui gagne aussi assez de suivi d'instructions pour qu'une consigne vocale fasse danser l'avatar. S2-Editing est l'éditeur en flux, et ses quatre capacités reposent sur une image de référence : rendre un style, remplacer un personnage, remplacer un environnement, ou habiller un sujet autrement. Parce qu'il fonctionne en flux, il continue d'absorber la vidéo et de pousser des résultats, si bien qu'un changement de référence ou de scène en cours de session n'interrompt pas la sortie. L'entrée peut venir d'une caméra, d'un fichier vidéo ou d'une image fixe.
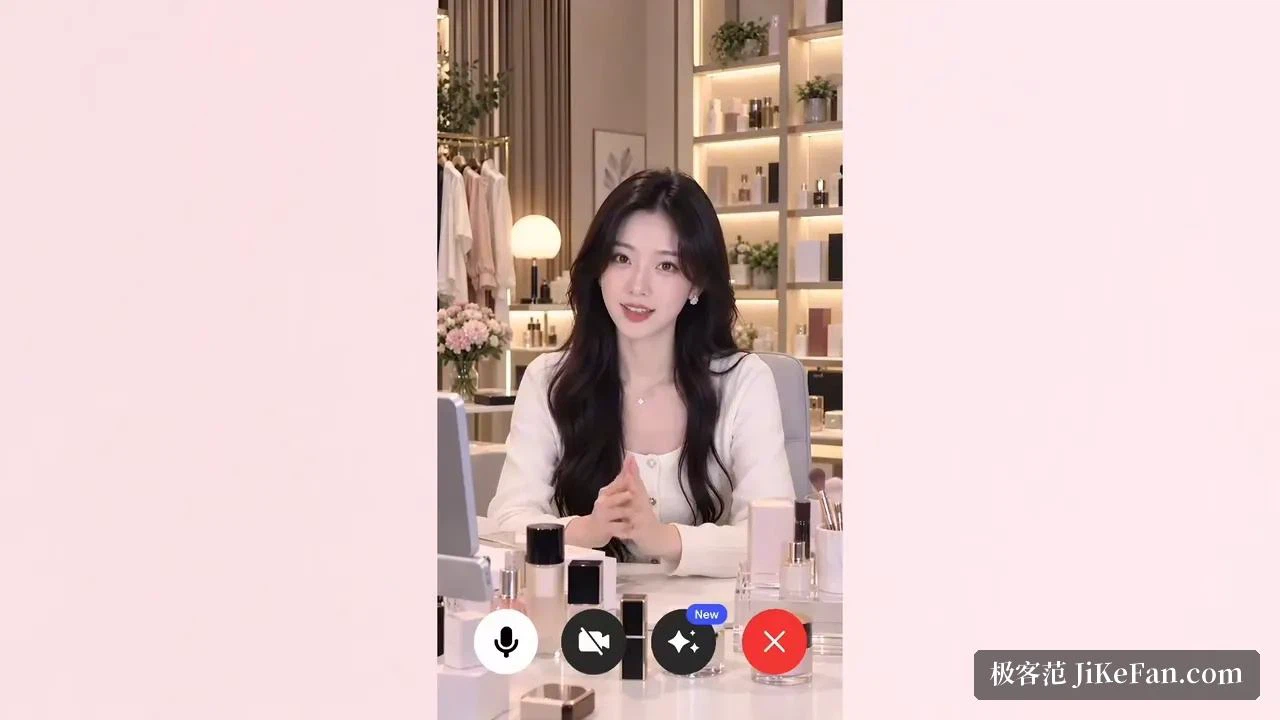
Quand le direct n'est pas nécessaire, S2 propose aussi une voie asynchrone : une image de personnage et une piste audio suffisent à produire une vidéo parlante dont les lèvres et les gestes suivent la piste — l'humain numérique hors ligne que mentionne la page.
API et facturation dans une seule monnaie
La plateforme ouverte range les modèles en trois familles : le temps réel S2, la gamme vidéo Q et la génération d'images. La ligne vidéo qualifie Q de gamme phare — longue durée, forte cohérence, mouvement ample — et couvre le texte-vers-vidéo, l'image-vers-vidéo et la référence-vers-vidéo. La ligne image indique que le texte-vers-image et la référence-vers-image atteignent une sortie 4K et acceptent plusieurs références. S2 passe par une plateforme MaaS qui expose trois étapes : s'inscrire et créer une clé d'API, envoyer une première requête, puis interroger la tâche et récupérer l'adresse de la vidéo.
La facturation repose sur des crédits, et un pack vise directement S2 : un lot à durée limitée de 350 yuans au lieu de 500 au tarif normal, avec 16000 crédits, 5 tâches simultanées et 12 mois de validité, que l'éditeur estime à environ 177 minutes d'interaction en direct. Un pack d'entrée à 500 yuans contient les mêmes 16000 crédits et couvre les tâches vidéo, audio et image. Les crédits existent en trois sortes : ceux d'abonnement, fournis avec une formule et valables 30 jours, ceux achetés à la demande, et ceux offerts par les opérations, les deux dernières valables 2 ans. Deux règles ressortent : l'achat est réservé aux comptes payants, et les crédits d'abonnement se consomment avant les crédits achetés.
Limites
16 secondes constituent le plafond d'un passage et aussi l'unité narrative que l'éditeur met en avant ; au-delà, il faut plusieurs segments ou une capacité d'extension ultérieure. Le direct dépend du réseau et de la concurrence, et le pack annonce 5 tâches simultanées, une équipe qui monte en charge doit donc composer avec ce chiffre. Les prix et les opérations bougent, et le palier à 350 yuans est une offre limitée : une décision d'achat devrait s'appuyer sur le tarif du moment et sur une estimation de la consommation de crédits. Le contenu produit doit toujours respecter les règles de la plateforme et le droit local, et un usage commercial mérite une vérification des droits sur les sources et sur les personnes représentées.
En résumé, cette vague fait du son une gamme et du temps réel une autre. Q3 réunit image, dialogue, narration, effets et musique dans une seule génération, 16 secondes à la fois en trois langues. S2 transforme l'humain numérique en un flux qui tient une conversation ou change de tenue et de décor en direct. En dessous, une plateforme ouverte facturée en crédits laisse à la création et à l'intégration chacune son chemin.