
CogVideoX en local : le code et les poids 2B sous Apache 2.0
Résumé
CogVideoX est la version open source du modèle derrière QingYing. Cinq checkpoints vont de 720 sur 480 à 1360 sur 768, le besoin mémoire tombe de 18GB à 3.6GB avec INT8, et les poids 2B partagent la licence Apache 2.0 du code.
Recommander- Nom
- CogVideoX
- Version
- 2
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinuxmacOS
- Mis à jour
- 2026-10-06 18:37
Qui a utilisé QingYing de Zhipu ne sait pas forcément que le modèle derrière est open source. Le dépôt officiel le dit sans détour dans la description du modèle : CogVideoX est la version open source du modèle de génération vidéo issu de QingYing. Autrement dit, la capacité pour laquelle on fait la queue dans un navigateur a un pendant que l'on peut ramener sur sa machine et faire tourner soi-même.
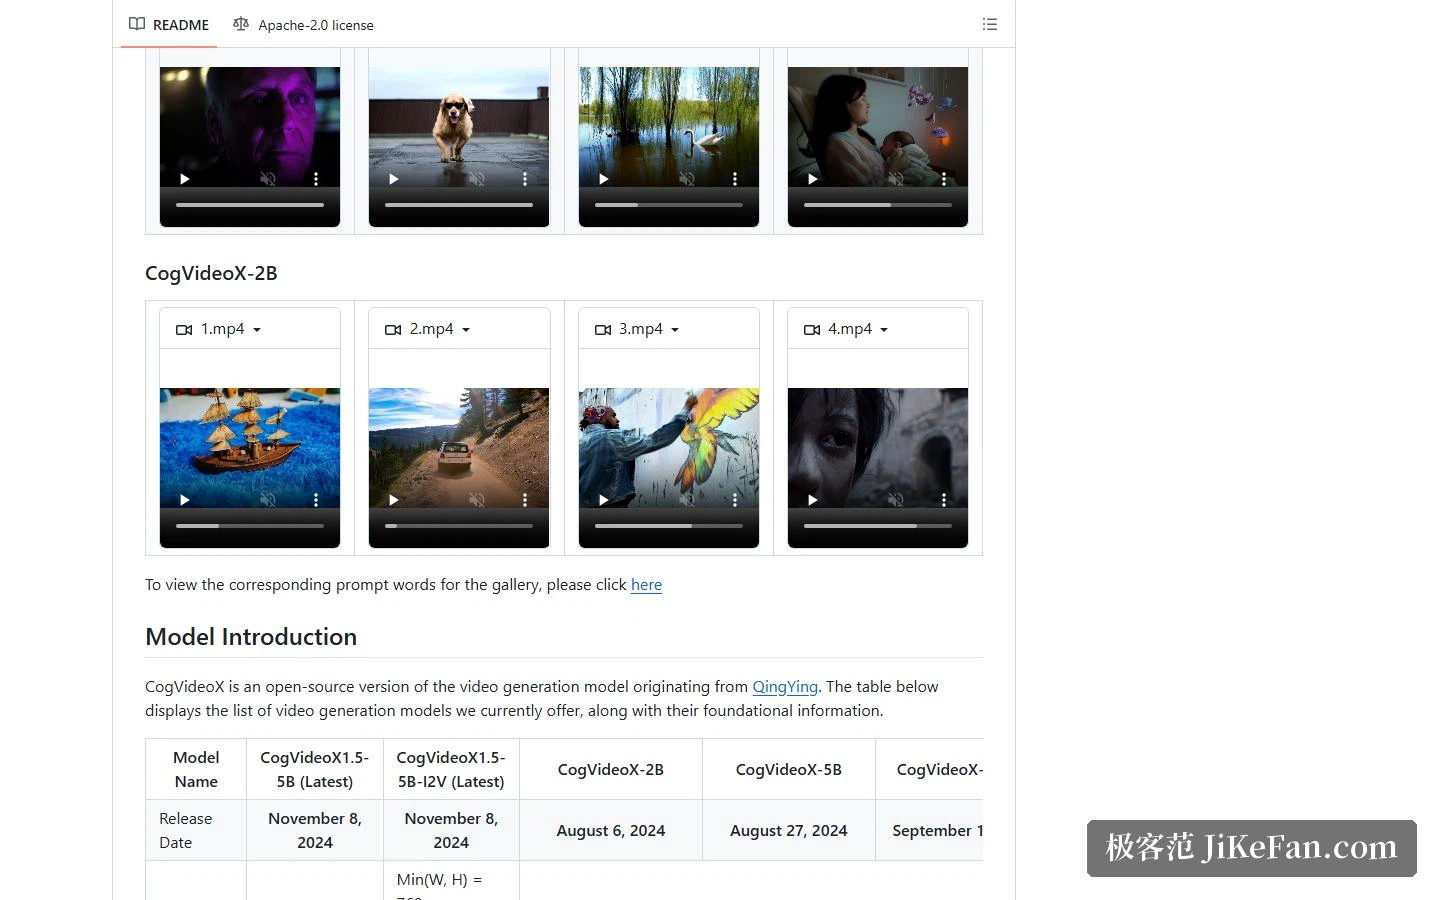
Les deux ne sont pas identiques, et la page fixe la relation dès le haut : pour le modèle commercial de plus grande échelle, il faut aller vers QingYing et la plateforme API ; ce dépôt fournit la version open source correspondante. La commerciale sert la génération en ligne à grande échelle, l'open source remet les poids et le code entre vos mains.
Cinq checkpoints, et les specs diffèrent
Le tableau des modèles liste tout ce qui est proposé aujourd'hui : CogVideoX1.5-5B, CogVideoX1.5-5B-I2V, CogVideoX-2B, CogVideoX-5B et CogVideoX-5B-I2V. Le suffixe I2V signifie image vers vidéo, les autres vont du texte vers la vidéo. Le rythme des publications montre l'évolution de la lignée : CogVideoX-2B le 6 août 2024, le 5B le 27 août, le modèle image vers vidéo 5B-I2V le 19 septembre, et la mise à jour 1.5 le 8 novembre.
Les spécifications séparent nettement les paliers. CogVideoX-2B sort du 720 sur 480 à 8 images par seconde pendant 6 secondes. CogVideoX1.5-5B monte à 1360 sur 768 à 16 images par seconde, sur 5 ou 10 secondes. CogVideoX1.5-5B-I2V applique une règle plus souple : le petit côté prend la plus petite valeur entre largeur et hauteur, soit 768, le grand côté se situe entre 768 et 1360 et doit être divisible par 16, et toute résolution dans cette plage passe. Du 720 sur 480 au 1360 sur 768, puis aux ratios souples de l'image vers vidéo, les formats de sortie courants sont largement couverts.
Mémoire et vitesse : est-ce que ça tourne chez vous
Les notes officielles donnent trois valeurs de mémoire, toutes sur CogVideoX-2B : SAT avec FP16 occupe 18GB ; sous diffusers en FP16 le plancher est de 4GB ; avec la quantification INT8 via torchao, cela descend à 3.6GB au minimum. La même note prévient que l'INT8 existe pour tenir sur des cartes plus modestes et ralentit l'inférence : ce n'est pas gratuit.
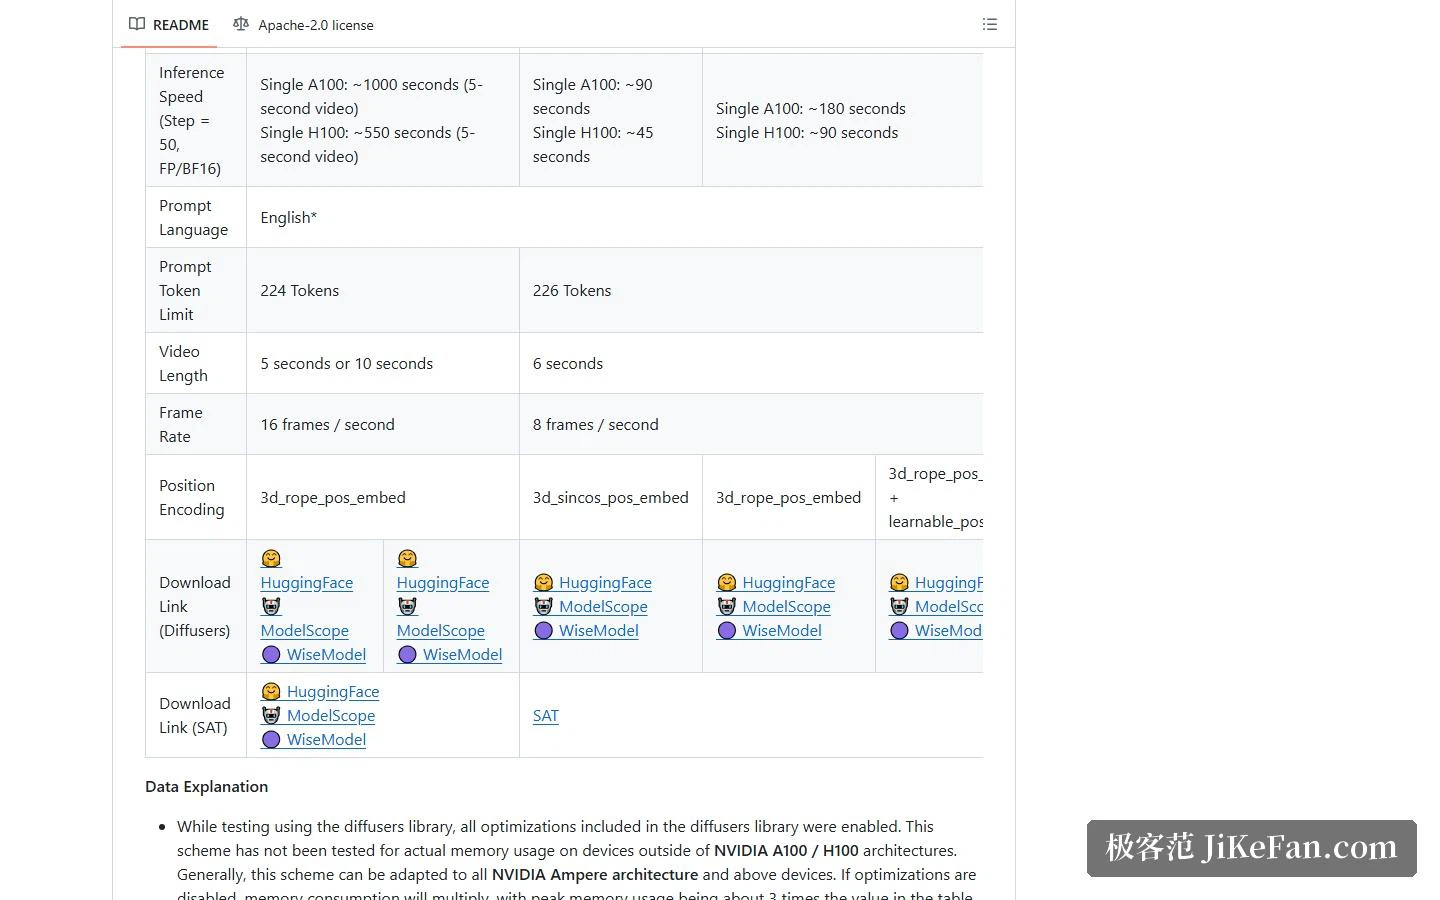
Côté vitesse, les conditions de mesure sont 50 pas en précision FP16 ou BF16. CogVideoX-5B demande environ 180 secondes sur une A100 seule et environ 90 secondes sur une H100 seule. Le plus récent CogVideoX1.5-5B, qui doit produire de la haute résolution sur 5 ou 10 secondes, demande environ 550 secondes pour un clip de 5 secondes sur une H100 dans les mêmes conditions : plus capable, au prix d'une attente visiblement plus longue. La note ajoute que ces tests activaient toutes les optimisations de la bibliothèque diffusers et n'ont pas vérifié l'occupation réelle hors A100 et H100 ; sans optimisations, le pic atteint environ le triple des valeurs du tableau.
Deux points à régler avant de commencer
D'abord la version de Python. Les deux chemins d'inférence, SAT et diffusers, énoncent la même exigence : Python entre 3.10 et 3.12, bornes comprises. Le dépôt contient deux bases de code ; SAT regroupe l'inférence et le fine-tuning des poids SAT, la variante diffusers documente plus en détail les paramètres courants et convient à un premier essai avant toute modification.
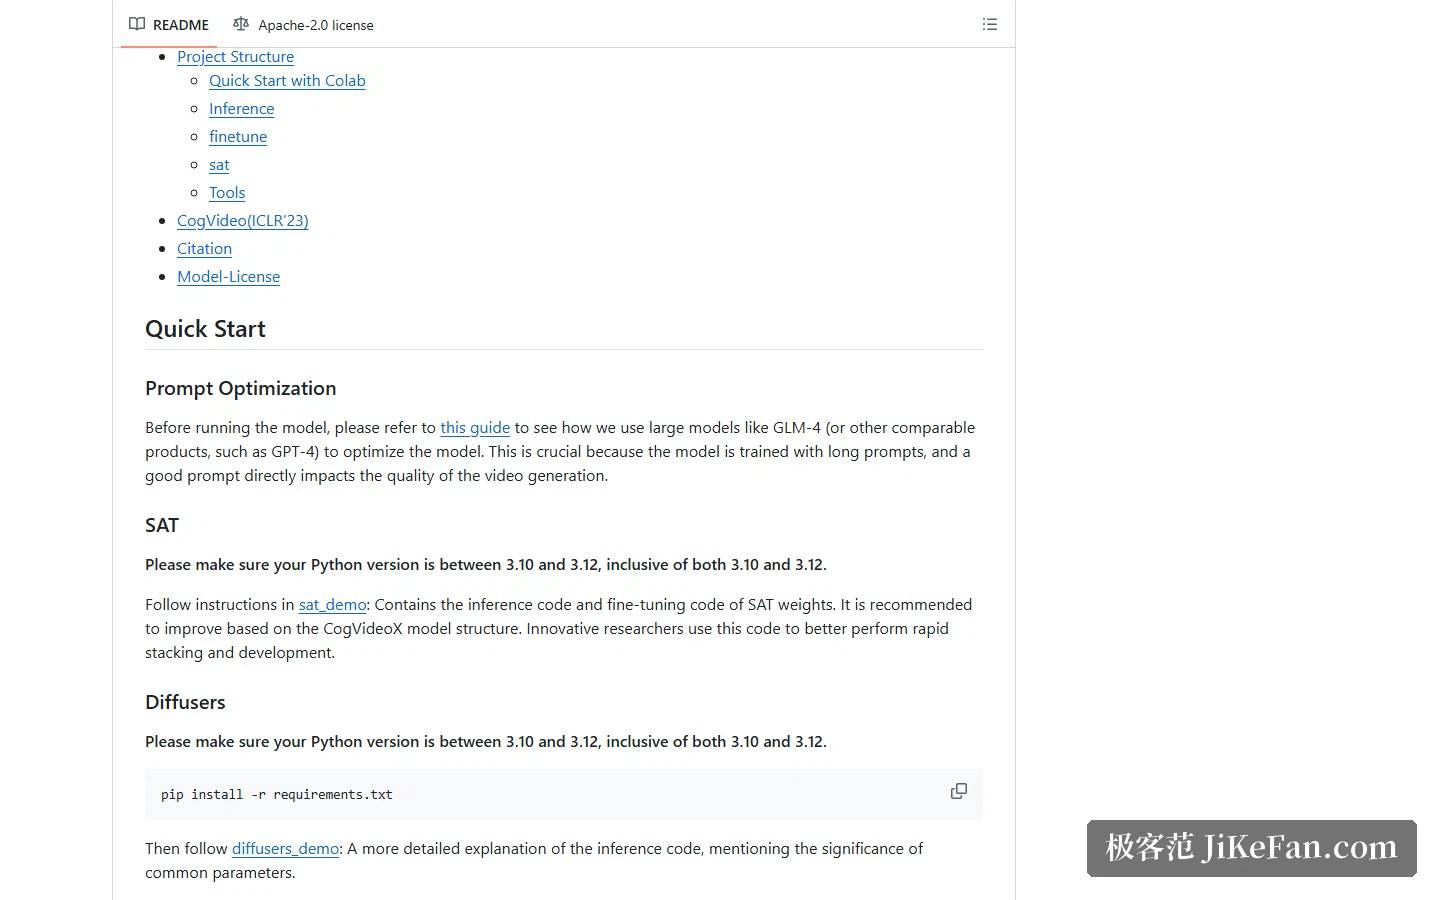
Ensuite la langue des prompts. Le modèle n'accepte que l'anglais, les autres langues doivent être traduites d'abord. La section sur l'optimisation des prompts conseille de passer par GLM-4 ou un grand modèle comparable pour travailler l'entrée en un texte long que le modèle attend : il a été entraîné sur des prompts longs, et la qualité du prompt se retrouve directement dans le résultat. Le dépôt fixe le plafond de longueur à 224 ou 226 tokens.
Licences : le code et les poids sont deux questions
Le code est publié sous Apache 2.0, sans ambiguïté. Les modèles se vérifient un par un : CogVideoX-2B, modules Transformer et VAE compris, est également Apache 2.0 ; CogVideoX-5B, soit le module Transformer incluant I2V et T2V, porte sa propre CogVideoX LICENSE. Si la latitude de licence compte dans votre cas, la limite est plus claire sur le palier 2B ; avant de vous engager sur 5B, lisez cette licence jusqu'au bout.
Ce que contient le dépôt
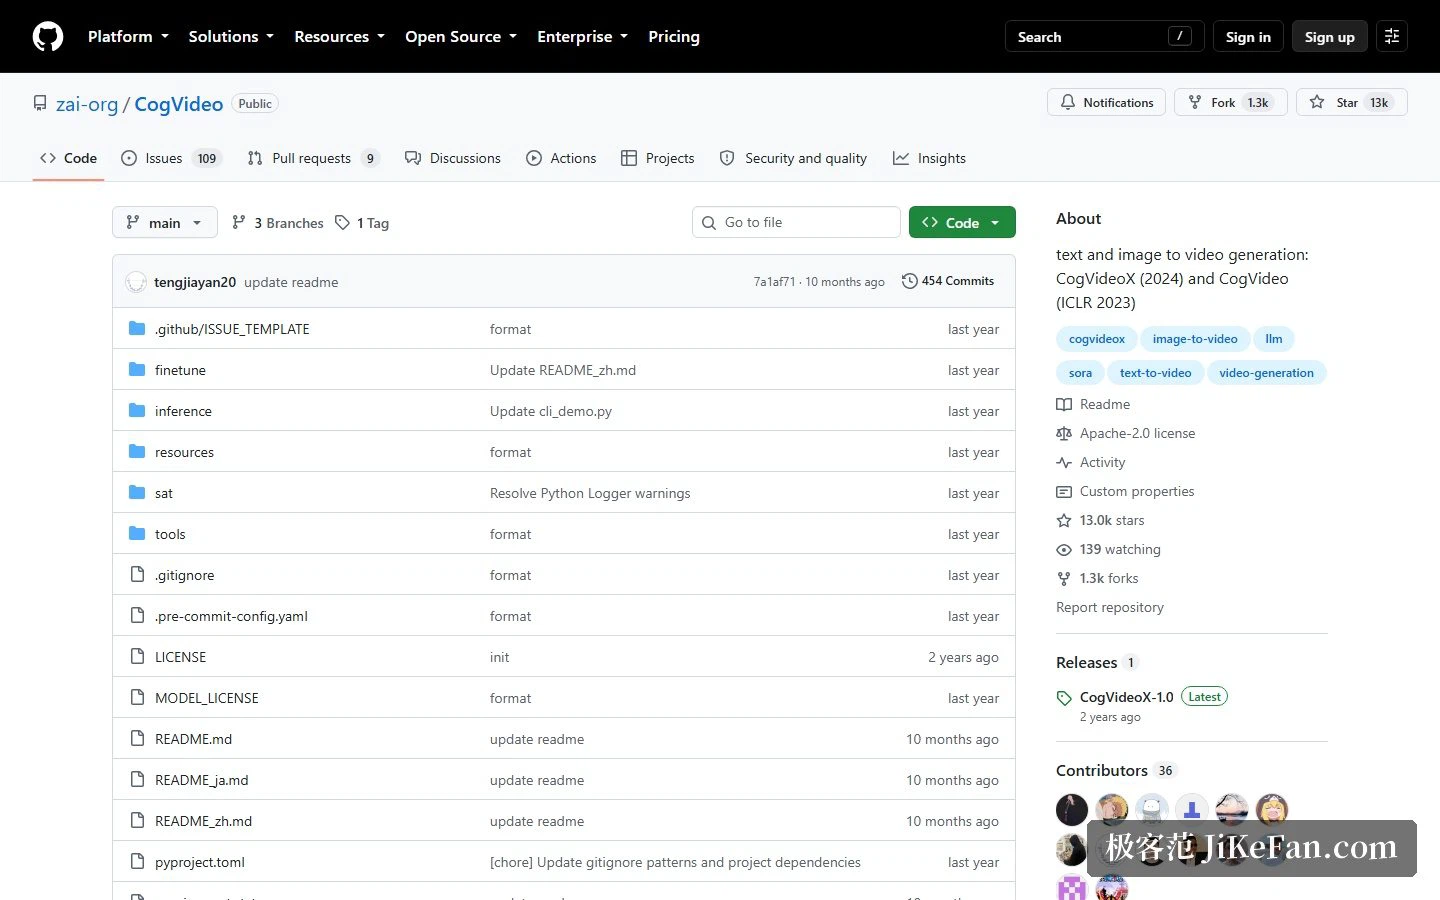
Le premier niveau est simple : sat et inference portent les deux bases de code d'inférence, finetune le fine-tuning, resources les ressources, tools les scripts utilitaires. La licence est répartie sur deux fichiers, LICENSE pour le code et MODEL_LICENSE pour les poids. Le dépôt compte aujourd'hui 13k étoiles et 1.3k forks, et la version enregistrée est CogVideoX-1.0.
L'année écoulée en mises à jour
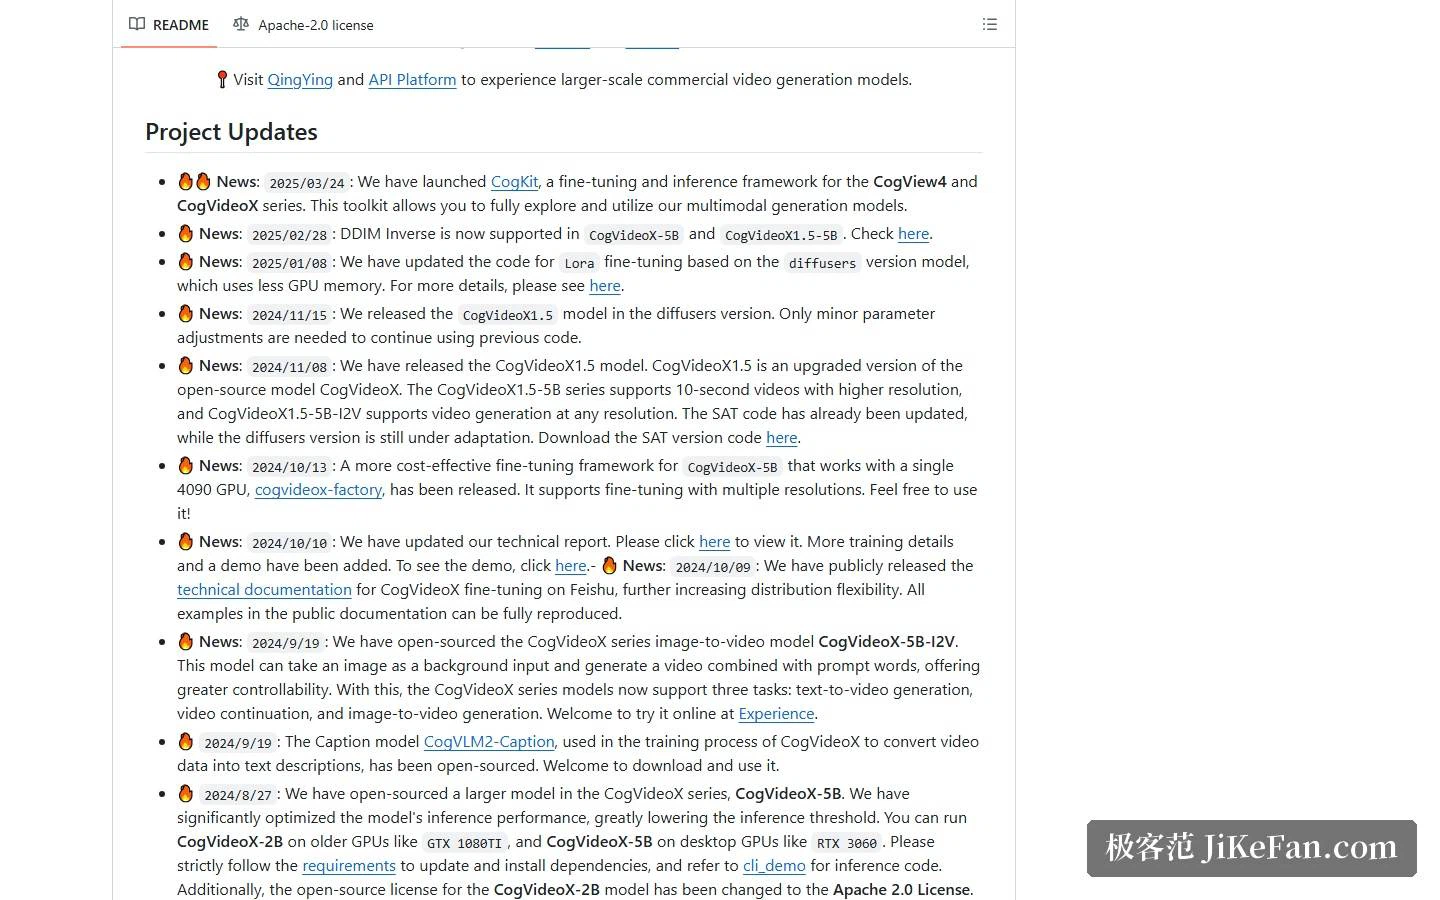
Le journal des modifications montre aussi la vitalité de la lignée. Mars 2025 a apporté CogKit, un cadre de fine-tuning et d'inférence pour les familles CogView4 et CogVideoX ; février a ajouté le support DDIM Inverse pour CogVideoX-5B et CogVideoX1.5-5B ; janvier a mis à jour le code de fine-tuning LoRA basé sur diffusers. Plus loin, le cadre publié en octobre 2024 a permis de fine-tuner CogVideoX-5B sur une seule 4090, et la note ajoute que CogVideoX-2B tourne sur des cartes plus anciennes comme la GTX 1080Ti, tandis que le 5B correspond à un palier bureau comme la RTX 3060.
À qui cela convient
Si vous voulez la génération vidéo dans votre propre flux sans dépendre de la file d'attente, du quota ou de la politique de contenu d'un service, CogVideoX offre une voie locale maîtrisable : poids ouverts, code ouvert, et un plancher de mémoire que l'on peut pousser à 3.6GB. Cela convient aux personnes qui ont une carte et la patience de travailler l'environnement — version de Python, dépendances, précision de quantification et langue des prompts se vérifient une par une.
À l'inverse, si vous générez un clip de temps en temps, ou si vous préférez ne pas gérer environnements et dépendances, un service en ligne demande moins d'efforts. L'exécution locale épargne les restrictions et coûte du temps plus une carte capable de suivre.
Un point à savoir d'avance : le modèle ne mange que des prompts en anglais. Un utilisateur francophone doit donc résoudre l'étape qui consiste à transformer une idée en longue description compréhensible par le modèle — et la qualité de cette étape pèse souvent plus que le passage à un checkpoint plus gros.
La vraie valeur d'un modèle ouvert n'est pas de reproduire toutes les capacités d'un service en ligne. Elle est de ramener la génération sur votre propre machine. Vérifiez d'abord si la carte et l'environnement peuvent l'accueillir, on parlera des résultats ensuite.