
Umi-OCR 2.1.5 lit le texte hors ligne
Résumé
Umi-OCR 2.1.5 reconnait le texte des captures, des dossiers d images et des PDF scannes sans reseau, avec selection a la souris et zones ignorees.
Recommander- Nom
- Umi-OCR
- Version
- 2.1.5
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsLinux
- Mis à jour
- 2026-11-14 23:00
Une page scannee, une capture d ecran, une image recue par message: les caracteres sont la, et le seul moyen de les faire entrer dans un document consiste a les taper un par un. Qui l a fait une fois s en souvient. La reconnaissance en ligne epargne la peine, au prix du fichier confie au serveur d autrui, ce qui exclut la methode sur une machine isolee, pour du materiel confidentiel, ou simplement pour qui n aime pas le detour. Umi-OCR prend une autre position: le moteur reste sur la machine et tourne sans connexion. Le projet est libre, ecrit en Python et Qt sous licence MIT, le paquet se deplace et fonctionne sans environnement supplementaire, des versions existent pour Windows et Linux, et l interface parle plus de douze langues.
La page du projet se decrit avec retenue: un outil OCR hors ligne, gratuit, libre et capable de traiter par lots. Trois proprietes, aucun adjectif.
Apres la capture, le texte se selectionne
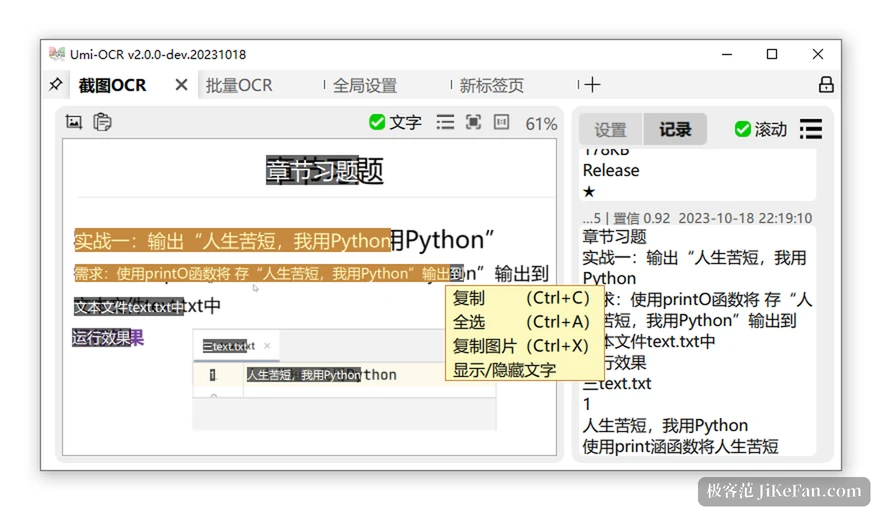
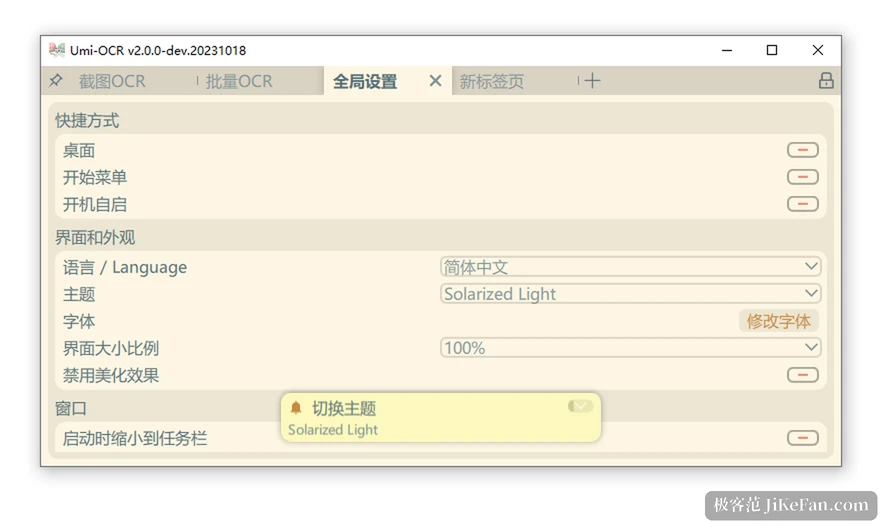
La fenetre principale s organise en onglets: reconnaissance de captures, reconnaissance par lots et reglages generaux, avec la possibilite d en ouvrir d autres. Sur la page de capture, l image prise occupe la gauche, reglages et historique la droite. Une fois la reconnaissance finie, le texte de l image se selectionne a la souris, tandis que l historique liste chaque resultat du plus recent au plus ancien, chaque ligne portant un indice de confiance. Un chiffre comme 0.92 n a rien de joli, mais il dit honnetement a quel point cette ligne est sure, ce qui designe les endroits a relire.
Depuis 2.1.5 la plupart des onglets passent d une disposition cote a cote a une disposition empilee, si bien qu un ecran etroit pousse l historique dessous et laisse plus de place a l image. La touche echappement cache la fenetre, un raccourci laisse pour ceux qui capturent toute la journee.
L analyse de mise en page remet les blocs en phrases
Le peche originel de la reconnaissance n est pas le caractere faux mais deux colonnes versees dans un seul pot selon l ordre de lecture. Umi-OCR inclut une analyse de mise en page dans le post-traitement, avec des schemas a plusieurs colonnes, une colonne et une ligne, qui rearrangent le resultat pour que la sortie suive l ordre de lecture humain. Le schema a une ligne traite un autre cas courant: il insere un espace entre deux blocs eloignes, pour que les phrases ne se collent pas.
Ces details n apparaissent sur aucune liste de fonctions. Ils se remarquent au moment ou un long passage est copie et qu aucune ponctuation ne demande plus la main.
La page des lots est une petite chaine de production
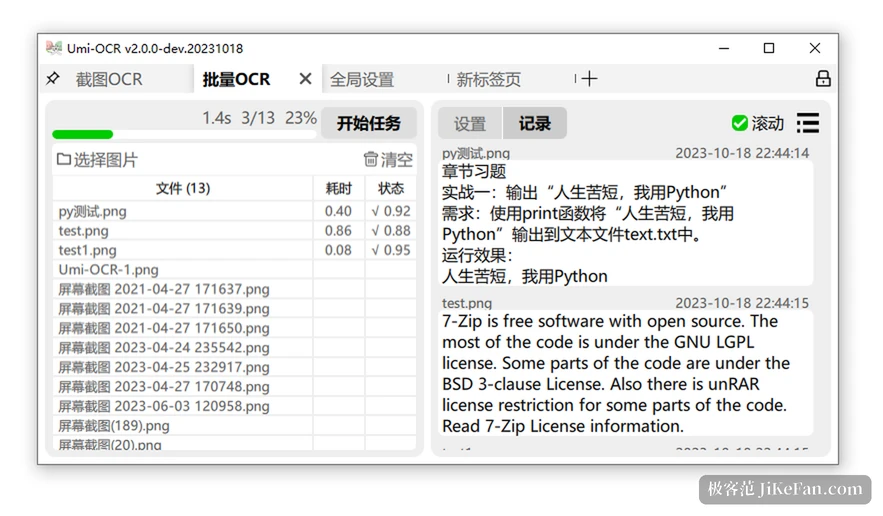
A gauche, une liste de fichiers donne nom, duree et etat, et la coche de la colonne d etat est suivie du meme indice de confiance. Une barre en haut annonce les images terminees et un pourcentage. L historique groupe les resultats par fichier: un clic sur une image montre son resultat, un defilement vers le bas montre ce que le reste du lot a produit.
Ce qui fait gagner du temps n est pas la simultaneite mais la lecture pendant le travail, car un fichier termine entre dans la liste sans attendre la fin du lot. La version 2.1.5 charge images et documents de facon asynchrone, si bien qu un dossier de dizaines de milliers de sous-fichiers s ouvre sans a-coups et la barre suit. La meme page connait les zones ignorees: on trace un rectangle et le texte qu il contient ne participe pas a la reconnaissance, ce qui ecarte d un coup coins marques, filigranes et horodatages.
Les PDF scannes se lisent aussi
La reconnaissance de documents traite les PDF sous deux formes. Un scan n a aucune couche de texte et depend de la reconnaissance pour en obtenir une; un fichier ne numerique porte deja une couche qu il suffit d extraire, ce qui epargne le travail. La sortie prend deux chemins: du texte brut, ou un PDF double couche cherchable ou la page semble intacte et une couche invisible de caracteres repose dessous, si bien que recherche et copie fonctionnent normalement dans n importe quel lecteur.
La version 2.1.5 a repare deux defauts dans ce domaine: le texte existant disparaissait quand une page etait tournee, et le texte d origine n etait pas ecrit lors de la creation d un PDF a une seule couche. Pour des contrats et des manuels destines a l archive, ces deux points pesent plus que n importe quelle nouveaute.
Etre appelable depuis un autre programme, le vrai usage
Hors de la fenetre, deux entrees existent. La ligne de commande prend des instructions au lancement et accepte des taches a distance pendant l execution; une interface HTTP transforme le programme en service local ou captures, images et PDF partent en requete, la reponse portant coordonnees et confiance pour chaque ligne. Sous Linux, l ensemble tourne aussi en conteneur dans une chaine existante.
La journalisation ajoutee en 2.1.5 existe pour cette route: lance avec les bons arguments, le programme montre un journal vivant, et au dela d un niveau choisi les entrees tombent dans le dossier de journaux, si bien qu une reconnaissance ratee ne se devine plus. La meme version a ajoute une commande pour recharger la configuration, ce qui evite un redemarrage apres un changement de parametre.
Deux limites a connaitre d avance
Le moteur arrive sous forme de module, et les versions sont reparties en deux paquets selon le moteur. Le rapide exige certains jeux d instructions du processeur, si bien que Pentium, Celeron et Atom refusent de le lancer; quand l initialisation echoue, la version compatible est la reponse. C est une limite du cadre d inference et non un defaut, et la documentation le dit franchement.
L autre limite: il reconnait du texte et ne reconstruit pas la mise en page. Un tableau sort comme un flux de mots, et garder la structure demande de rearranger a la main. Les langues de l interface depassent la douzaine, entretenues par une plateforme de traduction communautaire, chinois et anglais compris.
A quoi cela sert
Replace dans une journee de travail, Umi-OCR 2.1.5 resout un probleme etroit: transformer les caracteres contenus dans des images et des scans en texte copiable, cherchable et transmissible a un autre programme, sans que le processus quitte la machine. Selection dans une capture, lot en file, zones ignorees, PDF a deux couches, ligne de commande et interface couvrent ensemble la distance entre l usage occasionnel et une etape dans une automatisation. Gratuit, libre, sans compte, sans connexion: pour qui manipule du materiel sensible, ces trois points suffisent comme raison de choisir.