
SWE-agent : confiez-lui un rapport de bogue, il lit le code, modifie les fichiers et rend un correctif
Résumé
Un agent de recherche qui prend un seul rapport de bogue et mène la réparation jusqu'au bout : il clone le projet, lit la description, cherche les fichiers concernés, les modifie, lance les tests et rend un correctif fusionnable. Sa vraie contribution n'est pas le modèle mais l'interface repensée pour lire et modifier du code.
Recommander- Nom
- SWE-agent
- Version
- 1.1
- Tarif
- Payant
- Open source
- Open source
- Système
- LinuxmacOS
- Mis à jour
- 2026-10-06 07:31
Les projets ouverts et les petites équipes partagent la même position gênante : la pile de rapports non traités grandit, et le nombre de personnes capables d'en prendre un reste exactement au même niveau. La plupart des assistants de programmation s'arrêtent à aider à compléter les lignes devant vous — frappe plus rapide, mais personne n'accompagne un bogue du début à la fin. Ce projet prend l'autre chemin et confie le travail entier.
SWE-agent a été construit par des chercheurs de deux universités et publié en logiciel libre. Donnez-lui l'adresse d'un rapport de bogue et il clone le projet correspondant, lit la description, cherche dans le code les endroits concernés, détermine ce qui ne va pas, modifie les fichiers, lance les tests pour confirmer que rien d'autre n'est cassé, et produit un correctif qui peut être soumis comme demande de fusion. Tout se passe dans un environnement isolé, sans personne à côté pour approuver chaque étape.
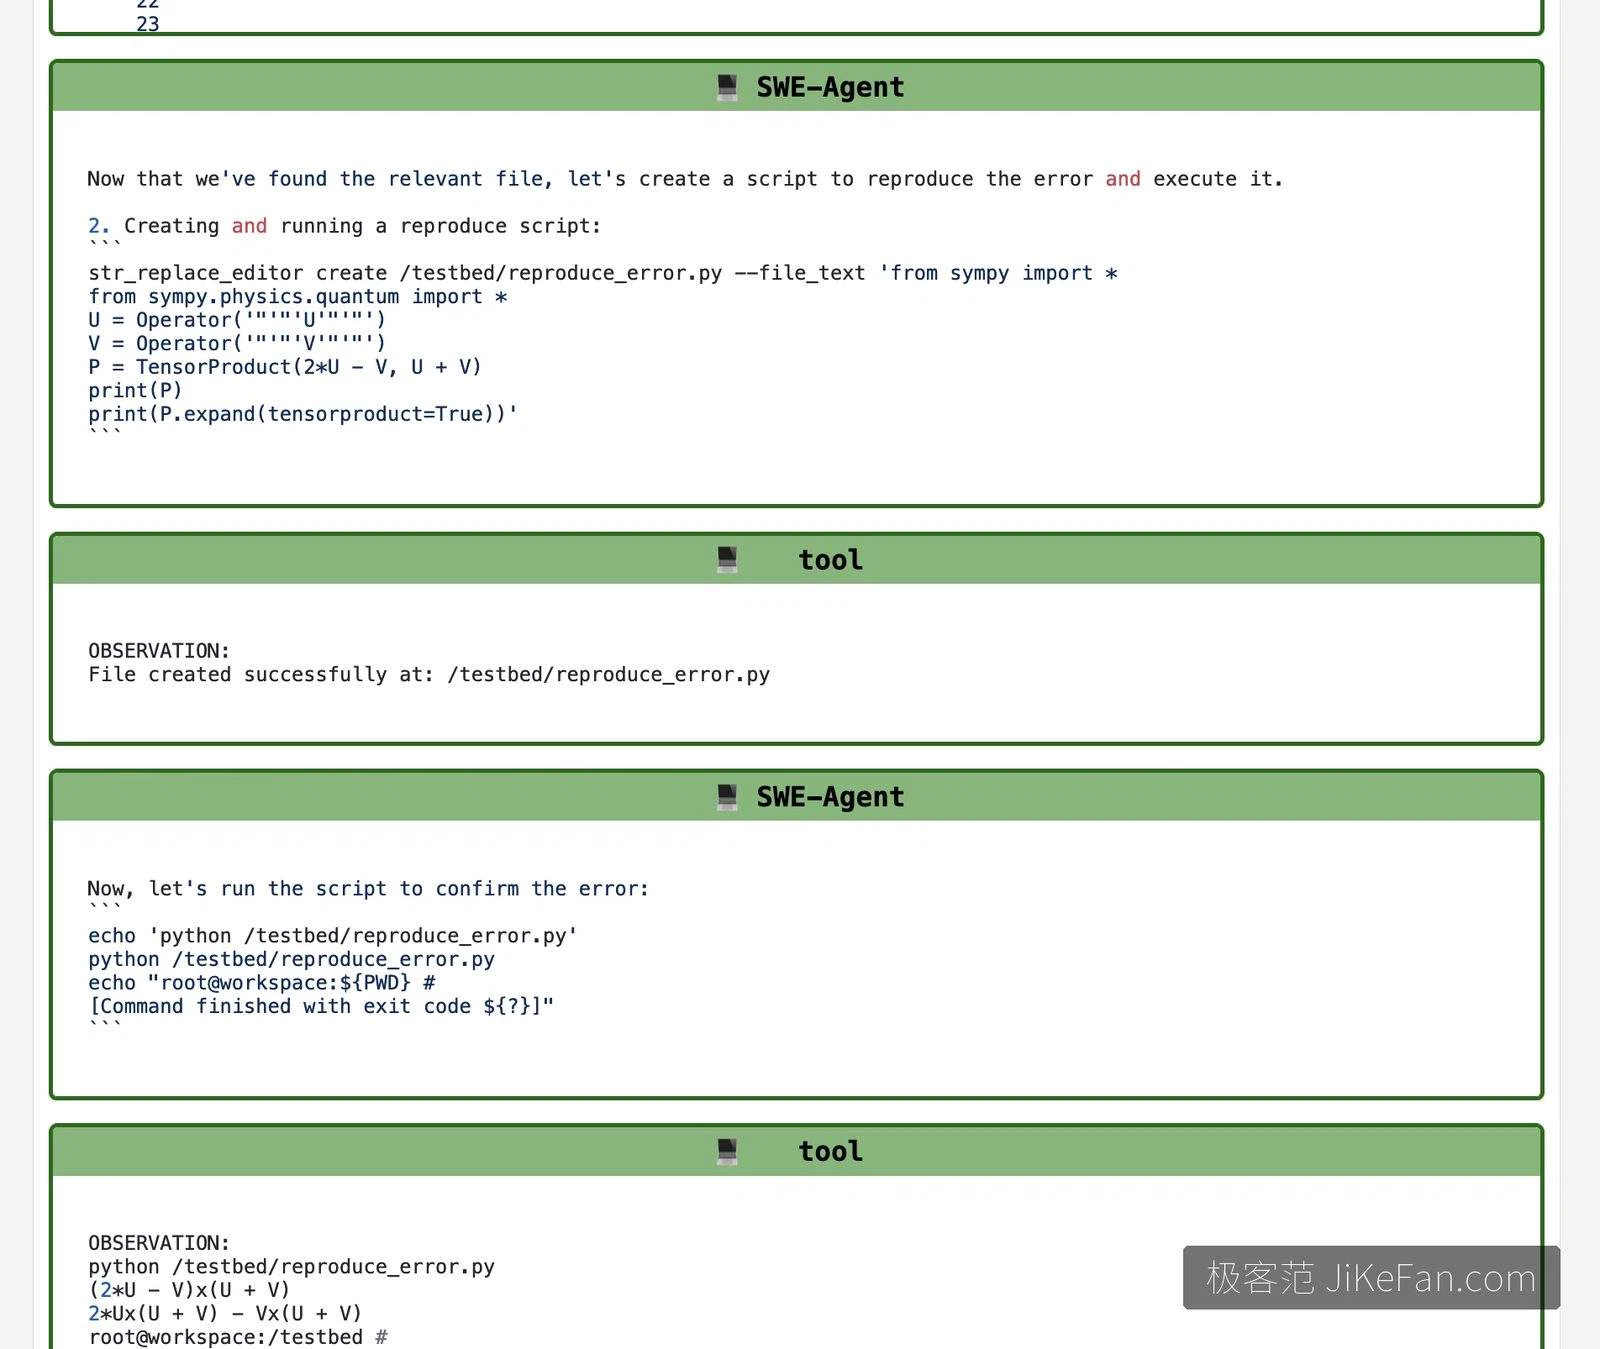
Pas de la complétion, mais une réparation menée jusqu'au bout
L'approche est apparue en 2024. Sur une base d'évaluation publique constituée de vrais rapports, il a résolu 12,29 pour cent des problèmes, à quatre-vingt-treize secondes en moyenne chacun. C'était la première fois qu'une approche ouverte atteignait un chiffre à deux chiffres, et cela a transformé la question de savoir si un modèle peut réellement corriger un bogue, d'une opinion en une mesure. À mesure que les modèles progressaient, une version majeure ultérieure a plusieurs fois battu le meilleur résultat ouvert sur ce type d'évaluation.
Le point n'est pas le modèle, mais les outils qu'il tient
Lâchez un modèle de dialogue ordinaire dans un vrai dépôt et il se perd le plus souvent : trop de fichiers, plus de contexte qu'il n'en tient, et une seule réponse mal formée ruine tout ce qui précède. L'apport central du travail qui l'accompagne est une interface entre l'agent et la machine — pas un terminal brut confié au modèle, mais un jeu de commandes repensé pour le travail précis de lire et modifier du code.
Les détails sont concrets. La visionneuse de fichiers montre environ cent lignes par tour, ce qui tombe justement dans la plage où un modèle lit avec précision. La commande d'édition vérifie d'abord la syntaxe et refuse d'appliquer une modification invalide. Une recherche sur tout un répertoire ne renvoie que les noms des fichiers trouvés au lieu d'emplir le contexte. Une commande sans sortie reçoit une réponse explicite disant qu'elle a réussi et n'a rien affiché. Cela ressemble à des détails et c'est exactement ce qui empêche un modèle de s'effondrer sur une longue tâche ; le travail confirme que le même modèle se comporte bien plus mal sans interface ajustée.
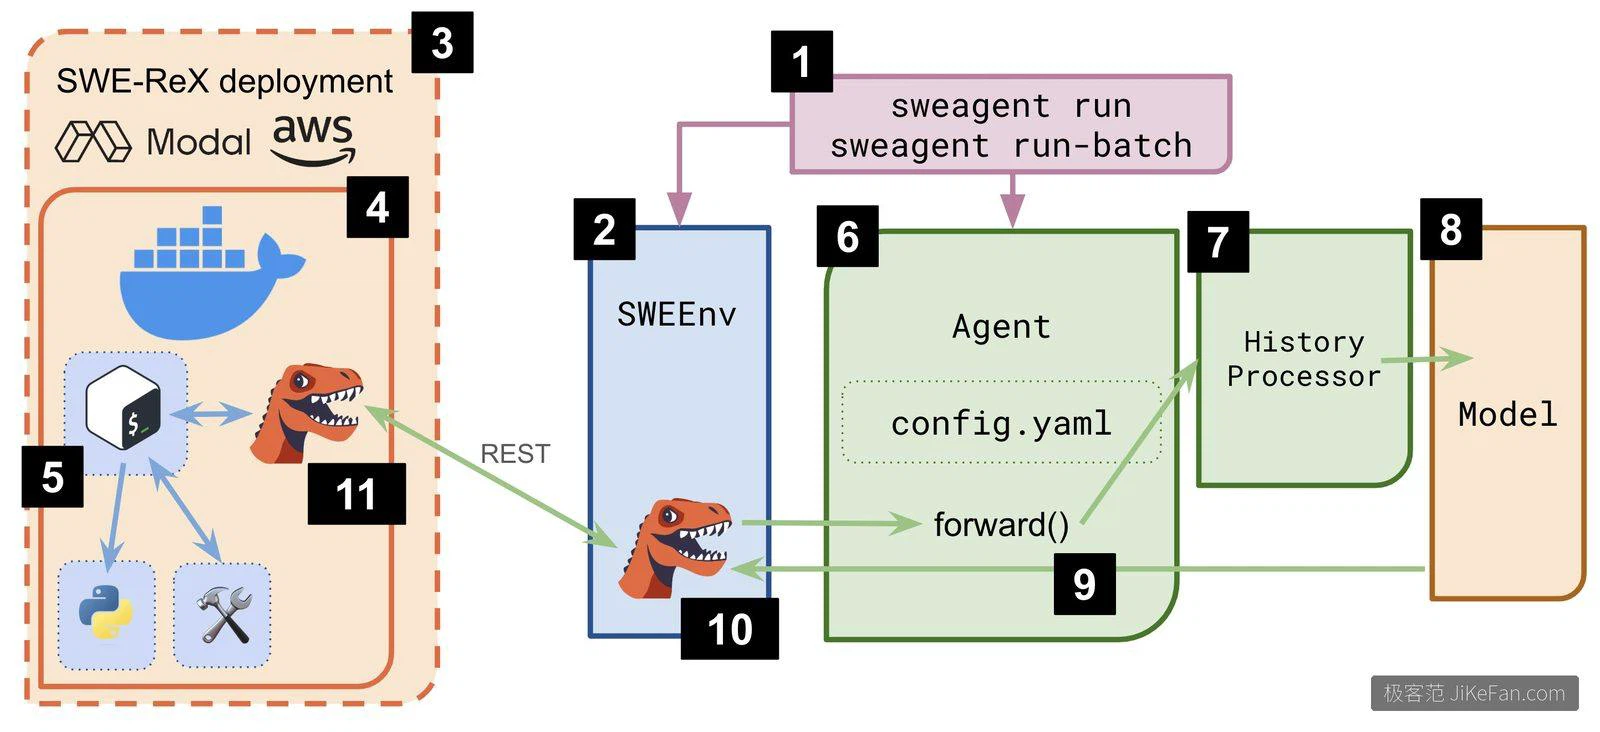
N'importe quel modèle, un seul fichier de configuration
Aucun fournisseur n'est lié ici. Les modèles commerciaux et les modèles ouverts tournant en local se raccordent tous deux, et le modèle et ses paramètres tiennent dans un seul fichier de configuration, si bien que changer revient à modifier une ligne plutôt que le code. Cela le rend étonnamment adapté à la comparaison de la force de différents modèles sur une même tâche.
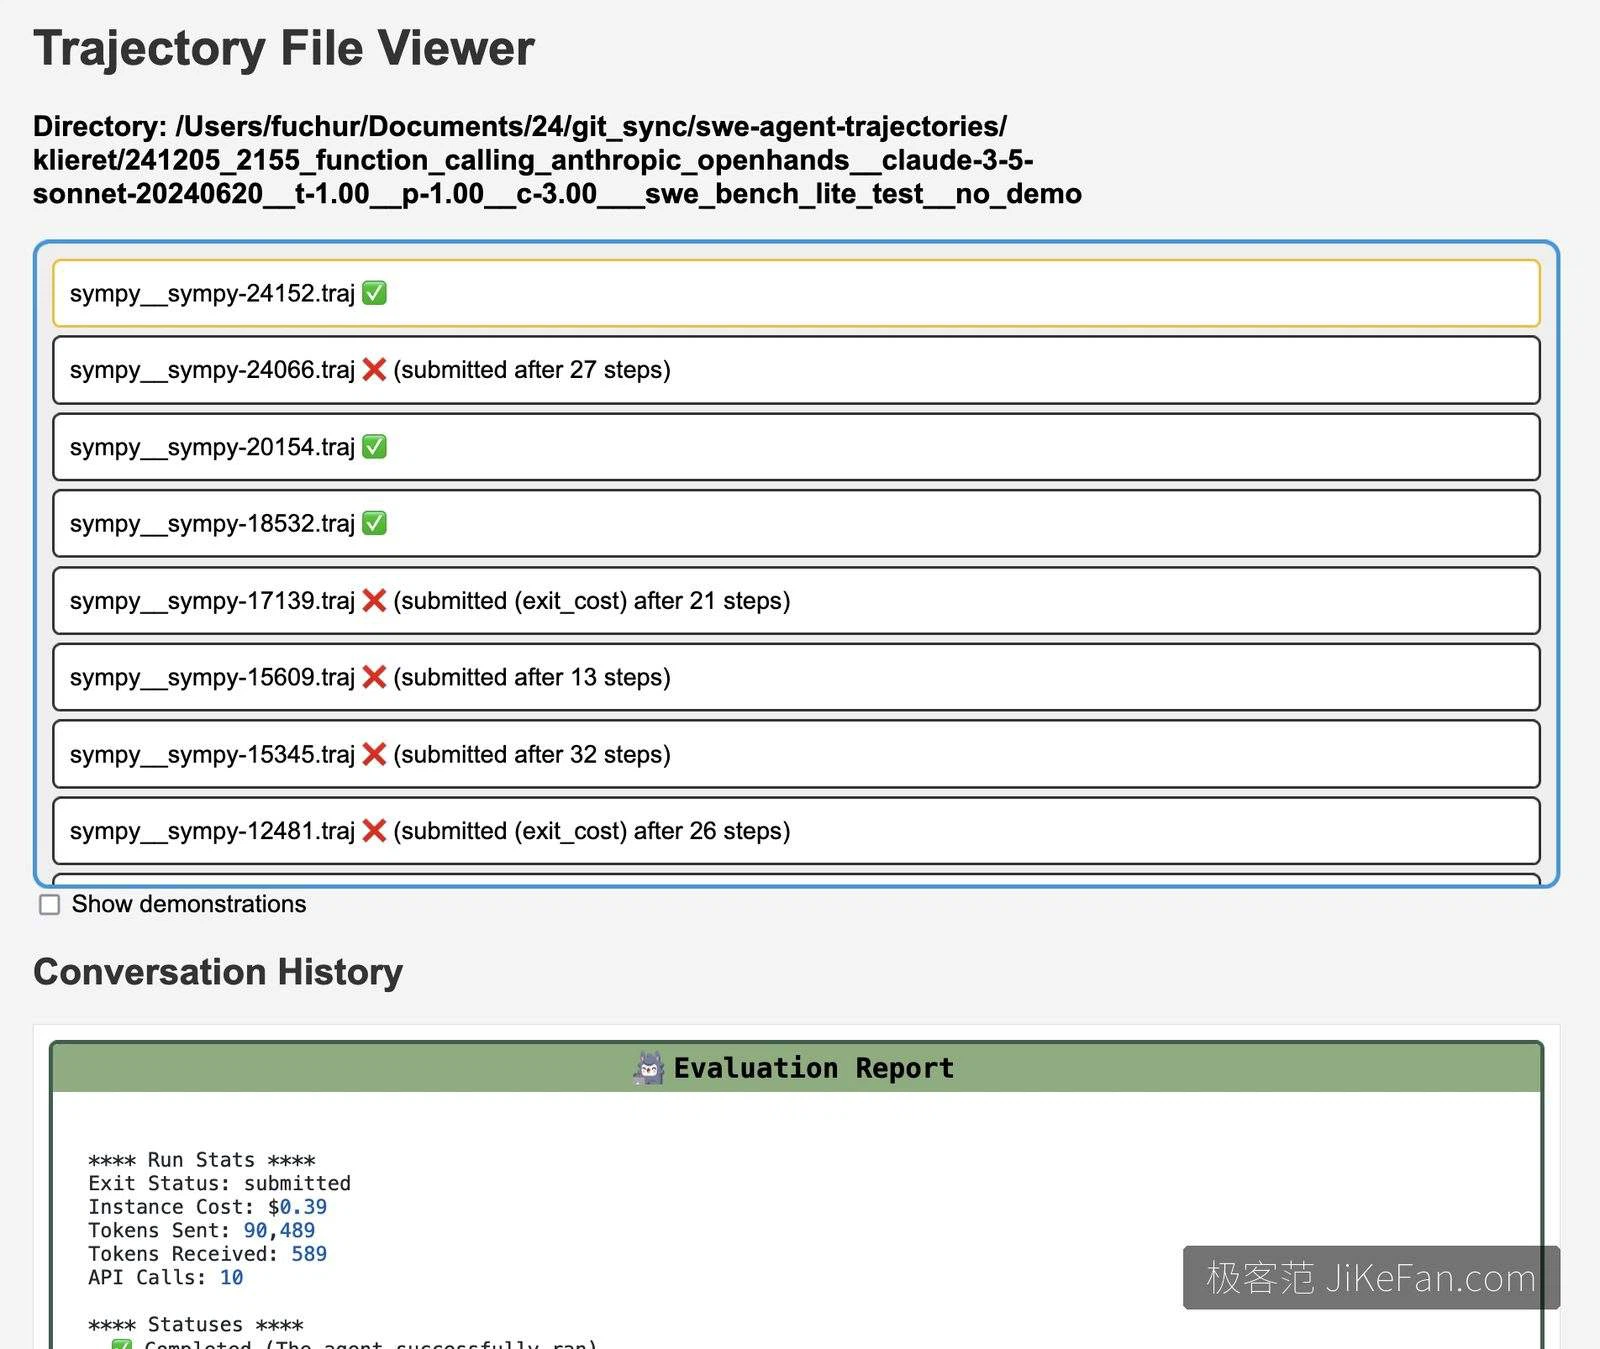
L'isolement est confié à des conteneurs : chaque exécution a lieu dans un bac à sable et ne peut rien abîmer sur votre machine. Des dizaines ou des centaines de rapports se traitent en lots parallèles. Un parcours complet est conservé ensuite — quel fichier a été lu, ce qui a été cherché, ce qui a été modifié, tout est traçable — et une visionneuse en ligne montre, étape par étape, ce que chacune a coûté et combien d'unités elle a consommées.
Corriger des bogues n'est qu'un début
La même charpente fait autre chose. Des équipes l'ont employée pour des compétitions de sécurité, où elle a atteint des places de tête sur les tableaux concernés, et pour des problèmes de programmation de concours ; tout ce qui peut se décrire comme agir dans un environnement jusqu'à atteindre un but peut s'y raccorder. Le projet est ouvert de bout en bout — auditable, modifiable, reproductible —, ce qui explique que la littérature académique le cite sans arrêt.
Où il en est aujourd'hui, sans détour
En juillet 2025, la même équipe a publié une version plus légère : une centaine de lignes de Python, tous les outils maison retirés, un shell élémentaire pour seul reste, et toujours environ soixante-cinq pour cent des problèmes de validation résolus. Leur recommandation actuelle est que la plupart des nouveaux venus commencent par là ; SWE-agent lui-même est passé en maintenance, les nouvelles fonctions ne sont plus le centre.
Cela clarifie les cas où il reste le bon choix : une chaîne d'outils demandant une configurabilité profonde, des expériences sur différentes manières de traiter l'historique, ou une recherche sur ce que devrait être une bonne interface d'agent. C'est de l'infrastructure de recherche, pas un produit emballé. Fin 2026, le dépôt avait dépassé vingt mille étoiles et deux mille embranchements, et la base d'évaluation qui l'accompagne est devenue l'étalon public incontournable du domaine.