
Firecrawl à l'essai : la couche qui transforme une page en nourriture pour agents
Résumé
Recherche, extraction et interaction passent par une seule interface, et l'on récupère du markdown propre, du JSON calé sur un modèle ou une capture. Proxys, anti-robots et rendu sont l'affaire du service — c'est-à-dire la partie ingrate.
Recommander- Nom
- Firecrawl
- Version
- v2.11
- Open source
- Open source
- Système
- WebLinuxmacOSWindows
- Mis à jour
- 2026-10-06 06:29
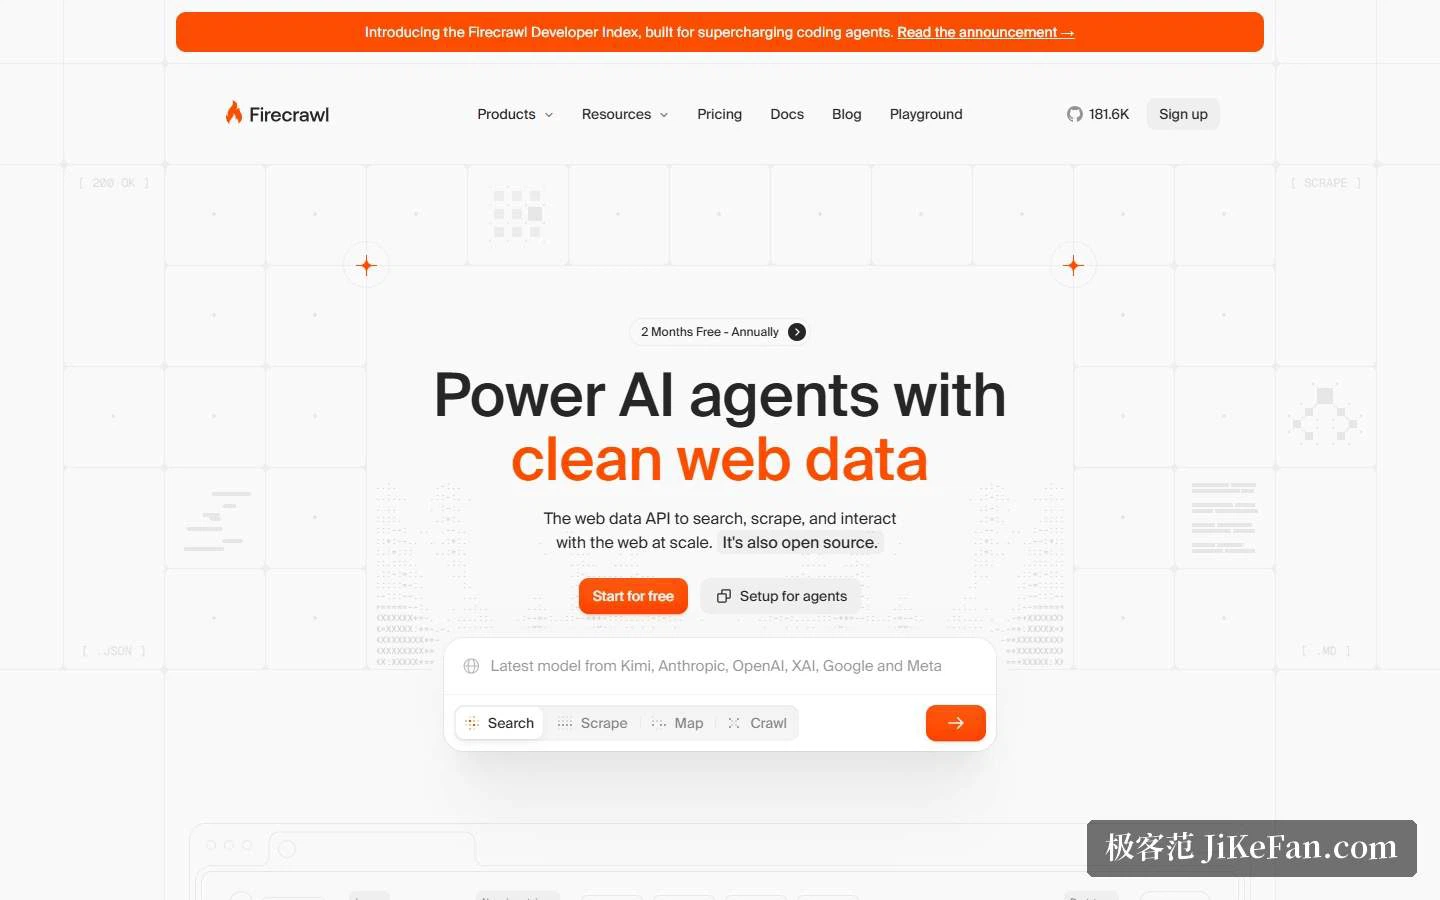
Quiconque a nourri un agent avec des pages web sait où se trouve la douleur : la cible se défend, le contenu n'apparaît qu'après l'exécution de scripts, et le corps de l'article se mélange à la navigation et à la publicité. Ce produit coupe précisément à cet endroit. Il se présente comme une interface de données web — envoyer une adresse, recevoir du markdown propre ou du JSON structuré — et le sale travail se fait côté serveur. Le slogan de la page d'accueil est explicite, et le projet est aussi open source, ce qui explique comment le dépôt a réuni un peu plus de 180 000 étoiles.
Trois métiers : chercher, extraire, interagir
Le cœur se divise en trois. Search cherche des pages et rapporte avec elles le texte intégral des résultats, ce qui convient au schéma « trouver puis lire ». Scrape transforme n'importe quelle adresse en markdown, JSON ou capture d'écran, et pour une sortie structurée il suffit de fournir un modèle JSON pour récupérer ses champs dans cette forme. Interact est le plus récent et le moins évident : la session ne s'arrête pas une fois la page récupérée, donc le langage naturel ou le code peuvent continuer à cliquer, remplir des formulaires, extraire du contenu dynamique et aller plus loin. L'exemple officiel récupère la page d'accueil d'une boutique, y cherche un produit, ouvre le résultat et lit le prix. L'intérêt de relier les trois est que, dans beaucoup de collectes, la vraie difficulté se trouve à la troisième étape — une copie statique du HTML ne suffit souvent pas.
Au-delà d'une page : sites entiers, lots, fichiers locaux
Autour des points d'entrée principaux gravite un anneau de capacités. Map découvre toutes les adresses d'un site, Crawl le parcourt de façon récursive, et le traitement par lots couvre des centaines de milliers d'adresses en asynchrone. L'extraction ne se limite pas aux pages en ligne : les fichiers PDF, DOCX, XLSX et HTML locaux se convertissent aussi en markdown ou en JSON structuré. S'y ajoutent un mode autonome où l'on décrit ce que l'on veut et l'agent collecte seul, des webhooks qui livrent les résultats en asynchrone, et un bac à sable de navigateur qui fournit des sessions hébergées pour les flux d'interaction. Les actions avant extraction ont leurs crochets : clic, défilement, saisie, attente et frappes se scriptent dans le flux.
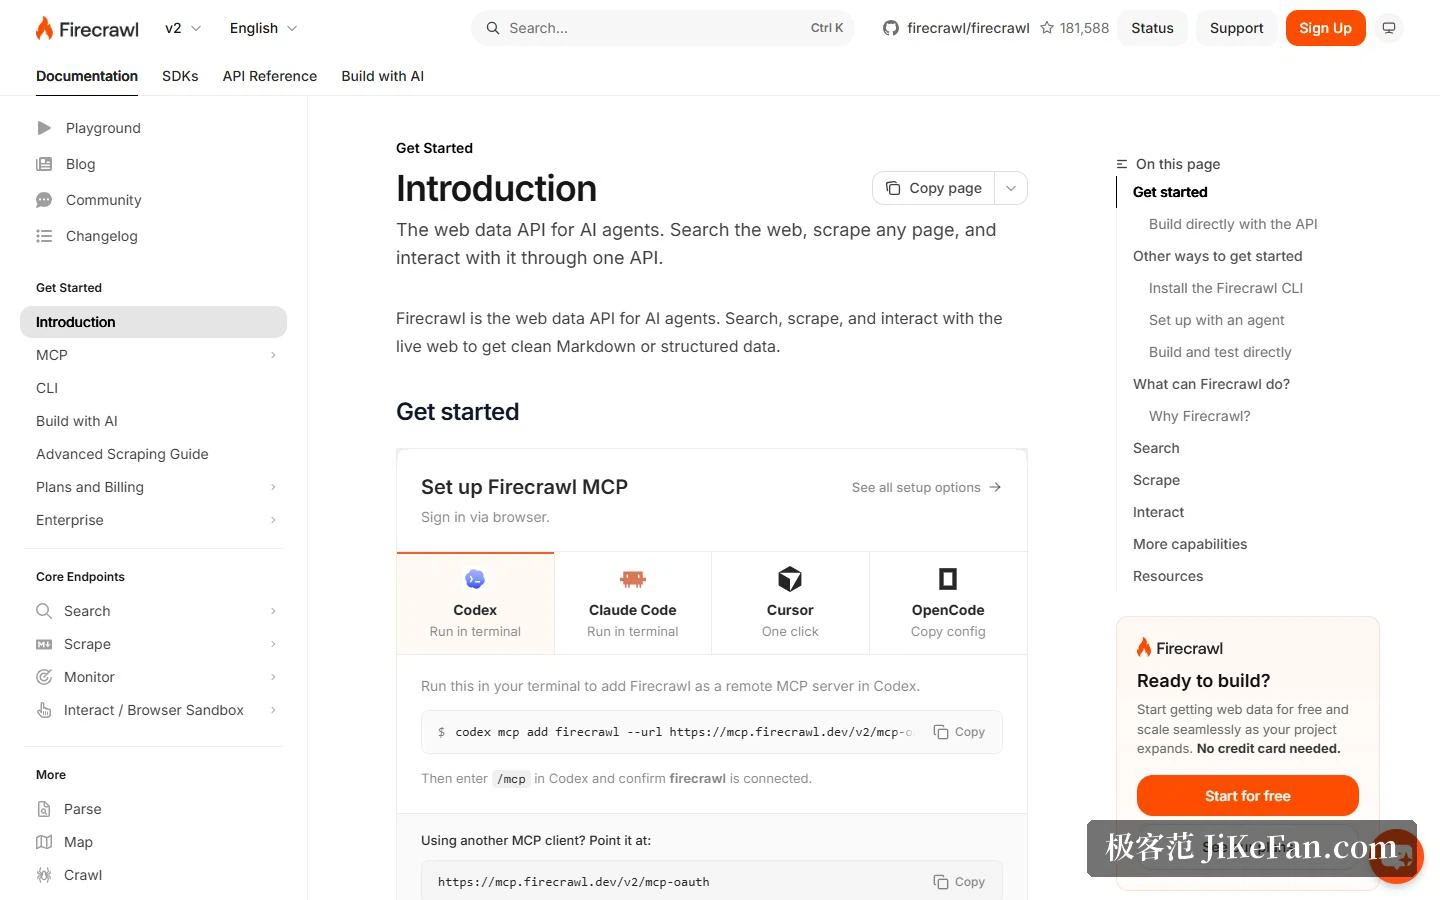
Les moyens de connexion sont complets. Il tourne comme serveur du protocole de contexte de modèle, donc une commande l'attache à un agent de codage. Un outil en ligne de commande s'installe et injecte une compétence dans l'agent de codage détecté. Les SDK couvrent Python, Node et la ligne de commande, et la liste d'intégrations cite les deux frameworks de recherche les plus courants ainsi que plusieurs fournisseurs de modèles. La documentation recommande même de commencer sans clé : les premières requêtes n'en ont pas besoin, en ajouter une ne fait qu'assouplir la limite de débit.
Quota gratuit et comptage de la facturation
Les règles de quota sont étonnamment lisibles. Chaque mois apporte 1 000 crédits, soit environ mille pages, sans carte bancaire. Au-dessus, quatre paliers, un palier entreprise négocié à part, et un abonnement annuel qui offre deux mois. L'unité change avec la capacité : extraction, parcours de site, découverte d'adresses et surveillance coûtent un crédit par page ; la recherche coûte deux crédits par dix résultats ; l'interaction de page deux crédits par minute de navigateur. Le report diffère aussi — les crédits inutilisés des deux paliers hauts passent au mois suivant, pas ceux des paliers bas. La FAQ officielle ajoute deux limites : une extraction sans résultat n'est pas facturée, et les pages qui répondent avec un statut d'erreur sont tout de même livrées. Un rechargement de cinq dollars équivaut selon le palier à 1 000, 2 000, 2 500 ou 5 000 crédits : la même somme achète davantage plus haut.
La forme de la licence mérite attention. Le projet est surtout sous AGPL-3.0 : exploiter une version modifiée comme service public oblige donc à publier ses changements ; les SDK et certains composants d'interface sont en MIT, ce qui rend l'appel à l'interface hébergée bien moins contraint. La version hébergée apporte aussi des capacités absentes de l'auto-hébergement, et les listes de fonctions du dépôt et de la documentation permettent la comparaison. Côté conformité, l'éditeur déclare respecter robots.txt par défaut et laisse à l'utilisateur la responsabilité des règles de chaque site — une phrase à lire mot à mot avant toute collecte commerciale.
À qui cela convient
Trois situations s'y logent proprement. Les équipes qui construisent la couche de recherche et d'outils des agents, parce qu'elles ont besoin d'un format contrôlable de façon fiable sans maintenir une infrastructure d'extraction et d'anti-robots. Les équipes qui font des pipelines de données et de l'enrichissement de prospects, où extraction par lots et modèle structuré projettent une page désordonnée directement sur des champs de base. Et les individus ou petites équipes en phase de validation, le quota gratuit suffisant à dérouler un flux de bout en bout, le serveur de protocole comme l'outil en ligne de commande s'attachant en quelques minutes.
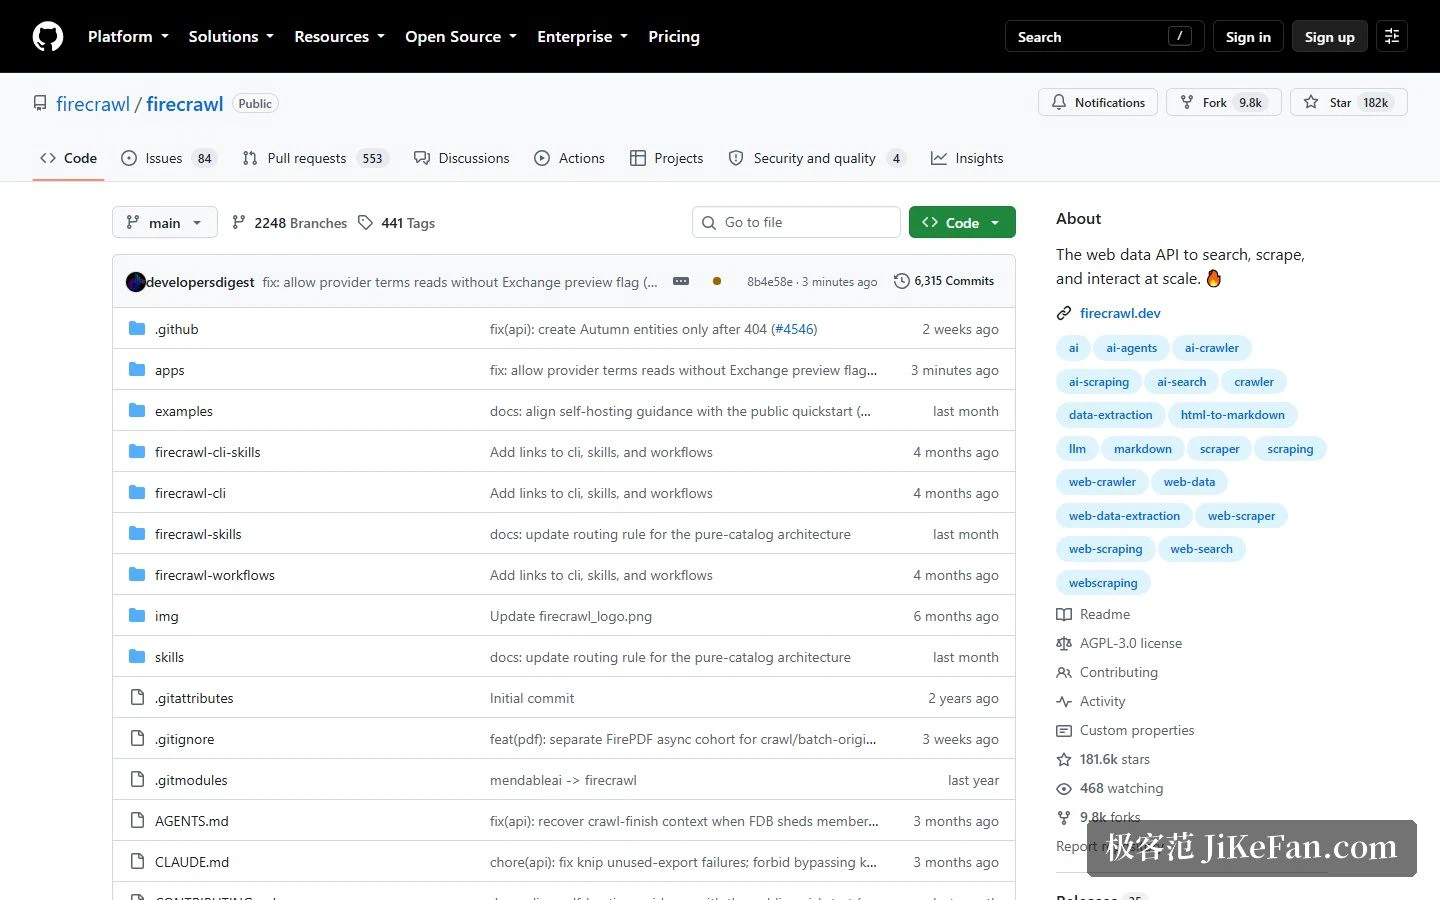
Deux arbitrages méritent d'être nommés. La licence d'abord : AGPL-3.0 encadre la vente d'une version modifiée comme service, ce qui ne touche pas l'appel à l'interface hébergée mais impose de réfléchir à ses obligations avant d'exposer publiquement une version maison. Ensuite l'auto-hébergement face au cloud : l'auto-hébergement garde les données et les coûts en main, au prix de porter soi-même la robustesse anti-robots et la couverture des pages ; le cloud héberge tout cela, au prix d'une facturation à l'usage et du transfert des requêtes à un tiers. Les chiffres du dépôt donnent environ 181,6k étoiles, 9,8k forks, 35 publications, 173 contributeurs et une version v2.11.0, majoritairement en TypeScript avec Python et Rust à côté, 96 pour cent des pages couvertes et une latence P95 de 3,4 secondes — des chiffres fournis par l'éditeur, que vos propres sites cibles méritent encore de tester.
La valeur d'un outil d'extraction n'est pas de savoir s'il peut récupérer. C'est de savoir si ce qu'il récupère entre directement dans votre aval. Nettoyer cette couche-là, et la main-d'œuvre disparaît vraiment.