
Umi-OCR 2.1.5 erkennt Text ohne Netz
Zusammenfassung
Umi-OCR 2.1.5 erkennt Text in Bildschirmfotos, ganzen Ordnern und gescannten PDFs ohne Netz, mit markierbarem Text und Sperrbereichen.
Empfehlen- Name
- Umi-OCR
- Version
- 2.1.5
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinux
- Aktualisiert
- 2026-11-14 23:00
Ein eingescanntes Blatt, ein Bildschirmfoto, ein Bild aus einer Nachricht: die Zeichen sind da, und der einzige Weg in ein Dokument besteht darin, sie einzeln abzutippen. Wer das einmal gemacht hat, erinnert sich. Online zu erkennen spart die Muehe, kostet aber die Weitergabe der Datei an einen fremden Server, was auf einem abgeschotteten Rechner, bei vertraulichem Material oder einfach aus Unlust am Umweg ausfaellt. Umi-OCR waehlt eine andere Position: die Engine liegt auf dem eigenen Rechner und laeuft ohne Verbindung. Das Projekt ist quelloffen, in Python und Qt geschrieben, unter MIT gestellt, das Paket entpackt und laeuft ohne zusaetzliche Laufzeitumgebung, es gibt Fassungen fuer Windows und Linux, und die Oberflaeche spricht mehr als ein Dutzend Sprachen.
Die Projektseite beschreibt sich zurueckhaltend: ein kostenloses, quelloffenes Offline-OCR-Werkzeug fuer Stapel. Drei Eigenschaften, keine Adjektive.
Nach dem Bildschirmfoto laesst sich der Text markieren
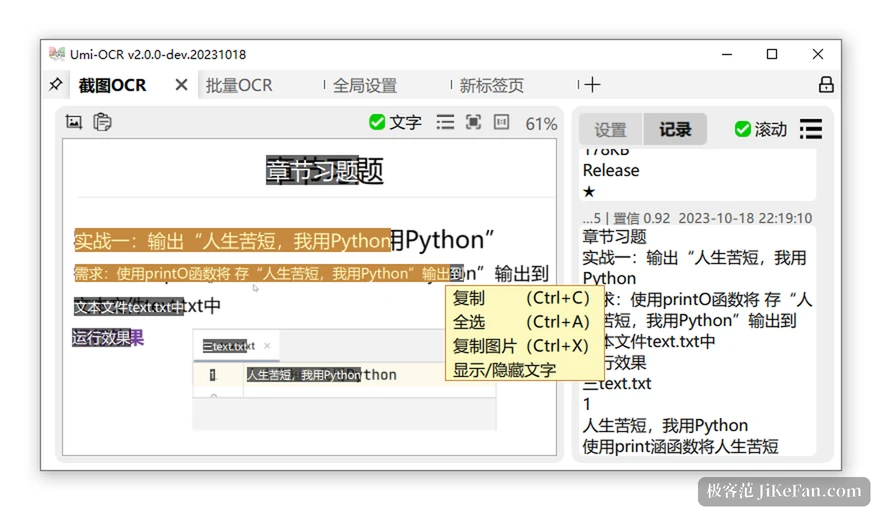
Das Hauptfenster ist in Reiter gegliedert: Erkennung aus Bildschirmfotos, Stapelerkennung und allgemeine Einstellungen, weitere Reiter sind moeglich. Auf der Bildschirmfotoseite steht das aufgenommene Bild links, rechts daneben Einstellungen und Verlauf. Ist die Erkennung fertig, laesst sich Text im Bild mit der Maus ueberstreichen, waehrend der Verlauf jedes Ergebnis mit dem neuesten zuerst auflistet und jede Zeile einen Wert fuer die Sicherheit traegt. Eine Zahl wie 0.92 sieht nicht huebsch aus, sagt aber ehrlich, wie sicher diese Zeile ist, und zeigt genau die Stellen, die ein Mensch nachlesen sollte.
Seit 2.1.5 wechseln die meisten Reiter zwischen nebeneinander und uebereinander, sodass ein schmaler Bildschirm den Verlauf nach unten schiebt und dem Bild mehr Platz laesst. Die Escape-Taste versteckt das Hauptfenster, ein Kurzbefehl fuer alle, die den ganzen Tag Aufnahmen machen.
Satzumbruch bringt wirre Bloecke zurueck in Sprache
Die Erbsuende der Erkennung ist nicht der falsche Buchstabe, sondern zwei Spalten, die in Lesereihenfolge zu einem Brei geruehrt werden. Umi-OCR bringt eine Analyse des Satzumbruchs in der Nachbearbeitung mit, mit Varianten fuer mehrere Spalten, eine Spalte und eine Zeile, die das Ergebnis so umstellen, dass die Ausgabe der Leserichtung folgt. Die Variante fuer eine Zeile behandelt noch einen haeufigen Fall: zwischen zwei weit auseinanderliegenden Bloecken wird ein Leerzeichen gesetzt, damit Saetze nicht zusammenkleben.
Solche Feinheiten stehen auf keiner Funktionsliste. Sie fallen auf, sobald ein langer Abschnitt herausgezogen wird und keine Handarbeit an der Zeichensetzung mehr noetig ist.
Die Stapelseite ist eine kleine Fertigungslinie
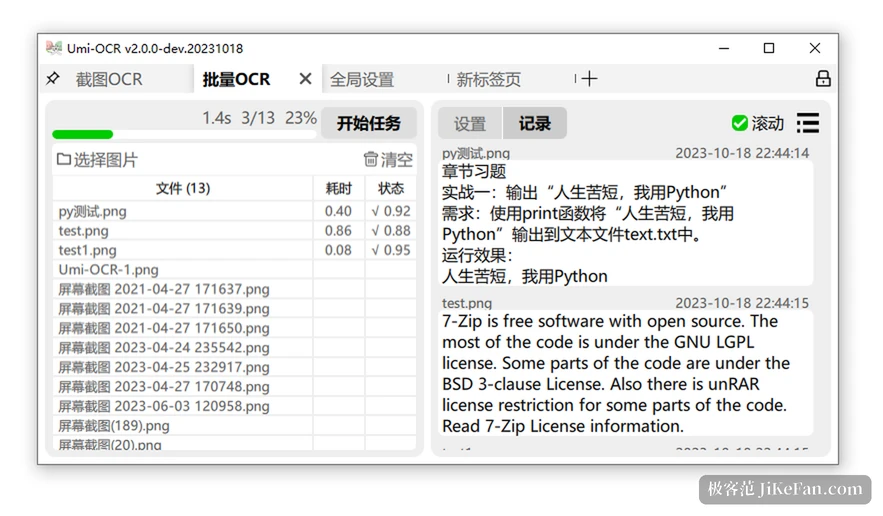
Links steht eine Dateiliste mit Name, Dauer und Zustand, und hinter dem Haken in der Zustandsspalte folgt derselbe Sicherheitswert. Ein Fortschrittsbalken oben nennt erledigte Bilder und einen Prozentsatz. Der Verlauf gruppiert nach Datei: ein Bild anklicken, sein Ergebnis lesen, weiter unten sehen, was der Rest des Stapels ergeben hat.
Zeit spart weniger die Gleichzeitigkeit als das Mitlesen waehrend des Laufs, denn eine fertige Datei erscheint in der Liste, ohne auf den ganzen Stapel zu warten. Fassung 2.1.5 laedt Bilder und Dokumente asynchron, sodass ein Ordner mit Zehntausenden Unterdateien fluessig aufklappt und der Balken mitlaeuft. Dieselbe Seite kennt Sperrbereiche: ein Rechteck ziehen, und der Text darin bleibt von der Erkennung ausgenommen, womit Eckvermerke, Wasserzeichen und Zeitstempel in einem Zug verschwinden.
Auch eingescannte PDFs lassen sich lesen
Die Dokumenterkennung behandelt PDFs in zwei Formen. Ein Scan hat gar keine Textebene und braucht die Erkennung, um eine zu bekommen; eine digital erzeugte Datei bringt bereits eine Ebene mit, die sich einfach ausziehen laesst, was die Arbeit spart. Die Ausgabe geht zwei Wege: reiner Text, oder ein durchsuchbares PDF mit zwei Ebenen, bei dem die Seite unveraendert wirkt und darunter eine unsichtbare Schicht aus Zeichen liegt, sodass Suchen und Kopieren in jedem Betrachter normal funktionieren.
Fassung 2.1.5 reparierte zwei Fehler in diesem Bereich: vorhandener Text ging beim Drehen einer Seite verloren, und beim Erzeugen eines einlagigen PDFs wurde der urspruengliche Text nicht geschrieben. Fuer Vertraege und Handbuecher, die ins Archiv wandern, wiegen diese beiden mehr als jede Neuerung.
Aufrufbar aus anderen Programmen ist der eigentliche Nutzen
Neben dem Fenster gibt es zwei Zugaenge. Die Kommandozeile nimmt Anweisungen beim Start und waehrend des Laufs Aufgaben aus der Ferne; eine HTTP-Schnittstelle macht das Programm zu einem lokalen Dienst, an den Bildschirmfotos, Bilder und PDFs als Anfrage gehen und dessen Antwort Koordinaten und Sicherheit jeder Zeile enthaelt. Unter Linux laeuft das Ganze auch als Behaelter in einer bestehenden Kette.
Die Protokollierung aus 2.1.5 existiert fuer diesen Weg: mit den richtigen Argumenten gestartet zeigt sie ein laufendes Protokoll, ab einem gesetzten Grad landen Eintraege im Protokollordner, und eine gescheiterte Erkennung muss nicht mehr erraten werden. Dieselbe Fassung brachte eine Anweisung zum Neuladen der Konfiguration, was einen Neustart nach geaenderten Werten spart.
Zwei Grenzen, die man vorher kennen sollte
Die Engine kommt als Erweiterung, und die Fassungen sind nach Engine in zwei Pakete geteilt. Die schnelle verlangt bestimmte Befehlssaetze des Prozessors, weshalb Pentium, Celeron und Atom nicht starten; scheitert die Einrichtung, hilft die vertraegliche Fassung. Das ist eine Grenze des Inferenzrahmens und kein Defekt, und die Dokumentation sagt es deutlich.
Die andere Grenze: erkannt wird Text, kein Layout wiederhergestellt. Eine Tabelle kommt als Wortstrom heraus, und wer die Struktur behalten will, ordnet von Hand nach. Die Oberflaeche deckt mehr als ein Dutzend Sprachen ab, ueber eine Uebersetzungsplattform der Gemeinschaft gepflegt, Chinesisch und Englisch eingeschlossen.
Wofuer es gedacht ist
Setzt man Umi-OCR 2.1.5 in einen Arbeitstag zurueck, ist die geloeste Aufgabe eng: Zeichen aus Bildern und Scans in Text verwandeln, der sich kopieren, durchsuchen und an ein anderes Programm weitergeben laesst, und das ohne das Geraet zu verlassen. Markieren im Bildschirmfoto, Stapel in der Warteschlange, Sperrbereiche, zweilagige PDFs, Kommandozeile und Schnittstelle decken zusammen die Strecke vom gelegentlichen Gebrauch bis zum Schritt in einer Automatisierung ab. Kostenlos, quelloffen, kein Konto, keine Verbindung: fuer alle mit empfindlichem Material sind diese drei Punkte schon der Grund zur Wahl.