
Scrapling 0.5.1: ganze Seite als Markdown, plus Browser
Zusammenfassung
Scrapling 0.5.1 ist ein offenes Python-Framework zum Auslesen: Seiten und ganze Sites werden zu reinem Markdown, Selektoren ueberstehen einen Umbau.
Empfehlen- Name
- Scrapling
- Version
- 0.5.1
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsmacOSLinux
- Webseite
- https://github.com/D4Vinci/Scrapling
- Aktualisiert
- 2026-11-10 23:00
Scrapling ist ein in Python geschriebenes Framework zum Auslesen von Webseiten, das Anfragen, Browser, Auswertung, das Abgrasen ganzer Sites und den Export in einer Bibliothek zusammenhaelt. Fassung 0.5.1, am 4.11.2026 erschienen, tut zwei Dinge: sie oeffnet die Browsersitzung fuer fremde Programme, damit ein Agent Bewegung und Ziehen versteht, und sie ebnet den Weg von einer ganzen Site zu reinem Markdown. Wer sich einen Textbestand aufbaut oder eine KI oeffentliche Seiten selbst lesen lassen will, ist in zehn Minuten im Bild. Es laeuft unter Windows, macOS und Linux.
Erst die Seite zu Markdown waschen, dann dem Modell geben
Ein grosses Modell verliert an rohem HTML. Navigation, Skripte, Stile und Werbeflaechen stehen in derselben Datei, und der brauchbare Text klemmt in der Mitte, waehrend jedes Zeichen Rauschen gleich berechnet wird. Scrapling zieht die Subtraktion in die Umwandlung vor: nach markdown() sind Skripte, Stile und verborgene Elemente leer, und mit ihnen verschwinden per CSS versteckte weisse Schrift, als aria-hidden markierte Bloecke, HTML-Kommentare und Zeichen ohne Breite.
In diesem Weg sitzt kein Modell. Es ist Zeichenverarbeitung auf dem eigenen Rechner, zehntausend Seiten kosten also keine Modelgebuehr. Gespart wird nicht nur Geld. Ein sauberer Bestand haelt das Zerlegen stromabwaerts stabil, und ein gefundener Abschnitt kommt nicht mit einem halben Menue daher.
Fuer ganze Sites gibt es eine Vorlage. Erlaubte Domaenen setzen, den Selektor fuer den Text nennen, eine Seitengrenze angeben, und der Lauf hinterlaesst einen Ordner mit .md-Dateien sowie eine JSONL, in der jeder Eintrag Quelle, Titel und Text traegt und direkt in eine Wissensbasis passt. Dokumentationsseiten, Blogs und Handbuecher haben die regelmaessige Struktur, die diesen Weg am wenigsten schmerzhaft macht.
Elemente tragen einen Fingerabdruck, ein Umbau spart den Selektor
Der bruchanfaellige Teil eines Scrapers ist der Selektor. Ein Seitenumbau benennt die CSS-Klassen um, der Code von gestern liefert eine leere Liste, und das Protokoll muss Schicht fuer Schicht gelesen werden, bis die Ursache auftaucht. Die adaptive Elementverfolgung geht anders vor: der erste Zugriff haelt Position, Attribute und Textmerkmale als Fingerabdruck fest, und nach dem Umbau sucht sie ueber die Aehnlichkeit den Knoten, der gewandert ist und doch derselbe geblieben ist.
Der Abgleich aehnlicher Elemente deckt den zweiten haeufigen Fall. Eine Seite traegt Dutzende gleich gebaute Karten und eine davon wird gebraucht. Erst ein Bezugselement finden, dann ueber strukturelle Aehnlichkeit ausweiten, was besser haelt als ein handgeschriebenes nth-child.
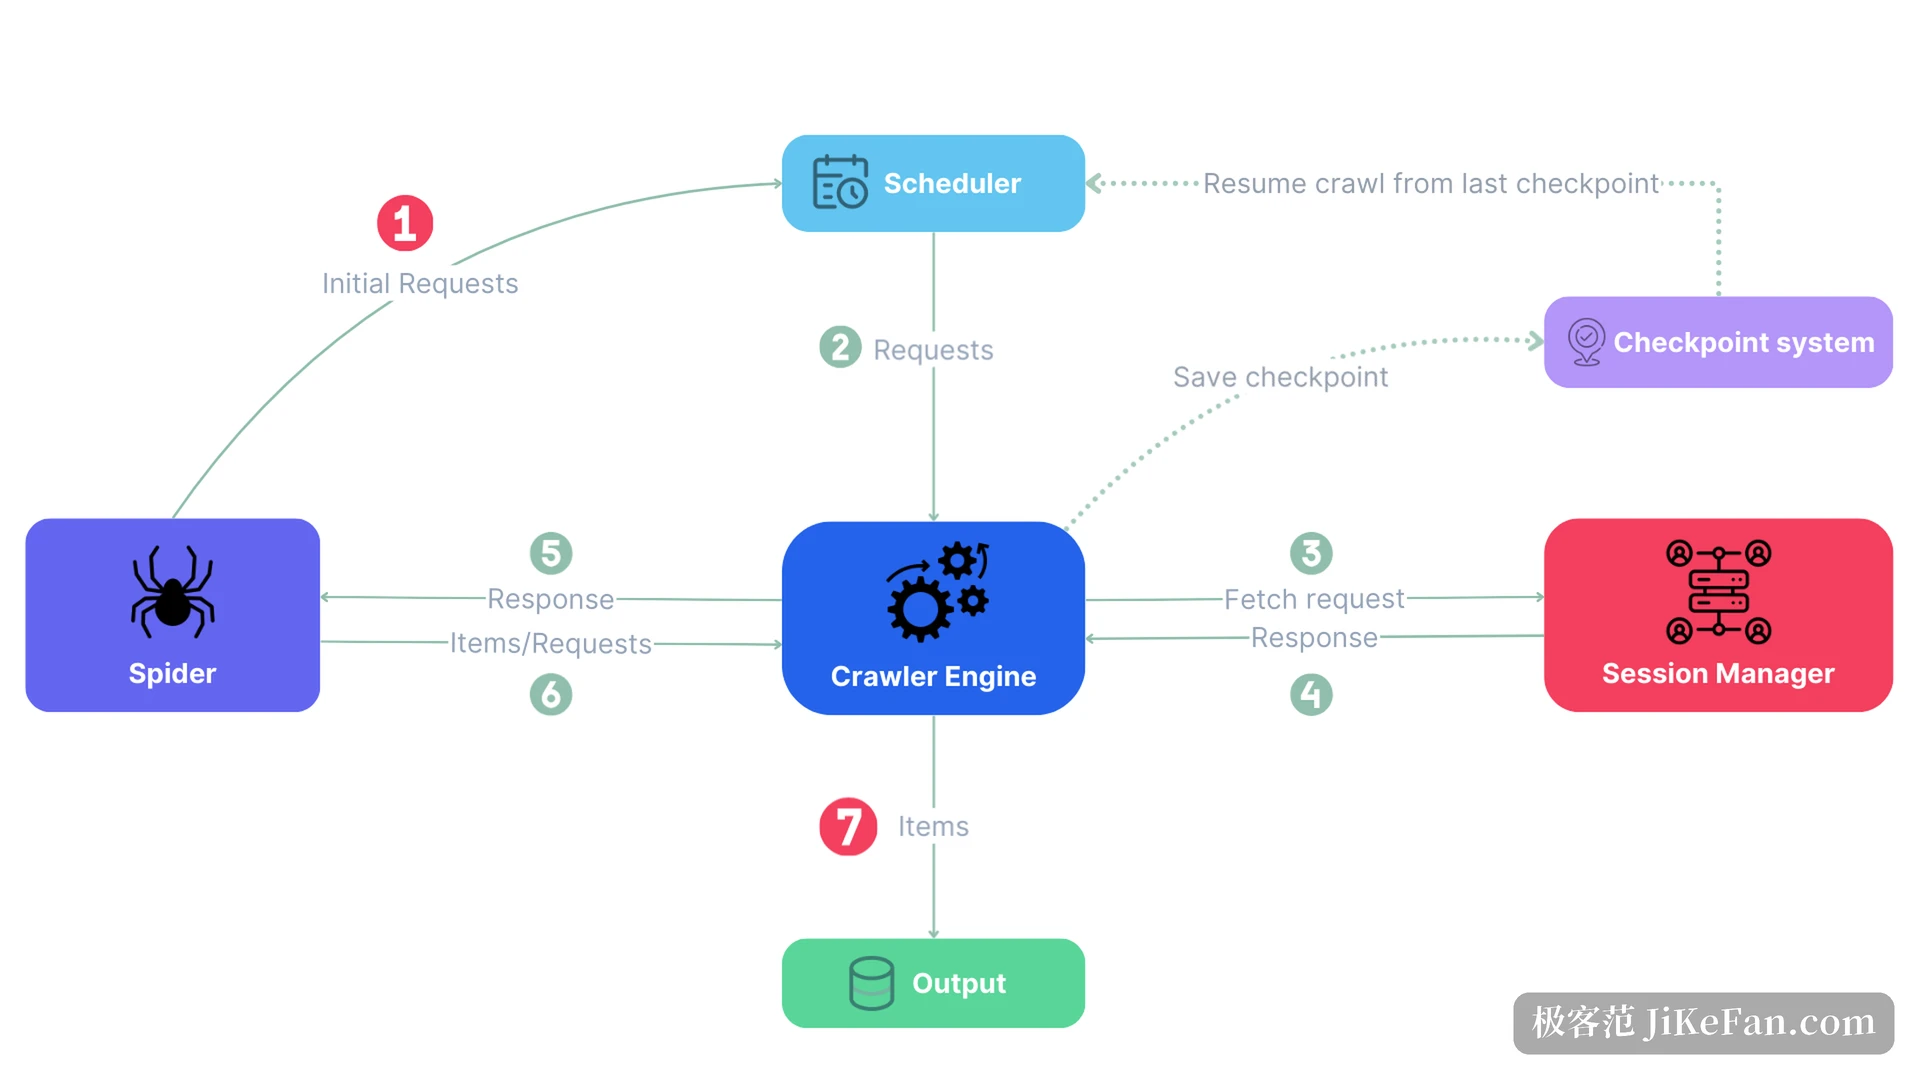
Eine Anfrage und eine ganze Site teilen dieselbe Schreibweise
- Fetcher
- Gewoehnliche HTTP-Anfragen mit dem TLS-Fingerabdruck und den Kopfdaten eines echten Browsers, genug fuer statische Seiten und offene Schnittstellen.
- Browser-Scraper
- Steuert Chromium ueber Playwright, wartet auf das Ende von JavaScript und kann sich an einen bereits offenen Browser haengen.
- Spider
- Paralleles Sammeln mit automatischer Bremse, Fortschritt auf Ctrl+C gesichert und spaeter fortgesetzt, Export nach JSON, JSONL, CSV oder XML.
Alle drei Arten teilen eine Auswertungsschnittstelle. Derselbe Selektorcode zieht von einer statischen auf eine dynamische Seite um, indem der Fetcher getauscht wird, ohne zweiten Dialekt fuer JavaScript. Auch die XHR-Anfragen hinter einer Seite lassen sich aufzeichnen, und was eine Schnittstelle zurueckgibt, ist meist ordentlicher als das HTML, das es darstellt.
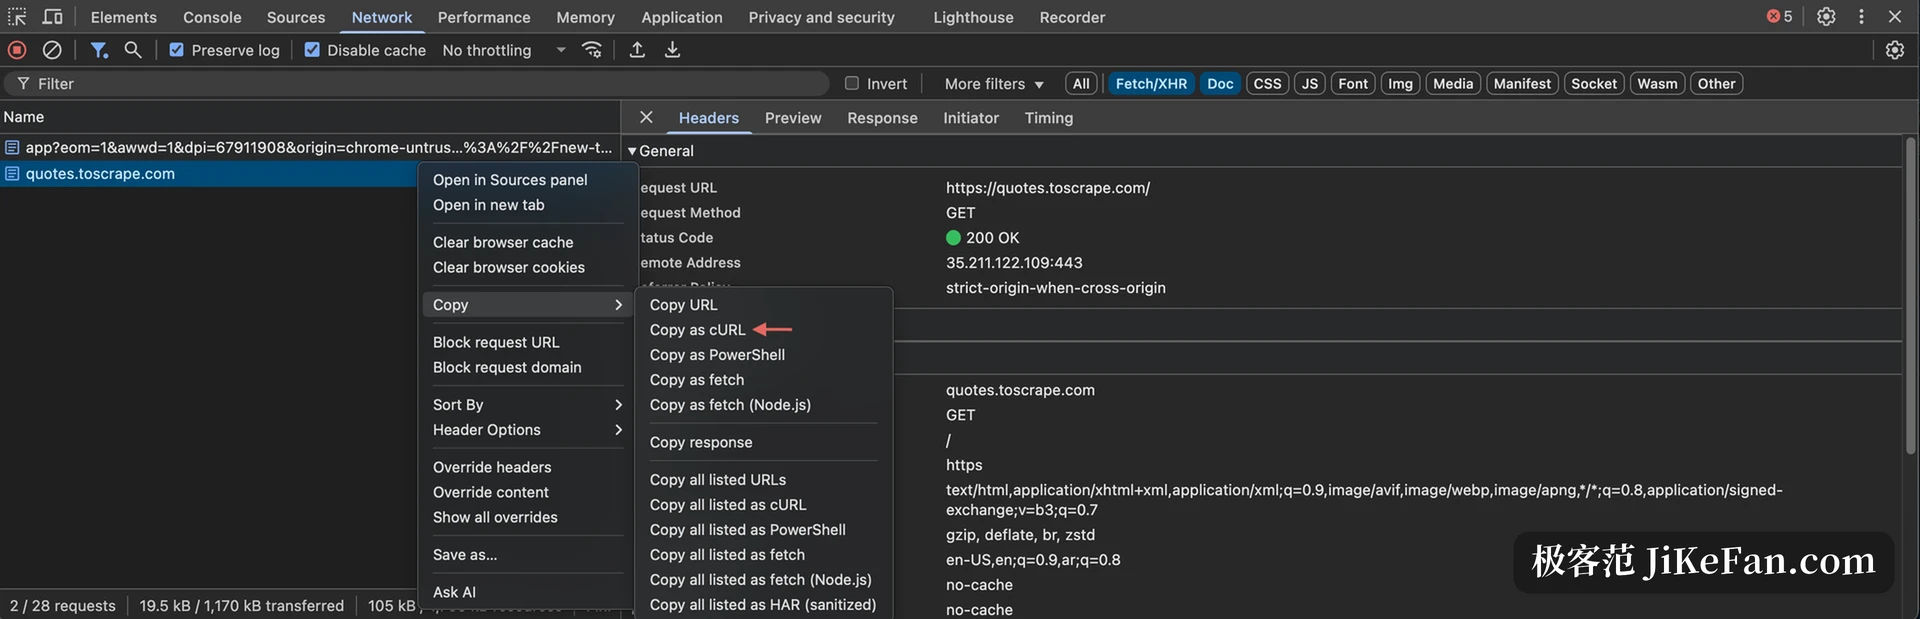
Ein kleines Detail verdient seinen Platz. Wer eine Schnittstelle im Browser untersucht, bekommt ueber cURL kopieren eine vollstaendige Anfrage. In die interaktive Shell von Scrapling eingefuegt, wird daraus eine wiederverwendbare Anweisung, die einmal laeuft und dann in ein Skript wandert. Der erste Durchgang, Kopfdaten von Hand zusammenzusetzen, faellt weg.
Drei Oeffnungen in 0.5.1
| Fassung | Datum | Wesentliche Aenderung |
|---|---|---|
| 0.5 | 2026-10-17 | Der MCP-Server bekam den vollen Browserablauf, Aufzeichnung von Netzanfragen und Speicherung des Anmeldezustands, offenes Shadow DOM und die Wahl zwischen Breiten- und Tiefensuche. |
| 0.5.1 | 2026-11-04 | Eine Klasse fuer entfernte Sitzungen uebernimmt ein bereits laufendes Chromium; Agenten sehen Bewegung und ziehen mit gehaltener Maus. |
Die entfernte Sitzung zaehlt, weil sie Browser und Sammelprozess trennt. Sie verbindet sich ueber einen CDP-Endpunkt mit einem laufenden Chromium, nutzt den vorhandenen Kontext weiter, erbt die Anmeldung und laesst offene Tabs stehen, wenn die Sitzung endet. Frueher hiess das, den Anmeldezustand waehrend eines Laufs immer wieder in Dateien zu schreiben und zu lesen.
Bewegung und Ziehen sind fuer Agenten gedacht. Ein einzelnes Bild haelt einen Augenblick fest, und Animation, Position nach dem Scrollen oder ein Regler haben im Standbild kein Vorher und Nachher. Fassung 0.5.1 laesst den Agenten eine Folge von Bildern lesen und verstehen, was die Seite tut, dann die Maus halten, bewegen, zum Pruefen innehalten und loslassen. Die Werkzeugbeschreibungen wurden zugleich gekuerzt, dieselbe Faehigkeit kostet also weniger Kontextbudget.
Mehr als eine Tuer fuer einen Agenten
Der MCP-Server erledigt die Arbeit: Seiten oeffnen, klicken, Formulare fuellen, scrollen, Bildschirmfotos, Antworten lesen sind Werkzeuge geworden, ein Client kann also gebeten werden, die Parameter einer Seite in eine Tabelle zu bringen, und wird fertig. Die Agent-Faehigkeit tut etwas anderes. Sie ist ein Handbuch, das mit den Fassungen mitwaechst und das ein Programmierassistent beim Schreiben von Scrapling-Code nachschlaegt, statt eine Schnittstelle aus altem Gedaechtnis nachzubauen. Kommandozeile und interaktive Shell sind der dritte Weg, gut dafuer, eine Anfrage zum Laufen zu bringen, bevor sie in ein Skript wandert.
Drei Wege, drei Arten von Menschen. Datenstrecken nutzen meist die Python-Schnittstelle, Bastler im Terminal moegen die Shell, und wer das Sammeln einem Agenten uebergibt, beruehrt MCP.
Die Grenze bleibt die Grenze
Je staerker das Werkzeug, desto frueher die Frage, was genommen werden darf. Oeffentliche Dokumentation, oeffentliche Preise und veroeffentlichte Papiere sind normale Nutzung. Eine Seite, die automatisierten Zugriff klar verbietet oder ihren Inhalt hinter einer Anmeldung haelt, ist es nicht. Dem Spider laesst sich sagen, dass er robots.txt achtet, und er laesst sich auf Domaenen begrenzen, damit ein Lauf im Ziel bleibt. Auch die Frequenz verdient Zurueckhaltung: ein- bis zweimal am Tag zeigt die Aenderung, und ein fremder Server ist keine Lastpruefung.
Scrapling 0.5.1 ist nicht deshalb etwas wert, weil es auslesen kann, sondern weil das Ausgelesene brauchbar ist: eine Seite geht hinein, reines Markdown kommt heraus, ein gewandertes Element wird wiedererkannt, und ein Agent kann die Bedienung uebernehmen. Das Ganze ist offen und laeuft lokal, zum Preis eines Werkzeugs, das Code erwartet; wer Plug-and-play hofft, wird enttaeuscht. Gewinnen die, die schon eine Wissensbasis bauen oder einem Agenten einen Datenweg legen.