
Auto-Ontology: eine Semantikschicht mit Pruefschritt
Zusammenfassung
Auto-Ontology ist eine offene Semantikschicht von NVIDIA, die aus der Datenbank ein Fachwoerterbuch wachsen laesst und Antworten mit SQL belegt.
Empfehlen- Name
- Auto-Ontology
- Version
- 0.1
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- LinuxWeb
- Aktualisiert
- 2026-11-10 23:00
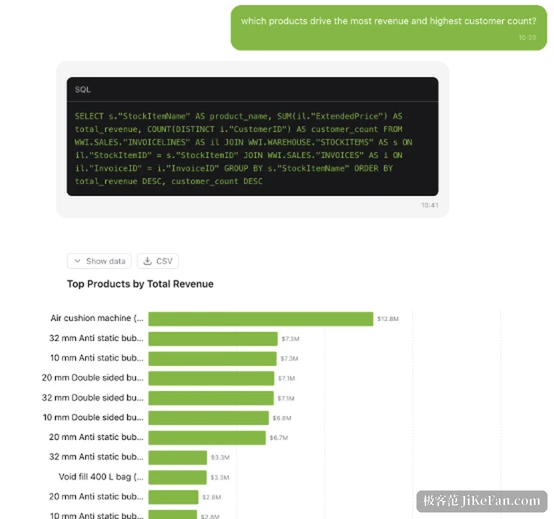
Auto-Ontology ist eine offene Semantikschicht von NVIDIA. Sie laesst aus einer vorhandenen Datenbank ein Fachwoerterbuch wachsen und bringt einen Agenten dazu, Fragen gegen dieses Woerterbuch zu beantworten. Das Problem ist der uebliche Fehlschlag in der Self-Service-Analyse: das Modell liest Umsatz aus der falschen Spalte, das SQL laeuft, und die Zahl ist falsch. Wer natuerliche Sprache auf Geschaeftsdaten legen will und der Ausgabe des Modells nicht traut, kann sich ansehen, wie dieses Projekt den Schritt pruefbar macht. Der Code steht unter Apache 2.0, die Oberflaeche ist eine Weboberflaeche, das Backend laeuft in Containern, und ein Modellendpunkt genuegt zum Start.
Was fehlt, ist kein Uebersetzer, sondern ein Woerterbuch
Natuerliche Sprache in SQL zu uebersetzen ist seit Jahren technisch moeglich. Schwer ist die Bedeutung. Kundenzahl heisst in der Bestelltabelle die Konten, die bestellt haben, in der Kundentabelle die Firmen, die angelegt wurden. Umsatz kann Steuer enthalten oder nicht, fakturiert oder noch offen sein. Das Modell weiss nicht, welche Definition in Ihrem Haus gilt, also nimmt es eine Spalte, die plausibel aussieht.
Auto-Ontology fuellt zuerst diesen Kontext: wo die Daten liegen, wie sie heissen, ob sie benutzt werden duerfen, wie sie zu benutzen sind, woher sie kommen und was ihnen aehnelt. Dieses Wissen liegt sonst in Datenlexika, SQL-Skripten und in den Koepfen erfahrener Kollegen. Das Projekt sammelt es in einer Struktur, die sich abfragen laesst, und gibt diese Struktur an den Agenten weiter.
Drei Arten von Eintraegen
Begriffe sind die fachlichen Konzepte, Kunde oder Rechnungsposition, jeweils mit Beschreibung und Synonymen und auf konkrete Spalten abgebildet. SQL-Attribute haengen unter einem Begriff als geprueften Ausdruck, die Bruttomarge zum Beispiel, damit der Agent eine Rechnung wiederverwendet statt eine zweite zu erfinden. Beziehungen halten fest, wie Tabellen verknuepft sind, Brueckentabellen eingeschlossen, abgeleitet aus Schluesseln und aus der Form der Daten.
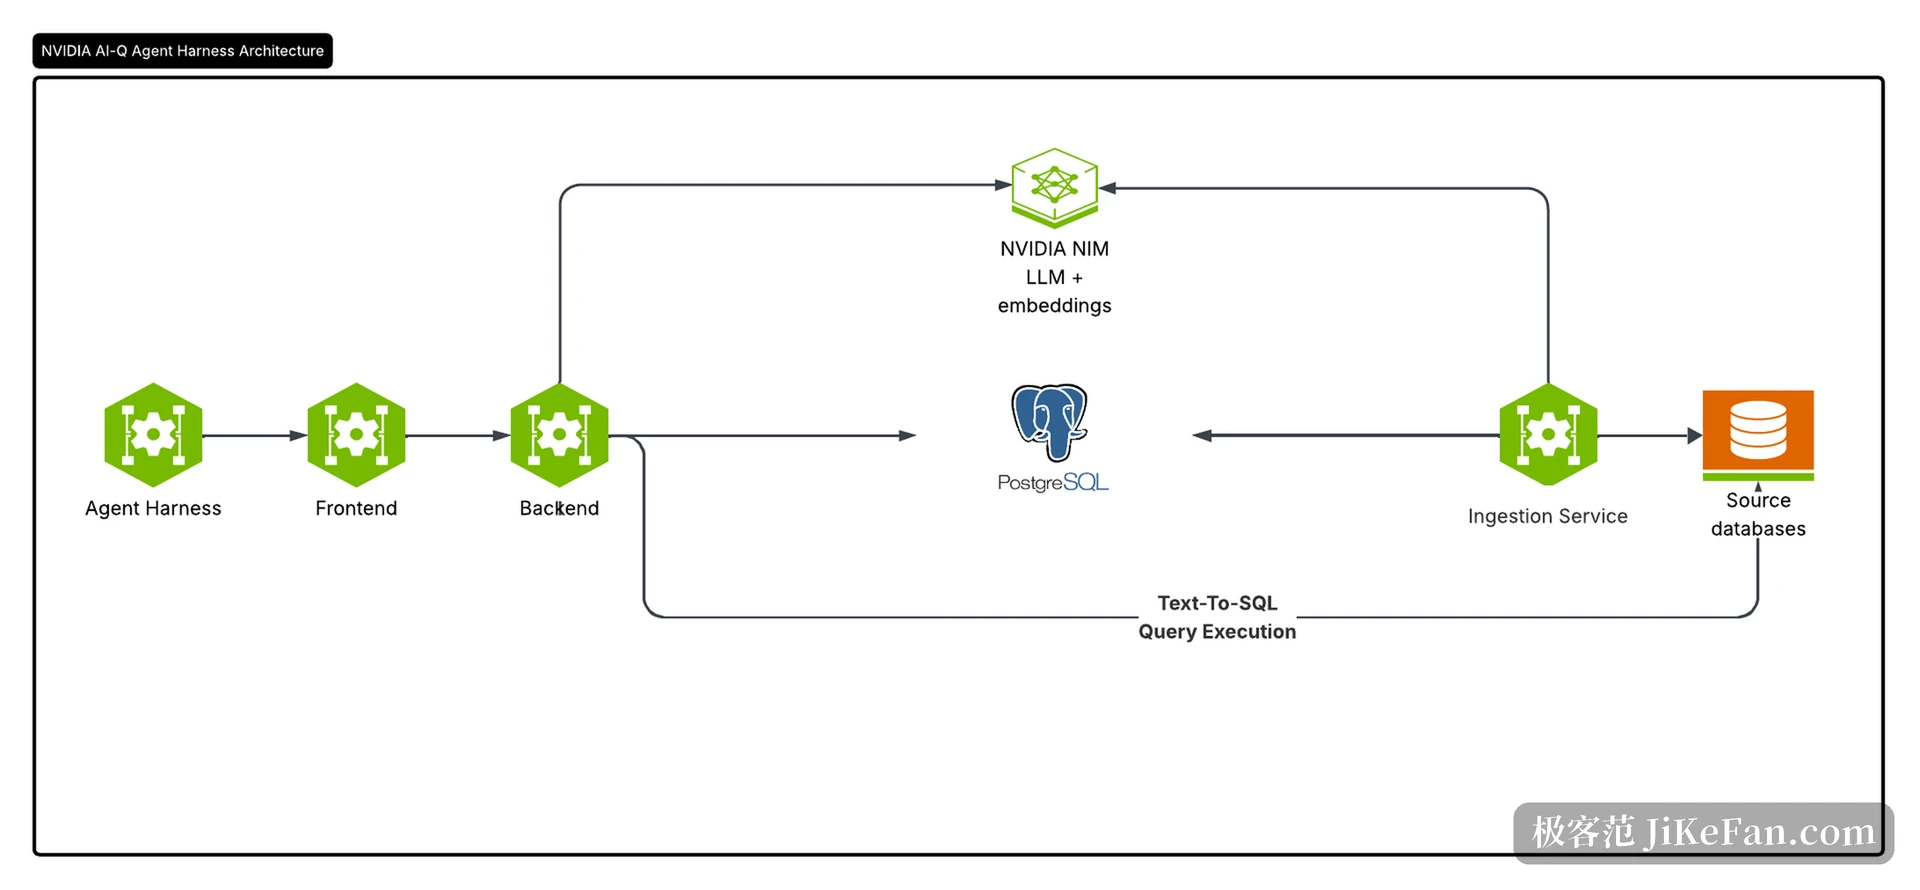
Die Erzeugung laeuft in vier Schritten. Der Aufnahmedienst liest die Quelldatenbank, zieht das Schema, erstellt Profile der Spalten und Stichproben der Werte. Dann holt er Begriff fuer Begriff Tabelle fuer Tabelle und bildet sie auf Spalten ab, leitet die Verbindungen zwischen Tabellen ab und schlaegt SQL-Attribute aus historischen Abfragen vor. Zuletzt schreibt er Begriffe, Beziehungen und Attribute nach Postgres und legt die Vektoren in pgvector fuer die Suche ab.
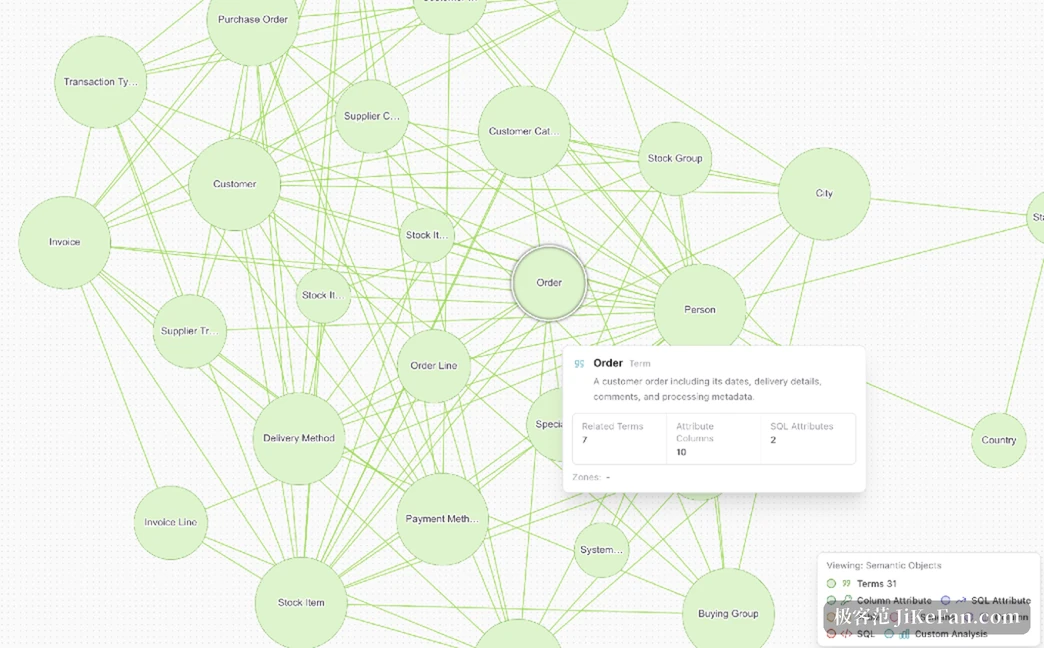
Danach sehen Sie einen semantischen Graphen, den Sie anklicken koennen. Das offizielle Beispiel laeuft gegen die Verkaufsdatenbank Wide World Importers von Microsoft: ein Durchlauf erzeugt 31 Begriffe, und wer Auftrag auswaehlt, sieht Beschreibung, verwandte Begriffe, abgebildete Spalten und 2 SQL-Attribute. Die Zahlen sind klein und zeigen die Form der Struktur.
Die Maschine entwirft, ein Mensch unterschreibt
Erzeugtes Material laesst sich so nicht verwenden. Die Zertifizierung ist ein eigener Schritt. Sie probieren echte Fragen im Dialog aus oder rufen die Pruefwerkzeuge ueber MCP auf, und wo eine Beschreibung falsch ist oder ein Attribut falsch rechnet, korrigieren Sie es in der Oberflaeche und zertifizieren Begriff fuer Begriff. Nur zertifizierte Namen, Beschreibungen und Formeln gelten in spaeteren Antworten als verlaessliche Definition.
Das klingt langsam und ist der Kern. Eine Semantikschicht ist nicht deshalb wertvoll, weil sie schnell erzeugt, sondern weil hinter jeder Definition ein Mensch steht. Die Zertifizierung ist der Ort, an dem diese Verantwortung festgehalten wird.
Vor der Zahl kommt ein Pruefschritt
Eine Frage laeuft durch fuenf Stufen: Absicht lesen und die genannten Entitaeten herausziehen, Kandidaten fuer Begriffe, Spalten und Attribute per Vektorsuche holen, daraus das SQL schreiben, die Filterwerte und die ganze Abfrage gegen die Datenbank testen und reparieren, was scheitert, zuletzt ausfuehren und die Antwort mit SQL und Schritten zurueckgeben.
Die vierte Stufe trennt es von gewoehnlichen Text-zu-SQL-Werkzeugen. Viele schreiben die Abfrage und fuehren sie aus, und ein falsches oder leeres Ergebnis geht trotzdem hinaus. Dieses prueft erst, ob ein Filterwert wie Pennsylvania in der Datenbank ueberhaupt existiert und so geschrieben ist wie die Daten, und laesst die Abfrage vorher trocken laufen.
Dazu kommt eine Absage. Im offiziellen Beispiel hat die Frage nach dem Werbeerfolg eines Produkts im Juni 2015 keine Grundlage: die Abdeckung liegt bei 0.5, und statt eine Zahl zu erfinden, antwortet das System, in diesen Daten steckten keine Werbeausgaben, und bietet den Umsatz jenes Monats an oder eine andere Datenbank. Diese Antwort ist mehr wert als eine praezise wirkende falsche Zahl.
Anbindung an einen Agenten ueber MCP
Das Projekt bringt einen FastMCP-Server mit, der ausschliesslich lesende Werkzeuge anbietet: pruefen, ob eine Installation bereit ist, Begriffe suchen, Spalten und SQL-Attribute eines Begriffs holen, beurteilen, ob eine Frage aus der vorhandenen Ontologie beantwortbar ist, und eine Frage stellen, um Antwort samt Datenzeilen zu bekommen. Jeder Aufruf laeuft mit den Rechten des angemeldeten Nutzers, es ist kein Generalschluessel.
Es spricht ausserdem Apache Ossie, einen Standard zum Austausch semantischer Modelle, und importiert und exportiert YAML. Ein vorhandenes semantisches Modell muss nicht weggeworfen werden, was fuer Teams mit bestehender Warehouse-Governance zaehlt.
Aufwand und Passung
Es ist kein Werkzeug, das man installiert und vergisst. Die Einrichtung laeuft ueber Docker Compose oder Helm, braucht eine Postgres-17-Instanz und muss einen NVIDIA-Modellendpunkt erreichen, gehostet oder selbst betrieben, weil Inferenz und Einbettung darueber laufen. Die Standardkonfiguration bringt ein Modell schon mit, ein Wechsel bedeutet Aenderungen an Umgebungsvariablen.
Die Passung ist eng und klar: viele Datenbanken, uneinheitliche Definitionen und Fachbereiche, die selbst fragen wollen. Ein oder zwei Kerndatenbanken anbinden, die Ontologie einmal erzeugen, ein paar Dutzend Begriffe von Hand zertifizieren, dann fuer Agenten oeffnen; dieser Weg traegt. Die Unpassung ist genauso klar: ein kleines Team mit einer Datenbank und selbsterklaerenden Spaltennamen zahlt mehr fuer die Pflege, als es gewinnt.
Bemerkenswert an Auto-Ontology ist nicht, dass es eine Frage in SQL uebersetzt. Bemerkenswert ist, dass das Projekt zugibt, das Modell kenne die Definitionen Ihres Hauses nicht, und daraus eine Schicht baut, die ein Mensch pruefen und eine Maschine abfragen kann. Ob eine Zahl stimmt, endet weiterhin mit einem Nicken von jemandem, und die Arbeit hier besteht darin, diesem Nicken einen Ort zu geben.