
Fish Audio:10 秒音频就能克隆一个声音,免费档每月 8000 积分
给你一段十秒钟的录音,就能复刻出这个人的声音,还能让它用十三种语言说话——这是 Fish Audio 给出的承诺。它把自己定位成一个 AI 语音平台,产品线覆盖文本转语音、声音克隆和语音转文字,底层跑的是自家的 Fish Audio S2 系列模型。
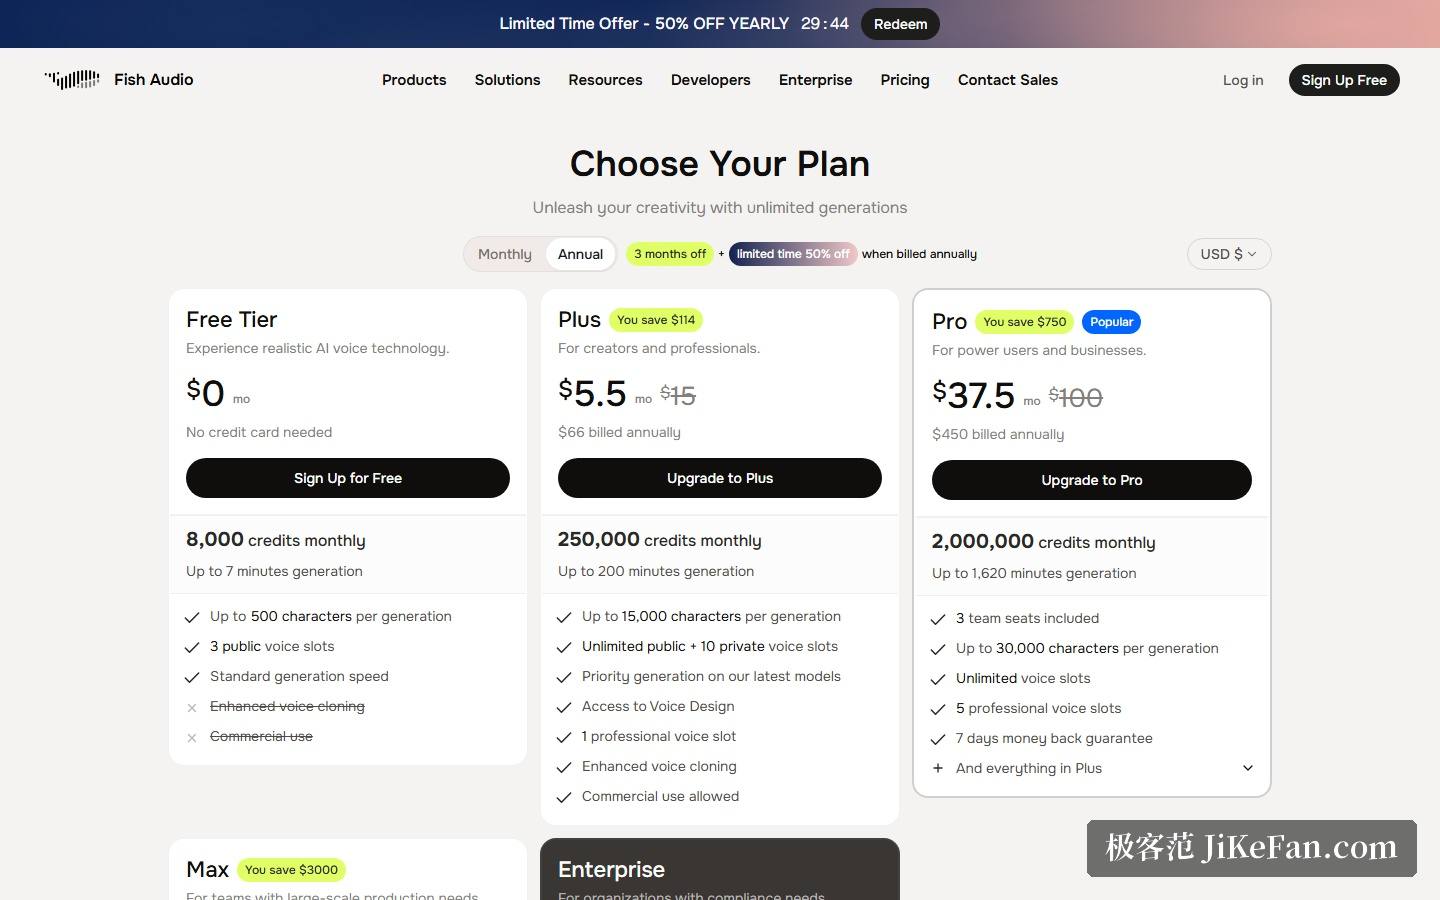
对只想先试试的人来说,门槛写在定价页最左边那一列:免费档每月给 8000 积分,注册不需要绑信用卡,也不要求先付费。
免费档能做什么,边界又在哪
把额度翻译一下会更直观:8000 积分大约对应 7 分钟生成时长,单次最多 500 个字符,官方给出的换算是每分钟生成消耗约 600 到 625 积分。除此之外,免费档还配了 3 个公开音色位和标准生成速度。
需要留意两条。定价页上「增强的声音克隆」和「商业使用」这两项在免费档那一列是被划掉的,说明它们不在免费范围内;官方常见问题里也写明,免费档生成的内容只能用于个人非商业项目,要商用得先升级到付费档。如果你打算把合成出来的语音用在会变现的内容里,这一点需要提前想清楚。
十秒音频克隆一个声音
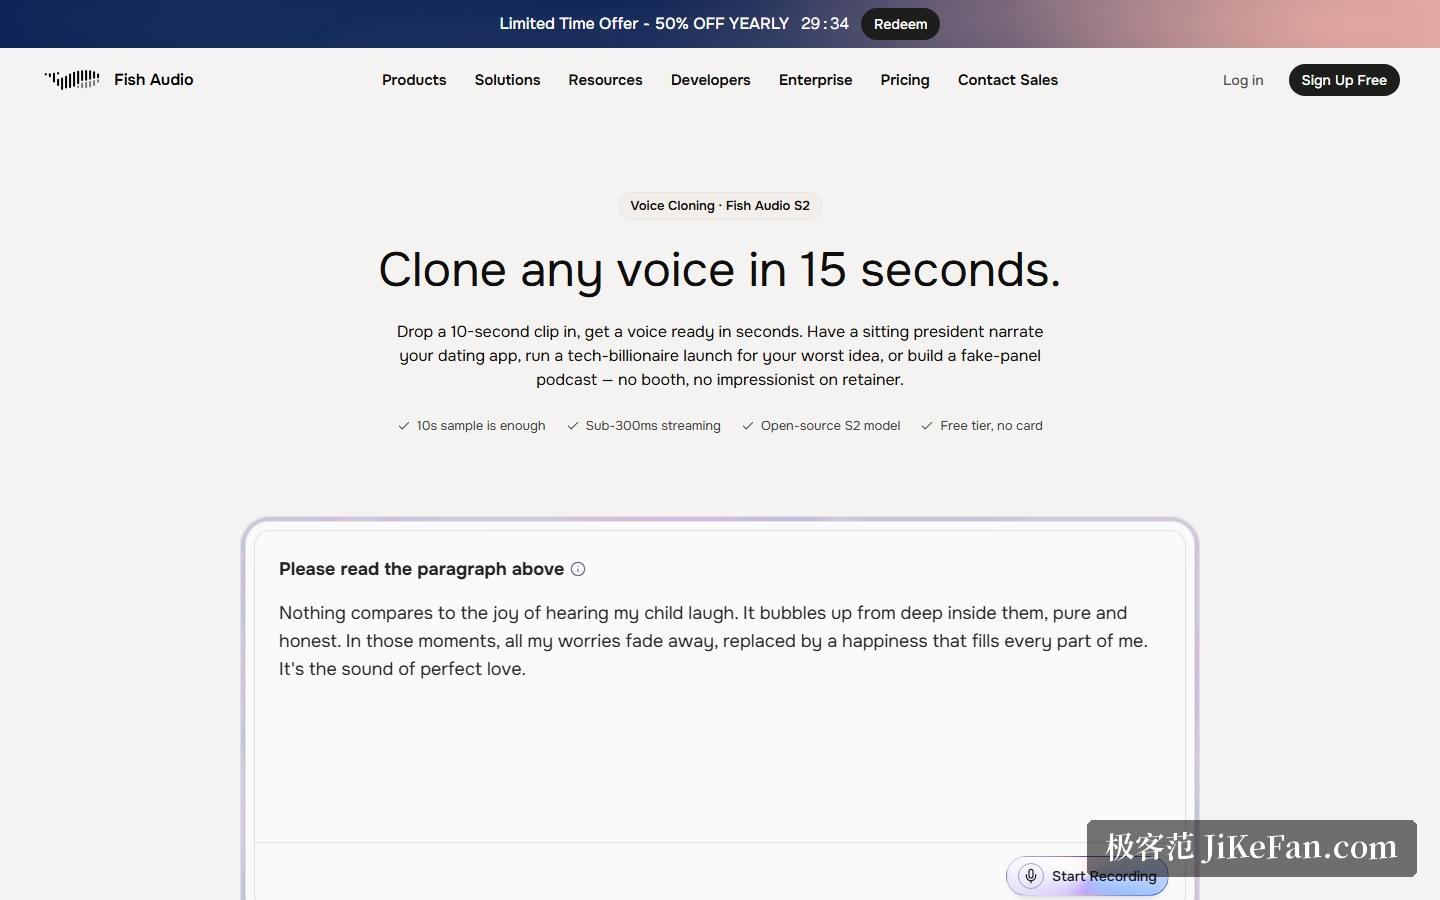
声音克隆是它主推的能力。官方页面写的是「十秒样本就够」——丢一段十秒的参考录音进去,几秒内得到一个可用的音色,不需要漫长的模型训练排队。配套的还有三件事:流式输出延迟在 300 毫秒以内;克隆一次就能跨语言使用,官方口径是零样本覆盖 13 种语言,不必为每种语言单独准备模型或重新录音。
还有一点值得单独说:S2 模型本身已经开源,官方提供了自行部署这条路。对隐私敏感、或者想在本地环境跑的场景,这比纯云端服务多一个选择。
情绪标签:让合成语音带上语气
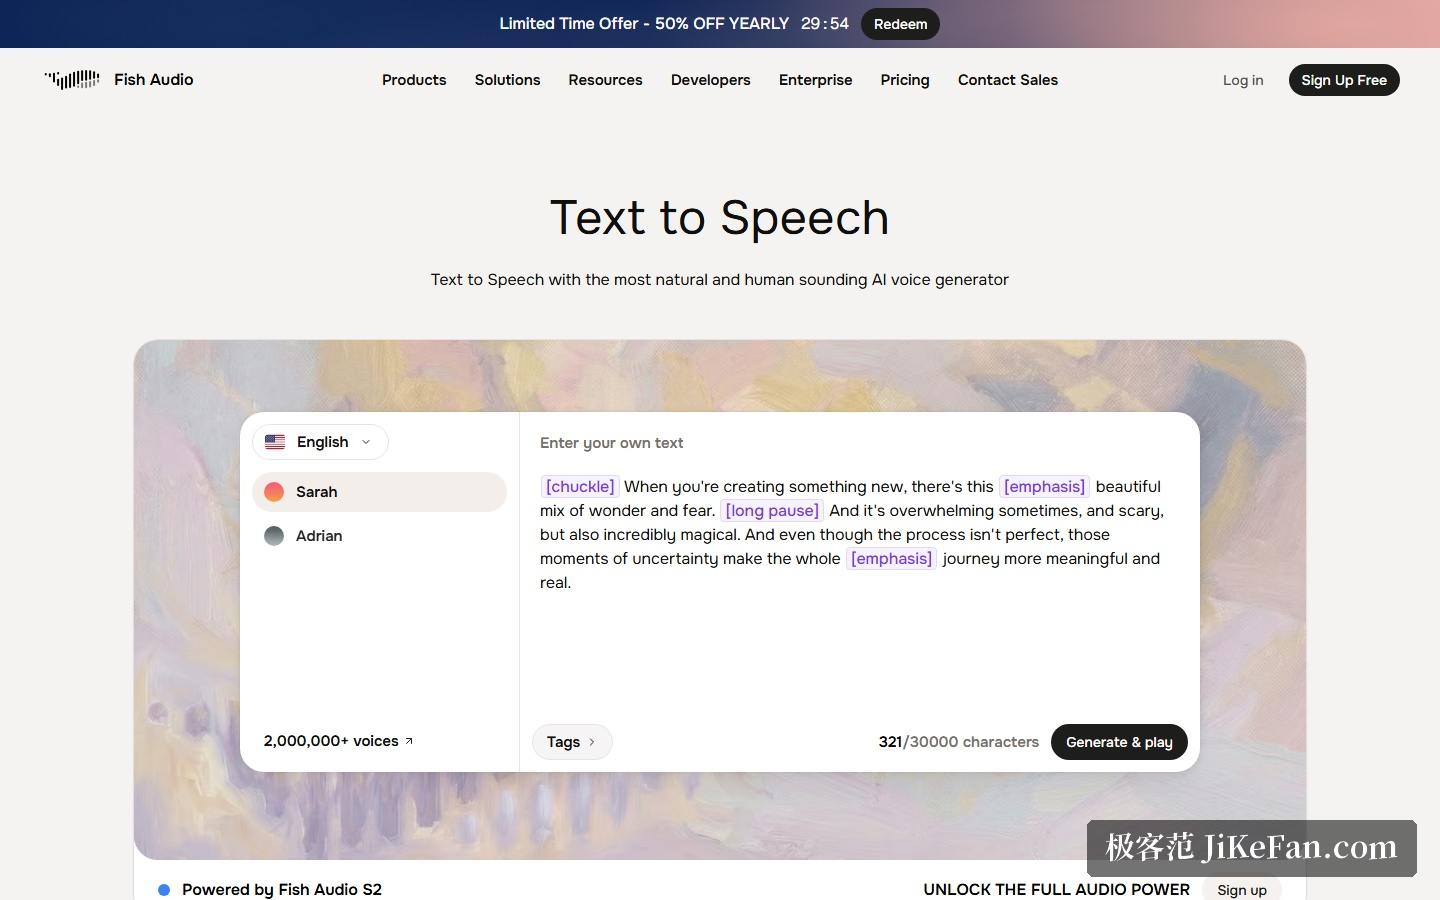
用过语音合成的人多半碰到过同一个问题:念得准,但念得平。Fish Audio 的解法是把标签直接插进文本里。截图上这段示例文本中嵌了 [chuckle]、[emphasis] 和 [long pause] 三个标记,模型会按标记处理笑声、重音和停顿。
这类标签官方说有 60 个以上,分成 Emotions 与 Special 两组:前者是 [angry]、[sad]、[whispering] 这类情绪,后者是 [laughing]、[sighing] 这类更接近人声反应的标记。写旁白或者做角色配音时,这比在后期里反复调整要省事得多。
两百万个声音,八种语言
不想自己调音色的人可以直接从库里挑。官方口径是平台上有 200 万个以上声音,语音库支持按性别、年龄、音调、能量、情绪和用途筛选,挑之前可以逐个试听。合成侧的语言覆盖,官方列出的是英语、日语、韩语、中文、法语、德语、阿拉伯语和西班牙语八种。
不止配音:它还有别的音频工具
除了文本转语音,产品线上还挂着语音转文字、变声、人声分离、音频翻译与音效生成等入口。语音转文字这一块,官方写明支持实时转写与自动断句,能加说话人标签和时间戳,结果可以导出成 SRT、VTT 或 JSON——做过字幕的人应该清楚,这几种格式意味着能直接进剪辑流程。它支持的语言比合成那边更多,官方写的是 80 种以上。
价格档位怎么排
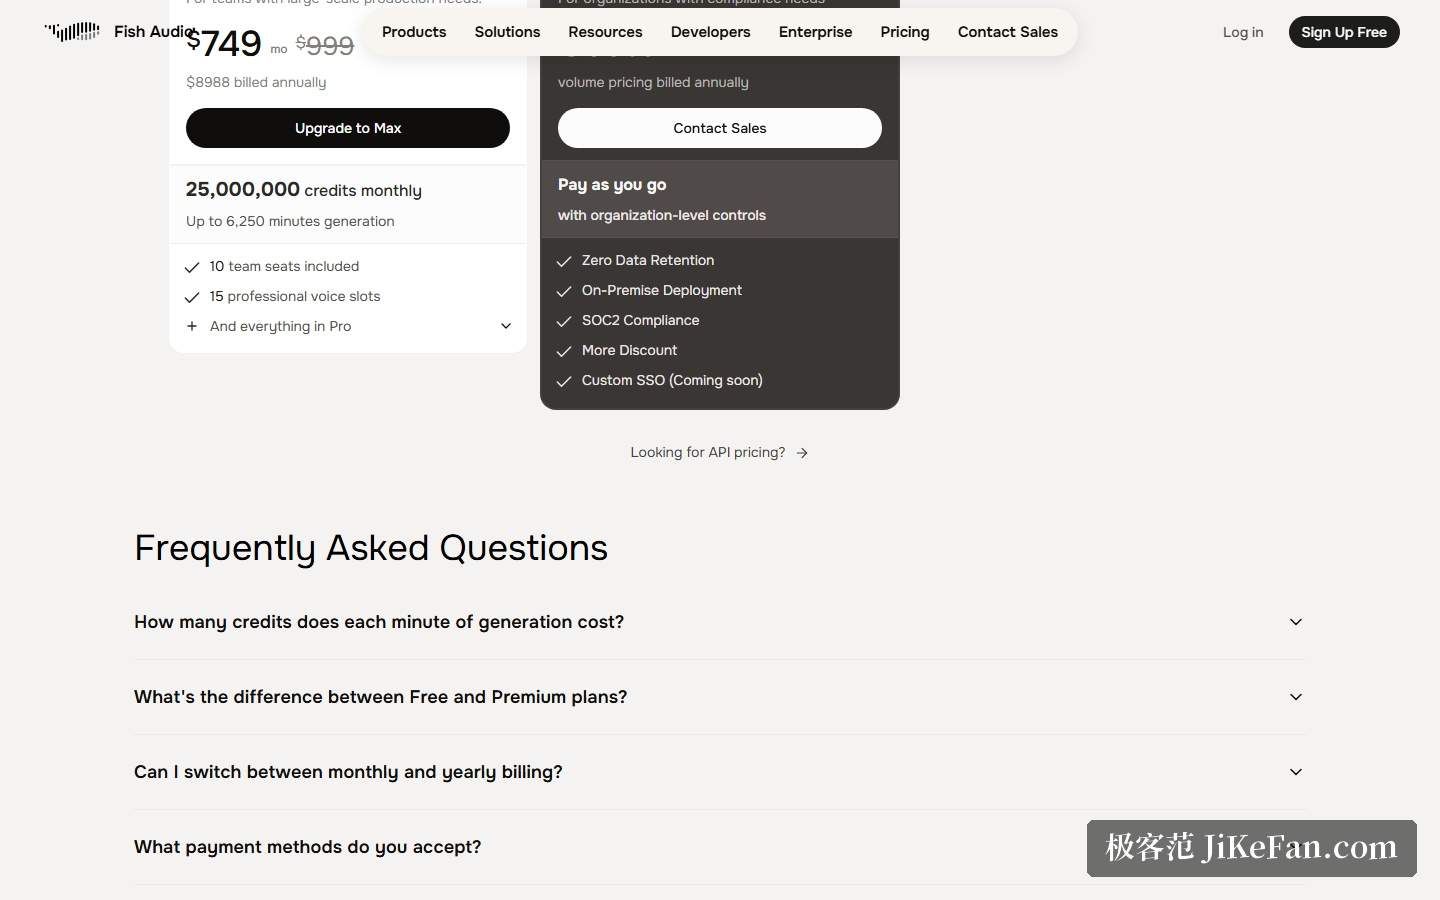
免费档往上还有三档。Plus 按年付费 66 美元,给 25 万积分、约 200 分钟生成时长,单次上限提到 1.5 万字符,并解锁声音设计与商用授权;Pro 按年 450 美元,200 万积分、约 1620 分钟,含 3 个团队席位,单次最长 3 万字符;再往上是 Max 和按需报价的 Enterprise,后者面向有合规需求的机构,提供零数据保留与本地部署这类选项。
它适合谁
如果你在做视频配音、有声书,或者要给游戏角色配一整套声音,Fish Audio 的上手路径很短:注册、挑一个声音或传十秒样本、把稿子贴进去、加标签、导出。免费档的额度足够把整个流程跑通一遍,再决定要不要为商用授权和更大的额度付费。
要提醒的是克隆的边界。技术上门槛已经很低,但用别人的声音做内容会涉及人格权与声音权,尤其是公众人物;官方常见问题里也专门提示了克隆公众人物声音前需要注意的事项。拿不准的话,先用自己有权利的声音,或者老实用库里那些已获授权的音色。
工具把门槛压低了,但判断仍然在人这边。十秒钟就能复刻一个声音,真正难的其实是想清楚这个声音该不该被复刻、又该用在什么地方。