
Strata 0.2.10 ouvre un contexte de 128K sur une carte de 8 GB et accelere Qwen3.8 en local
Résumé
Strata 0.2.10 remplace le decodeur speculatif par defaut par un brouillon de 625 MB et permet a une carte de 8 GB d ouvrir un contexte de 128K, tandis que le partitionnement complet sur deux cartes Linux double presque l edition de code.
Recommander- Nom
- Strata
- Version
- 0.2.10
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsmacOSLinux
- Mis à jour
- 2026-11-03 23:00
Deux choses font le plus mal quand un grand modele tourne sur sa propre machine. L une est que la carte a trop peu de memoire pour tenir un contexte long. L autre est une lenteur qui rend le travail desagreable. Strata 0.2.10 attaque les deux a la fois : le decodeur speculatif par defaut est remplace par un petit auxiliaire de six cents megabytes environ, et une carte de 8 GB peut desormais ouvrir un contexte de 128K.
Ce que cette version change
Strata est un client de grands modeles qui tourne sur son propre ordinateur, ecrit en C++, sous licence MIT, heberge sur GitHub et proche des quarante mille etoiles. Le positionnement est etroit et clair : du materiel grand public, deux entrees avec une application de bureau et un terminal, on choisit un modele apres l installation et on commence a dialoguer, a ecrire du code ou a lire des images, sans compte et sans serveur sur le chemin.
Les numeros de version demandent de l attention. L application et le terminal sont tous deux en 0.2.10, tandis que le composant de controle et les paquets des moteurs sont en 0.1.56. Les notes de version enoncent les points sans detour : DFlash2 devient le brouillon par defaut, le moteur de partitionnement complet sur plusieurs cartes s active seul sous Linux, un nouveau modele ISTA-DAS Coder arrive, le Mac lit les images, et un contexte de 128K fonctionne des une carte de 8 GB.
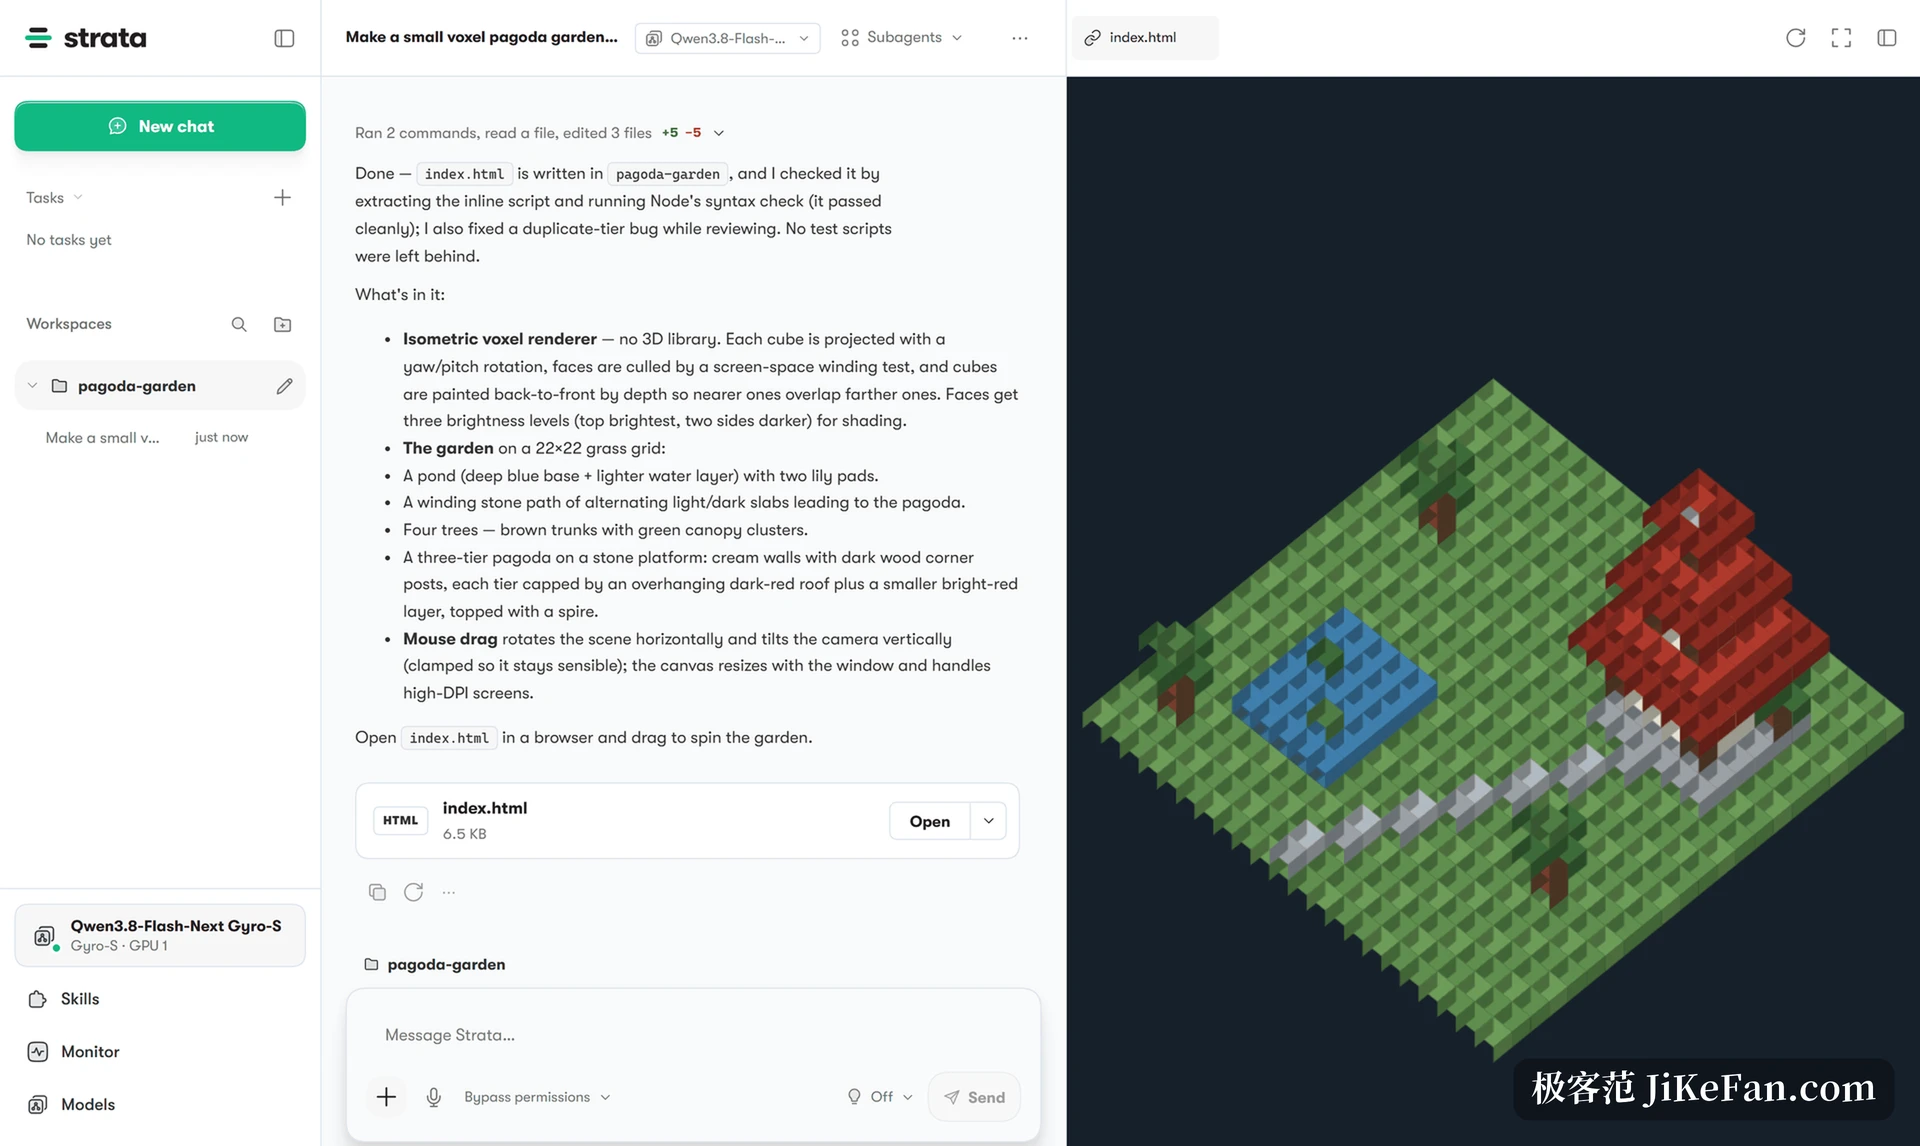
Six cents megabytes remplacent une couche speculative de cinq gigabytes
Le decodage speculatif fait deviner la suite par un petit modele auxiliaire, puis le modele principal verifie ces suppositions par lots ; plus elles tombent juste, moins de temps passe dans la generation caractere par caractere. La version precedente utilisait une couche speculative nommee MTP qui prenait environ 5.2 GB de memoire graphique ; celle-ci utilise DFlash2 autour de 625 MB, et la difference libere un peu plus de quatre gigabytes.
La memoire liberee devient directement du contexte utilisable. La comparaison publiee, meme moteur et memes fichiers : sur une machine Ryzen AI Max sous Windows les reponses courtes gagnent 12 pour cent et les longues 8.8 ; sur une RTX PRO 5000 en decodage glouton 7.9 ; sur un Apple M5 Max 7.4 ; sur un DGX Spark 5.8. Il y a aussi un contre-exemple, une Intel Arc A750 tourne 2.6 plus lentement qu avec MTP, et les notes le disent franchement.
Le prix est la concurrence. DFlash2 traite une requete a la fois, en lancer plusieurs impose de revenir a MTP, et il en va de meme quand la famille de modeles n est pas Qwen3.8. Le choix automatique est integre au programme : en automatique il decide selon le materiel et le scenario, un mauvais choix se corrige a la main, et un seul brouillon se charge par execution au lieu des deux.
Comment 128K tient dans 8 GB de memoire graphique
Un contexte long mange du cache. Sur une carte de 8 GB, ouvrir 64K ou plus echouait au demarrage des que le cache des experts se remplissait, et les utilisateurs retombaient vers 48K. Cette version change la place des ressources : quand la memoire graphique se serre, les donnees circulent dynamiquement entre elle et la memoire systeme, la longueur de contexte demandee est preservee autant que possible, et au besoin une partie du cache deborde en memoire systeme voire sur le SSD.
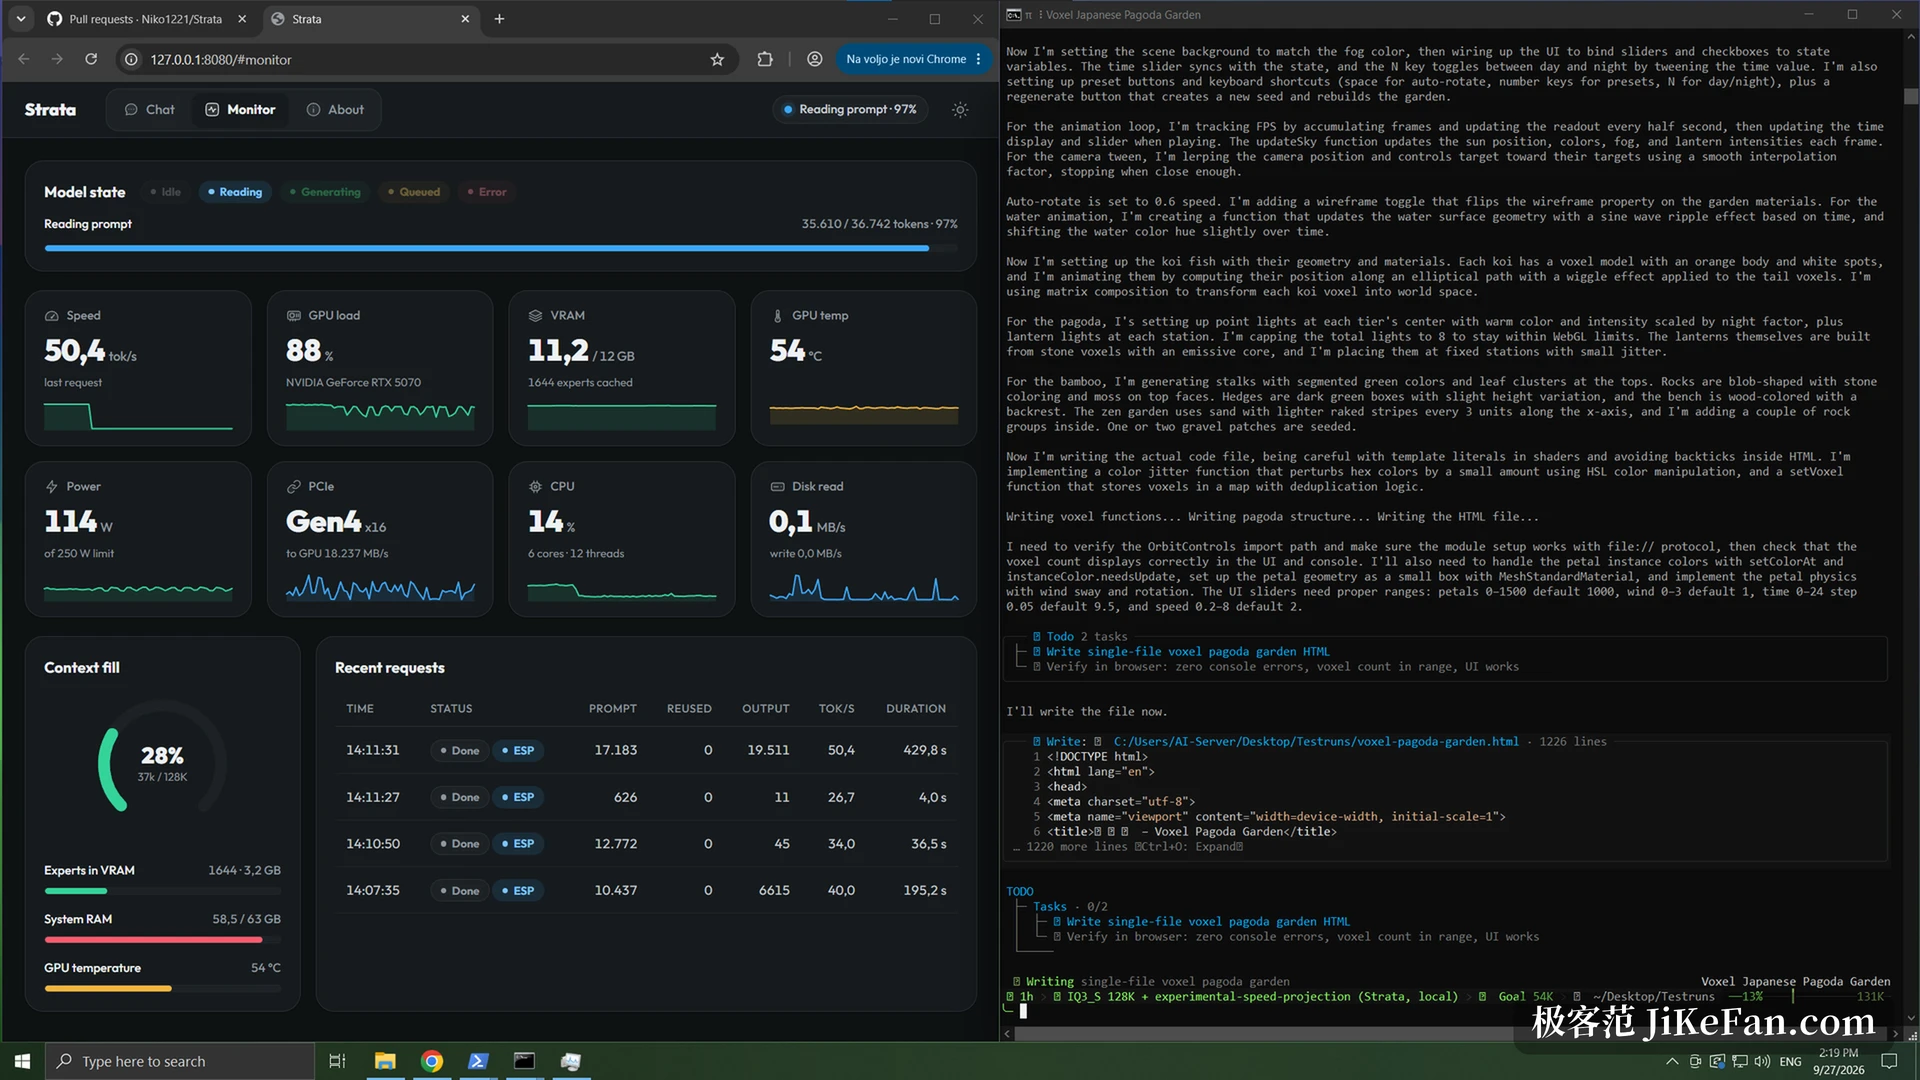
Les chiffres mesures ressemblent a ceci : avec la machine de test contrainte aux conditions d une carte de 8 GB, Qwen3.8 en quantification IQ3_S avec 128K a genere 63 a 73 jetons par seconde en mode DFlash2 et a lu une consigne de 32K en 19.8 secondes, avec encore 390 MB de memoire graphique libre. Sur une vraie Intel Arc A750 de 8 GB, les quatre combinaisons de demarrage en 128K ont reussi, a 12.7 jusqu a 14.8 jetons par seconde. Une carte de 12 GB n est pas touchee et garde son rythme.
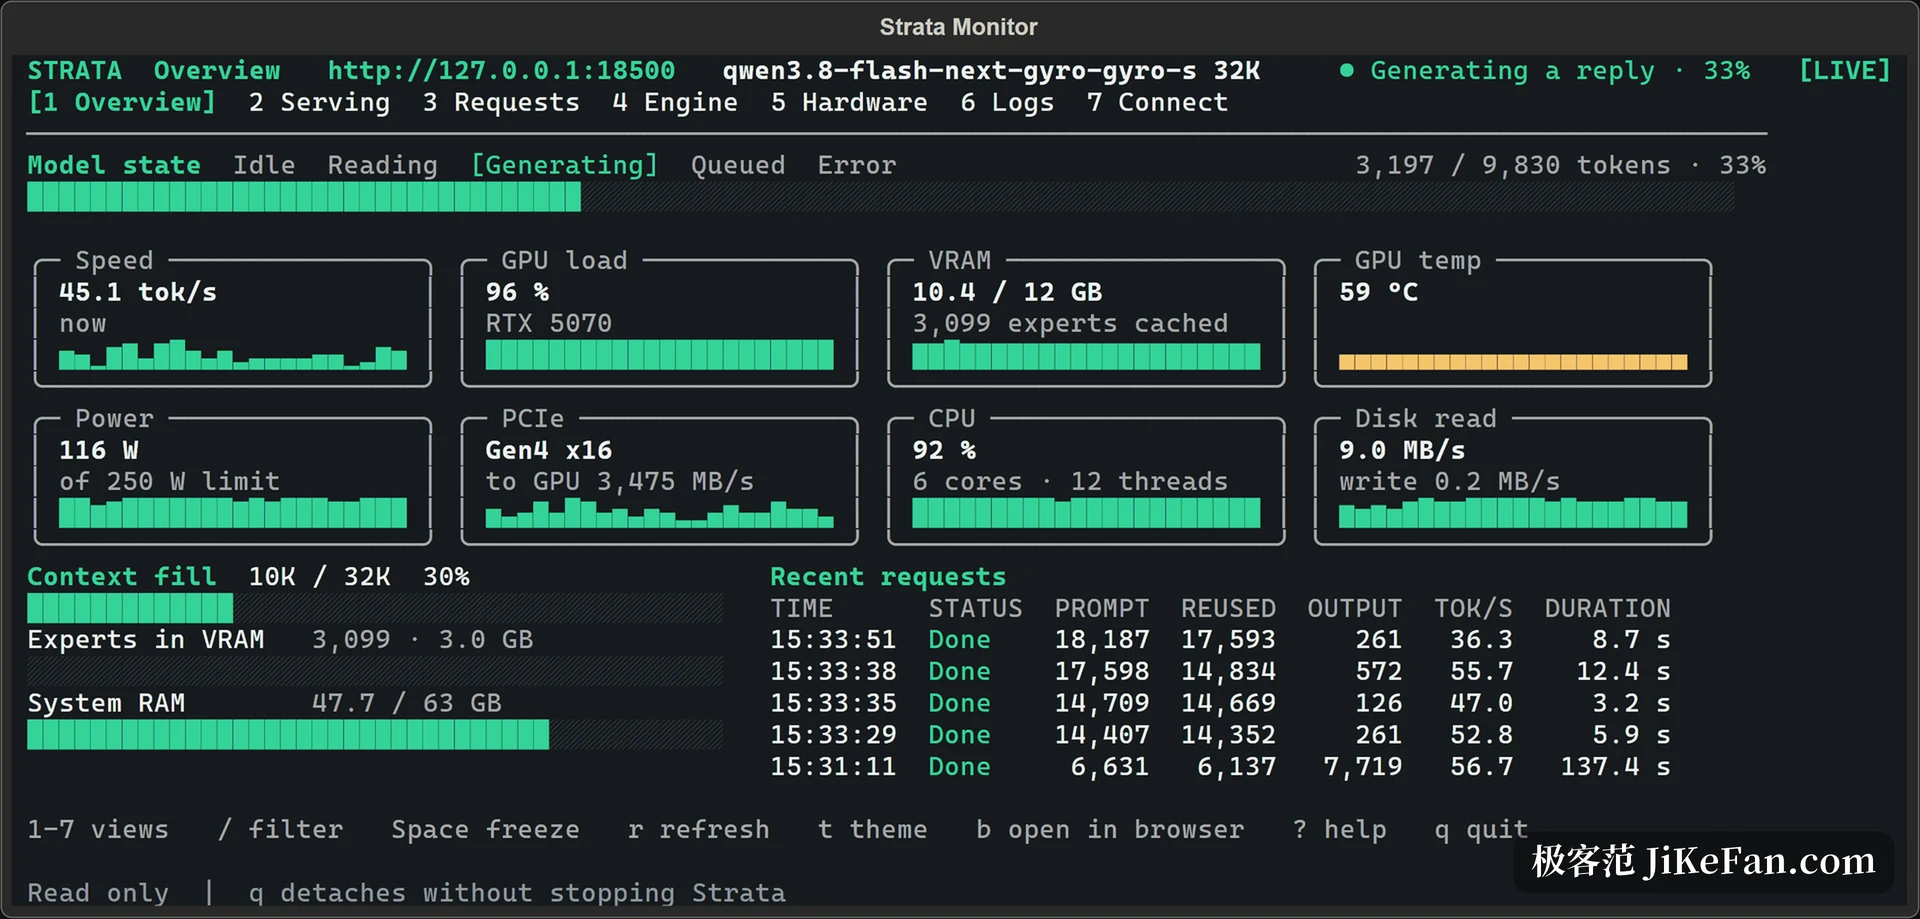
Ce chemin a un seuil. Des que la pression se partage avec la memoire systeme et le disque, les exigences sur la RAM de la machine montent, et la regle de la communaute est 32 GB pour commencer, 48 GB pour etre a l aise, 64 GB pour ne plus y penser. Le disque a besoin de place aussi, car les fichiers de modele ne sont pas petits.
Deux cartes ensemble, et l edition de code presque doublee
L ancienne approche avec plusieurs cartes est le decoupage par couches : chaque carte possede une partie des couches et passe le resultat a la suivante. Cette version active par defaut dans le terminal Linux un autre decoupage, appele partitionnement complet : chaque carte detient une tranche de chaque couche, et toutes lisent les poids et calculent au meme instant. Le gain est une memoire mieux repartie ; le cout est un echange constant de resultats intermediaires, donc la bande passante de la liaison compte.
Le projet a mesure deux RTX A6000 sous Linux : l edition de code est passee de 195 jetons par seconde a 377 jusqu a 394, l ecriture de code neuf de 139 a 144 vers 189 a 232, le texte ordinaire de 93 a 139 a 146, et une boucle d agent de 112 a 119 vers 165. Lire une longue consigne devient un peu plus lent, une consigne de 32K passant de 7.65 a 10.1 secondes, soit du debit achete avec la latence du premier jeton.
L activation automatique a des conditions strictes : Linux, deux cartes NVIDIA de capacite de calcul 8.6 ou 12.0, ou quatre Radeon AI PRO R9700 avec des fichiers de quantification precis ; le modele doit etre Qwen3.8, que le moteur sait traiter ; tous les experts routes doivent tenir en memoire graphique ; et environ 43 GB de memoire systeme libre doivent rester. Si les conditions ne sont pas remplies, le logiciel revient au decoupage par couches, explique pourquoi, et l automatisme peut aussi etre coupe a la main.
Deux choses corrigees au passage
La premiere est le demarrage sous Windows. Dans certains demarrages en arriere-plan la priorite de lecture du disque etait abaissee au point que le chargement du modele ralentissait nettement ; cette version la remonte. La seconde est l entree d images sur le Mac : sur un M5 Max, huit requetes d image ont ete lues correctement huit fois, la generation avec image tournait a 19 jusqu a 22 jetons par seconde contre 21 a 22 en texte seul, la tour d image prenait 319 MB de memoire graphique en plus, et le pic de memoire du moteur restait a 74 GB, au niveau du cas texte.
Le nouveau ISTA-DAS Coder prend 192 des 384 experts de DeepSeek-V4.1-Flash a chaque couche ; sur quatre cartes R9700 il decode a 59.2 jetons par seconde, sur une seule carte 22.8, et sur un Apple M5 Max 19.1 jusqu a 22.5. Tous ces chiffres viennent des notes de version et ont ete releves sur des machines differentes, donc une comparaison entre eux ne veut pas dire grand-chose ; l ordre de grandeur est ce qui compte.
Qui devrait mettre a jour
Qui possede une carte grand public de 8 GB a 12 GB et veut un contexte long devrait changer, car cela transforme un scenario qui ne demarrait pas du tout en un scenario qui tourne. Qui a deux cartes et fait tourner Qwen3.8 sous Linux gagne de facon assez directe avec le partitionnement complet. Pour qui a une seule grande carte et surtout des conversations, la difference apres la mise a jour est surtout que le premier demarrage telecharge environ 1.2 GB de fichiers de brouillon.
Un avertissement : ces projets avancent vite, et un numero de version par jour est courant. La documentation est assez detaillee sur le materiel, les niveaux de quantification et les reglages de concurrence, et il vaut la peine de la lire en regard de sa propre configuration plutot que de recopier les parametres de quelqu un d autre.