
Scrapling 0.5.1: un site en Markdown, et un navigateur
Résumé
Scrapling 0.5.1 est un cadre Python libre: pages et sites entiers deviennent du Markdown propre, les selecteurs survivent a une refonte.
Recommander- Nom
- Scrapling
- Version
- 0.5.1
- Tarif
- Gratuit
- Open source
- Open source
- Système
- WindowsmacOSLinux
- Mis à jour
- 2026-11-10 23:00
Scrapling est un cadre d'extraction ecrit en Python qui tient dans une seule bibliotheque les requetes, le navigateur, l'analyse, la collecte d'un site entier et l'export. La version 0.5.1, sortie le 4 novembre 2026, fait deux choses: elle ouvre la session de navigateur a des programmes exterieurs, pour qu'un agent lise le mouvement et le glisser, et elle aplanti le chemin d'un site entier vers du Markdown propre. Qui constitue un corpus, ou laisse une IA lire des pages publiques, en a pour dix minutes. Cela tourne sous Windows, macOS et Linux.
Laver la page en Markdown avant de la donner au modele
Un grand modele perd sur du HTML brut. Navigation, scripts, styles et emplacements publicitaires tiennent dans le meme fichier, et le texte utile est coince au milieu pendant que chaque caractere de bruit est facture pareil. Scrapling place la soustraction a l'etape de conversion: apres markdown(), scripts, styles et elements caches sont vides, et avec eux partent le texte blanc masque par CSS, les blocs marques aria-hidden, les commentaires HTML et les caracteres de largeur nulle.
Aucun modele ne s'assied sur ce chemin. C'est du traitement de chaines en local, donc dix mille pages ne coutent rien en modeles. L'economie n'est pas seulement financiere. Un corpus propre garde le decoupage stable en aval, et un passage retrouve n'arrive pas avec la moitie d'un menu colle dessus.
La conversion d'un site entier vient en modele pret. On fixe les domaines autorises, on nomme le selecteur de contenu, on donne un plafond de pages, et la passe laisse un dossier de fichiers .md plus un JSONL ou chaque entree porte source, titre et texte, pret a verser dans une base de connaissances. Les sites de documentation, les blogs et les manuels ont la structure reguliere qui rend cette voie la moins penible.
Les elements portent une empreinte, une refonte epargne le selecteur
La partie fragile d'un extracteur est le selecteur. Un site renomme ses classes CSS, le code qui marchait hier rend une liste vide, et il faut lire le journal couche par couche avant de voir la cause. Le suivi adaptatif des elements prend un autre chemin: la premiere recherche enregistre position, attributs et traits de texte en empreinte, et apres le changement de structure il cherche par ressemblance le noeud qui a bouge en restant la meme chose.
La correspondance d'elements semblables couvre l'autre cas courant. Une page porte des dizaines de cartes de meme facture et une seule est voulue: trouver d'abord un element de reference, puis elargir par ressemblance de structure, ce qui tient mieux qu'un nth-child ecrit a la main.
Une requete et un site entier partagent la meme ecriture
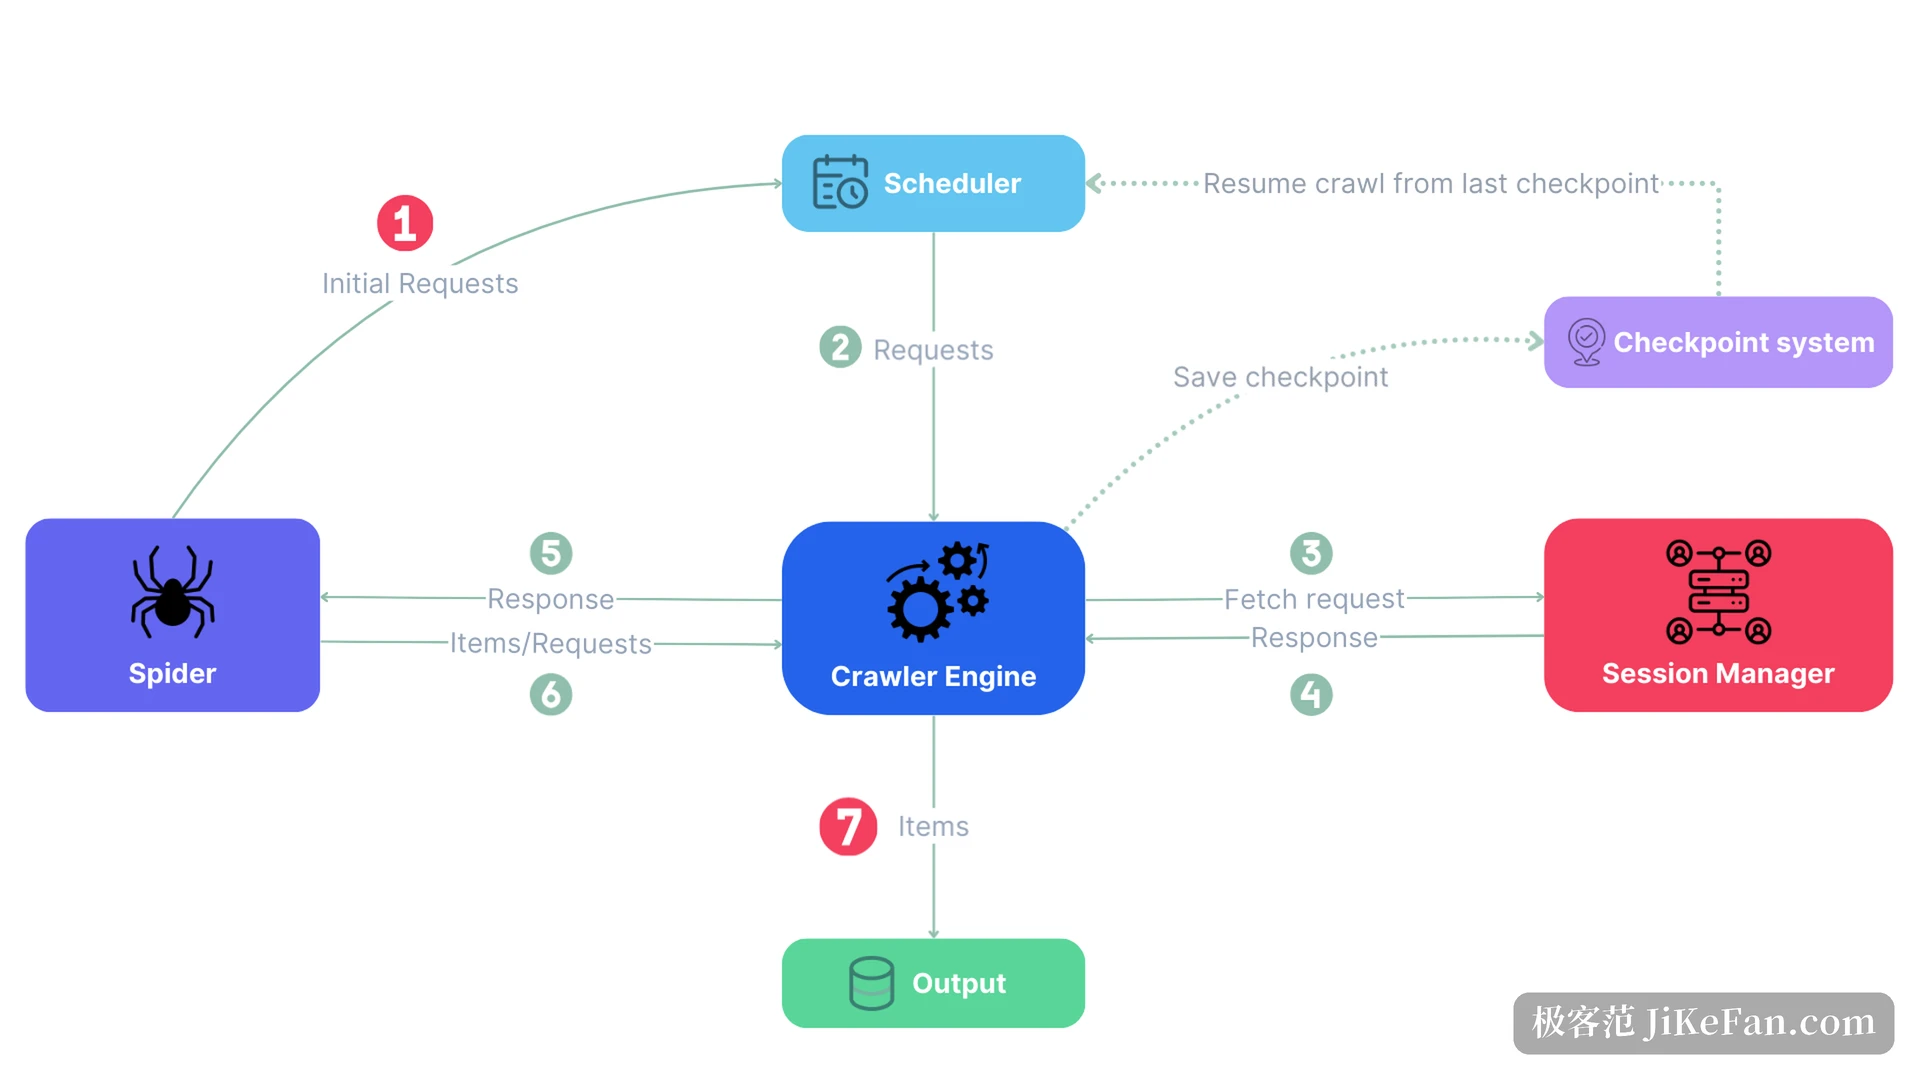
- Fetcher
- Des requetes HTTP ordinaires portant l'empreinte TLS et les en-tetes d'un vrai navigateur, de quoi couvrir pages statiques et interfaces publiques.
- Extracteur a navigateur
- Pilote Chromium par Playwright, attend la fin de JavaScript, et peut s'accrocher a un navigateur deja ouvert.
- Spider
- Collecte concurrente avec frein automatique, progres sauve sur Ctrl+C et reprise plus tard, export en JSON, JSONL, CSV ou XML.
Les trois prises partagent une seule interface d'analyse. Le meme code de selecteur passe d'une page statique a une page dynamique en changeant le fetcher, sans second dialecte pour le rendu JavaScript. Les requetes XHR derriere une page se laissent aussi enregistrer, et ce qu'une interface renvoie est souvent plus propre que le HTML qui l'affiche.
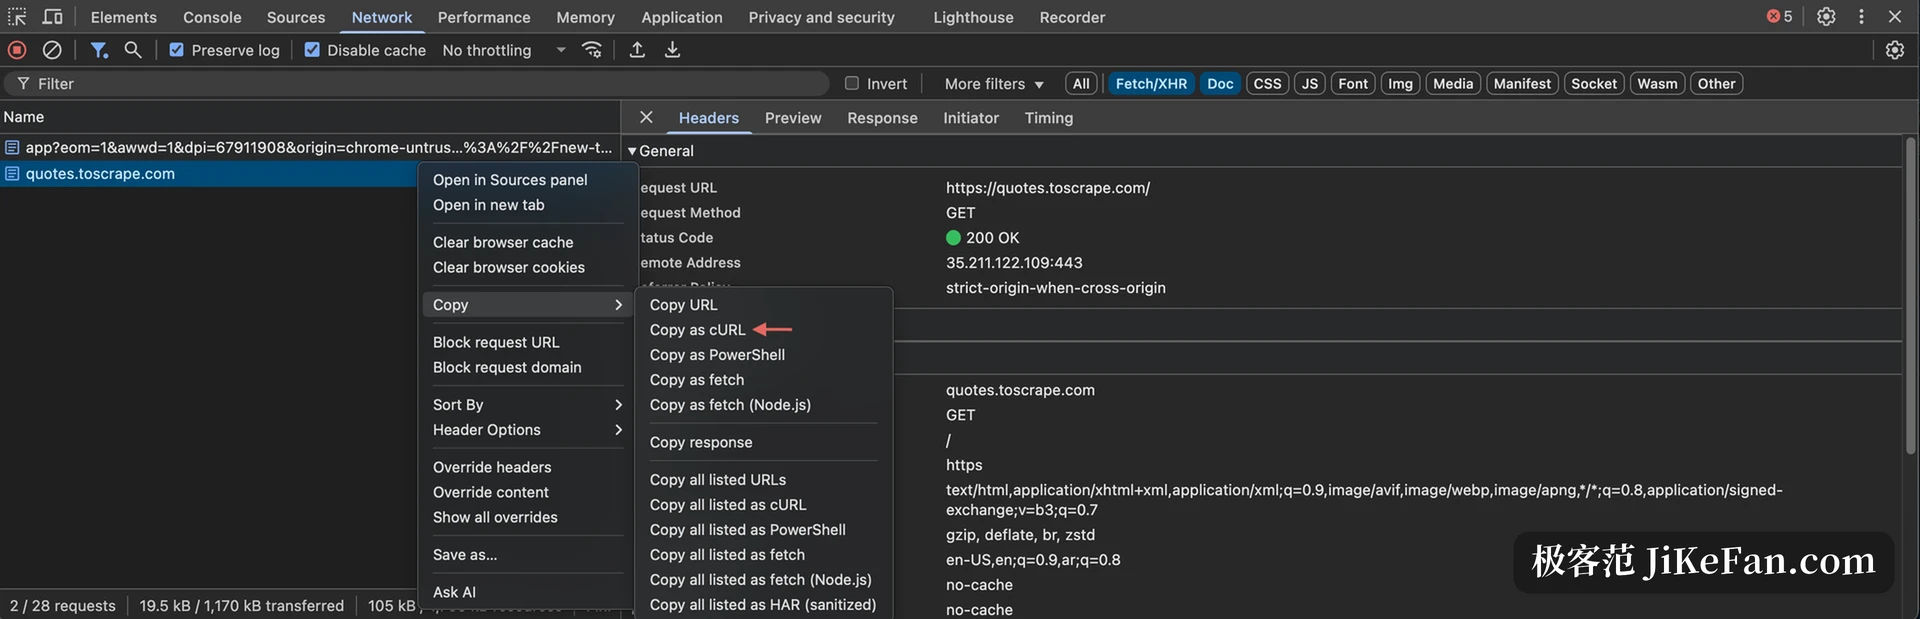
Un petit detail gagne sa place. En examinant une interface dans le navigateur, copier en cURL donne une requete complete; collee dans le shell interactif de Scrapling, elle devient une instruction reutilisable, prete a tourner une fois avant de rejoindre un script. La premiere passe a assembler les en-tetes a la main disparait.
Trois ouvertures dans la 0.5.1
| Version | Date | Changements |
|---|---|---|
| 0.5 | 2026-10-17 | Le serveur MCP recoit le parcours complet du navigateur, l'enregistrement des requetes reseau et la conservation de l'etat de connexion, le Shadow DOM ouvert, et le choix entre largeur et profondeur. |
| 0.5.1 | 2026-11-04 | Une classe de session distante reprend un Chromium deja lance; les agents lisent le mouvement et glissent en tenant la souris. |
La session distante compte parce qu'elle separe le navigateur du processus qui collecte. Elle se connecte par un point CDP a un Chromium deja lance, reutilise le contexte existant par defaut, herite de la connexion, et laisse les onglets ouverts quand la session se ferme. Porter un etat de connexion pendant une collecte obligeait sinon a ecrire et relire des fichiers d'etat sans arret.
Le mouvement et le glisser sont pour les agents. Une capture fixe un instant, et animation, position apres defilement ou curseur n'ont pas d'avant ni d'apres sur une image immobile. La 0.5.1 laisse l'agent lire une suite d'images et comprendre ce que fait la page, puis tenir la souris, bouger, s'arreter pour verifier et relacher. Les descriptions d'outils ont ete compressees en meme temps, donc la meme capacite coute moins de budget de contexte.
Plus d'une porte pour un agent
Le serveur MCP fait le travail: ouvrir des pages, cliquer, remplir, defiler, capturer et lire les reponses sont devenus des outils, si bien qu'on peut demander a un client de mettre les parametres d'une page en tableau et le voir finir. La competence d'agent fait autre chose. C'est un manuel tenu a jour avec les versions, qu'un assistant de code consulte en ecrivant du Scrapling, au lieu de reconstruire une interface de memoire. La ligne de commande et le shell interactif sont la troisieme voie, bonne pour faire tourner une requete avant de la poser dans un script.
Trois voies, trois publics. Les pipelines de donnees usent surtout l'interface Python, les bricoleurs de terminal aiment le shell, et qui confie la collecte a un agent touche MCP.
La limite reste la limite
Plus l'outil est fort, plus tot vient la question de ce qu'on prend. Documentation publique, prix publics et textes officiels publies relevent de l'usage courant. Un site qui interdit clairement l'acces automatique, ou garde son contenu derriere une connexion, n'en releve pas. Le Spider peut etre regle pour respecter robots.txt et borne a des domaines, afin qu'une passe reste dans sa cible. La frequence merite la meme retenue: une ou deux fois par jour montre ce qui a change, et le serveur d'un autre n'est pas un banc de charge.
La 0.5.1 vaut non parce qu'elle sait extraire, mais parce que l'extrait est utilisable: une page entre et du Markdown propre sort, un element deplace est reconnu, et un agent peut reprendre les commandes. L'ensemble est libre et tourne en local, au prix d'un outil qui demande du code, donc qui espere du pret a l'emploi sera decu. Ceux qui y gagnent construisent deja une base de connaissances, ou tracent un chemin de donnees pour un agent.