
Auto-Ontology: une couche semantique qui verifie tout
Résumé
Auto-Ontology est une couche semantique libre de NVIDIA: un glossaire metier pousse depuis la base, et chaque reponse arrive avec son SQL.
Recommander- Nom
- Auto-Ontology
- Version
- 0.1
- Tarif
- Gratuit
- Open source
- Open source
- Système
- LinuxWeb
- Mis à jour
- 2026-11-10 23:00
Auto-Ontology est une couche semantique libre publiee par NVIDIA. Elle fait pousser un glossaire metier depuis une base existante, puis amene un agent a repondre aux questions en s'appuyant sur ce glossaire. Le probleme vise est l'echec courant de l'analyse en libre-service: le modele lit le chiffre d'affaires dans la mauvaise colonne, le SQL passe, et le nombre est faux. Les equipes qui veulent du langage naturel sur leurs donnees metier sans faire confiance a la sortie du modele trouveront ici une facon de rendre cette etape verifiable. Le code est sous Apache 2.0, l'interface est web, le service tourne en conteneurs, et un seul point d'acces de modele suffit pour demarrer.
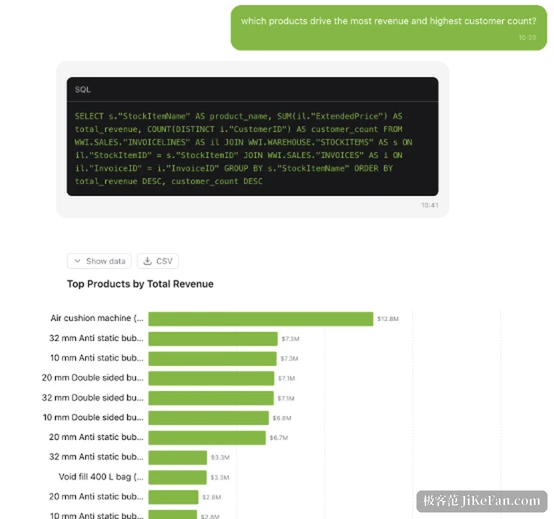
Ce qui manque n'est pas un traducteur, c'est un dictionnaire
Traduire du langage naturel en SQL est techniquement possible depuis des annees. Le difficile, c'est le sens. Le nombre de clients designe les comptes qui ont commande dans la table des commandes, et les societes enregistrees dans la table des clients. Le chiffre d'affaires peut inclure la taxe ou non, etre facture ou encore du. Le modele ignore quelle definition votre maison applique, alors il prend une colonne qui parait raisonnable.
Auto-Ontology remplit d'abord ce contexte: ou vivent les donnees, comment elles s'appellent, si l'usage est permis, comment s'en servir, d'ou elles viennent et ce qui leur ressemble. Ce savoir dort d'ordinaire dans des dictionnaires de donnees, des scripts SQL et la tete des anciens. Le projet le rassemble dans une structure interrogeable et remet cette structure a l'agent.
Trois types d'entrees dans le dictionnaire
Les termes sont les concepts metier, client ou ligne de facture, chacun avec une description et des synonymes, rattache a des colonnes precises. Les attributs SQL pendent sous un terme comme des expressions relues, la marge brute par exemple, si bien que l'agent reutilise un calcul au lieu d'en inventer un second. Les relations enregistrent la facon dont les tables se joignent, tables de liaison comprises, deduites des cles et de la forme des donnees.
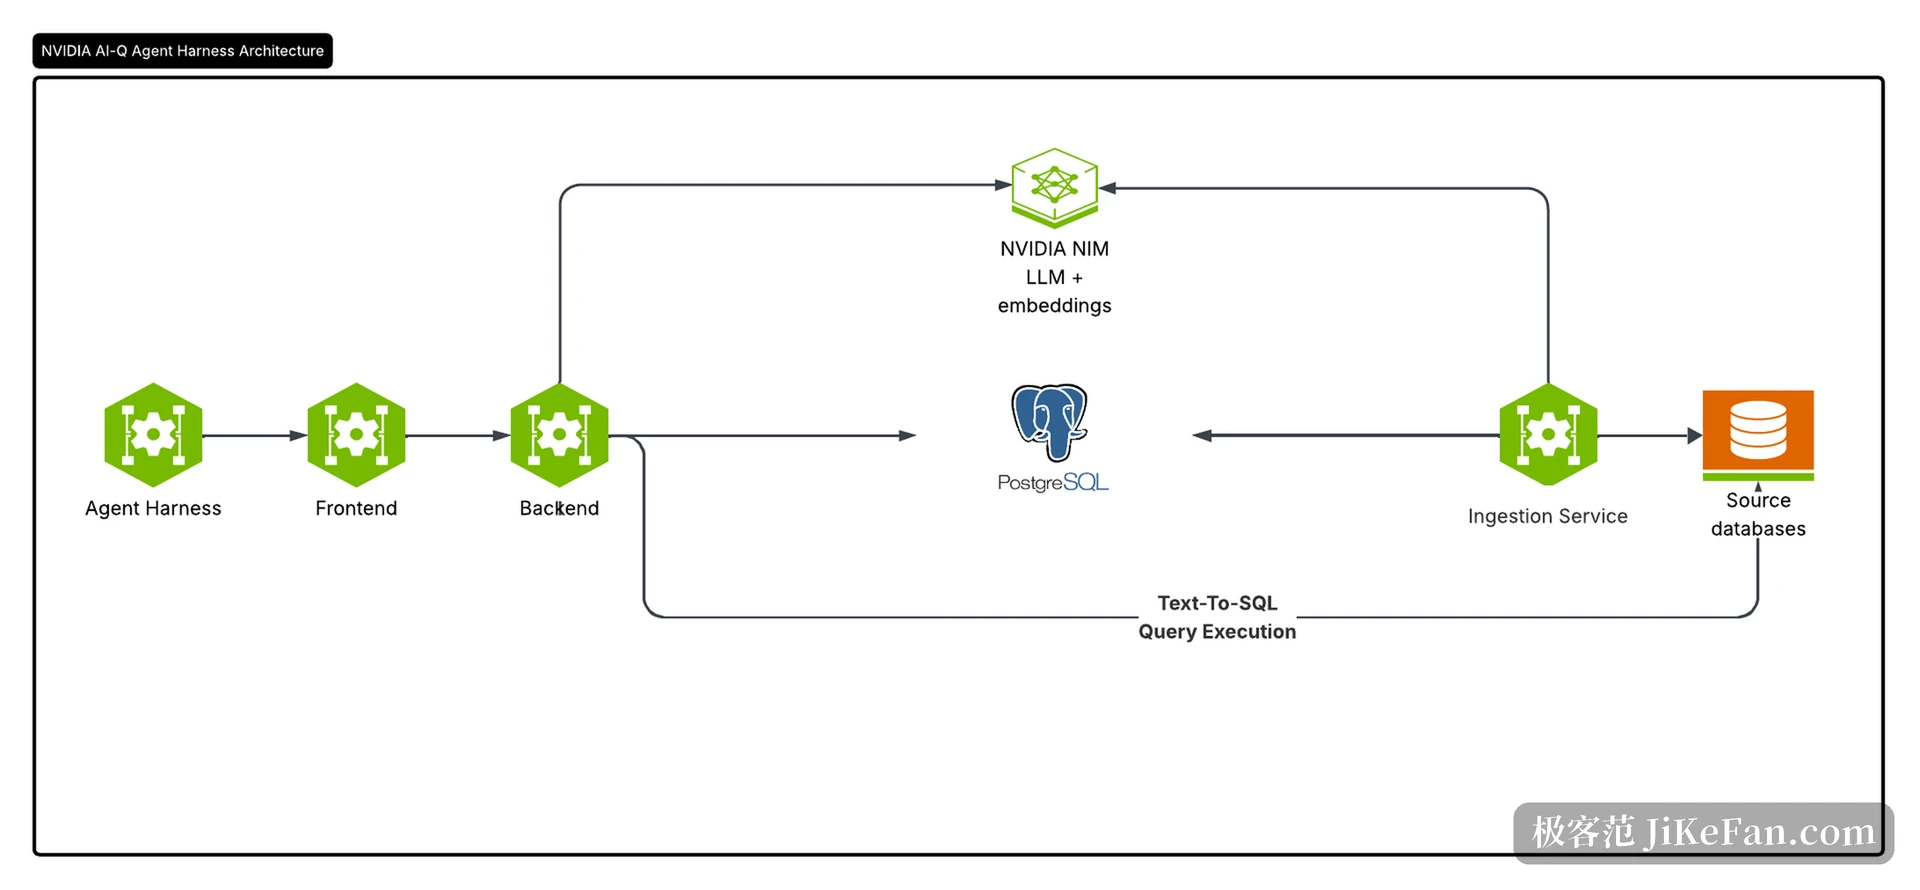
La generation se fait en quatre temps. Le service d'ingestion lit la base source, extrait le schema, profile les colonnes et echantillonne les valeurs. Il tire ensuite les termes table par table et les rattache aux colonnes, deduit les jointures entre tables et propose des attributs SQL a partir des requetes historiques. La derniere etape ecrit termes, relations et attributs dans Postgres et depose les vecteurs dans pgvector pour la recherche.
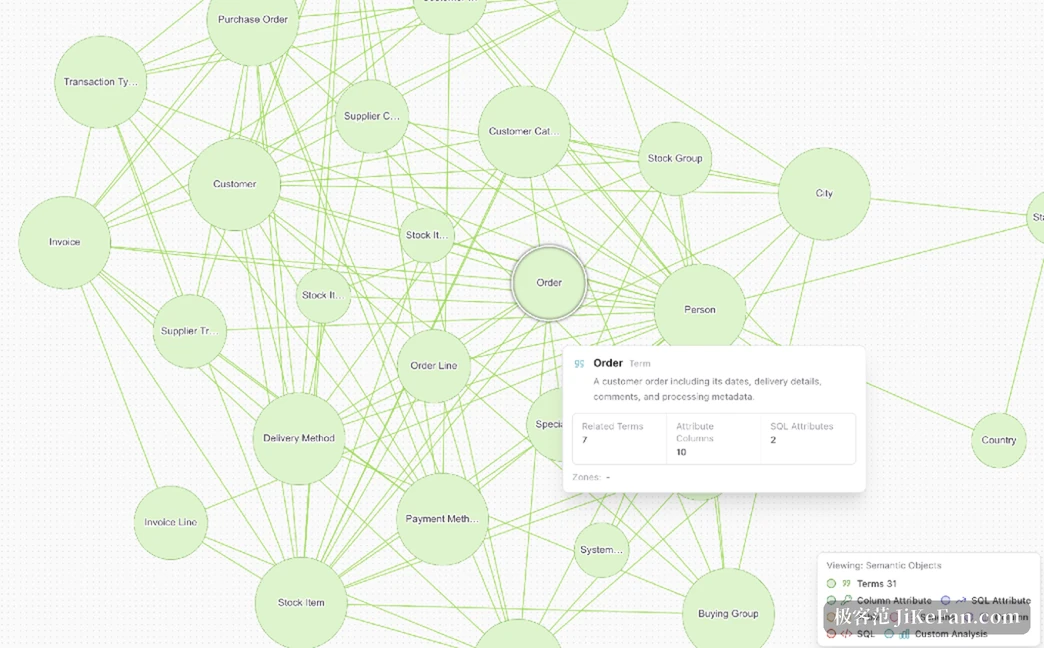
Ce que vous voyez ensuite est un graphe semantique que l'on peut parcourir. L'exemple officiel tourne sur la base de ventes Wide World Importers de Microsoft: une compilation produit 31 termes, et selectionner commande affiche la description, les termes lies, les colonnes rattachees et 2 attributs SQL. Les chiffres sont petits et montrent la forme de la structure.
La machine redige, un humain signe
Le materiel genere ne s'utilise pas tel quel. La certification est une etape a part. Vous essayez de vraies questions dans le dialogue, ou vous appelez les outils de controle par MCP, et la ou une description est fausse ou un attribut calcule mal, vous corrigez dans l'interface et certifiez terme par terme. Seuls les noms, descriptions et formules certifies comptent comme definitions fiables dans les reponses suivantes.
Cela parait lent, et c'est le point. Une couche semantique vaut par la personne qui repond de chaque definition, pas par la vitesse de generation. L'indicateur de certification est l'endroit ou cette responsabilite s'inscrit.
Un controle de plus avant le chiffre
Une question traverse cinq etapes: lire l'intention et extraire les entites citees, chercher par vecteurs les termes, colonnes et attributs candidats, ecrire le SQL, eprouver les valeurs de filtre et la requete entiere contre la base puis reparer ce qui echoue, enfin executer et renvoyer la reponse avec le SQL et les etapes.
La quatrieme etape le separe des outils texte-vers-SQL ordinaires. Beaucoup ecrivent la requete et l'executent, et un resultat vide ou absurde sort quand meme. Celui-ci verifie d'abord qu'une valeur de filtre comme la Pennsylvanie existe dans la base et s'ecrit comme les donnees l'ecrivent, et fait tourner la requete a blanc avant de montrer quoi que ce soit.
Il existe aussi un refus. Dans l'exemple officiel, une question sur le rendement publicitaire d'un produit en juin 2015 n'a rien derriere elle: la couverture tombe a 0.5, et au lieu d'inventer un chiffre le systeme repond que ces donnees ne contiennent aucune depense publicitaire, et propose le chiffre d'affaires du mois ou une autre base. Cette reponse vaut mieux qu'un nombre faux qui a l'air precis.
Brancher un agent par MCP
Le projet livre un serveur FastMCP qui n'expose que des outils en lecture: verifier qu'un deploiement est pret, chercher des termes, prendre les colonnes et attributs SQL d'un terme, juger si une question est repondable avec l'ontologie en place, et poser une question pour recevoir la reponse avec les lignes de donnees. Chaque appel tourne avec les droits de l'utilisateur connecte, ce n'est pas un passe-partout.
Il parle aussi Apache Ossie, un standard d'echange de modeles semantiques, et importe comme exporte du YAML. Un modele semantique existant n'a pas besoin d'etre jete, ce qui compte pour les equipes qui font deja de la gouvernance d'entrepot.
Le cout et le bon terrain
Ce n'est pas un outil que l'on installe et oublie. Le deploiement passe par Docker Compose ou Helm, demande un Postgres 17, et doit joindre un point d'acces de modele NVIDIA, heberge ou maison, puisque l'inference et les plongements passent par la. La configuration par defaut arrive avec un modele deja choisi, et le changer suppose de modifier des variables d'environnement.
Le bon terrain est precis: beaucoup de bases, des definitions flottantes, et des metiers qui veulent poser leurs questions. Brancher une ou deux bases centrales, compiler l'ontologie, certifier quelques dizaines de termes a la main, puis ouvrir aux agents: ce chemin tient. Le mauvais terrain est aussi net: une petite equipe avec une seule base et des noms de colonnes parlants paiera l'entretien plus qu'elle n'y gagnera.
Ce qui rend Auto-Ontology interessant n'est pas qu'il transforme une question en SQL. C'est que le projet admet que le modele ne connait pas les definitions de votre maison, et qu'il en fait une couche qu'un humain peut relire et qu'une machine peut interroger. La justesse d'un chiffre finit toujours par un hochement de tete humain, et le travail ici est de donner un endroit ou ce hochement se pose.