
Jimeng AI réunit image, vidéo et canevas derrière une seule entrée
Résumé
Génération d'images, production vidéo et un canevas qui garde le résultat modifiable partagent une seule entrée, les images d'ouverture et de fermeture se fixent toutes deux, et le flux est bâti autour des prompts en chinois.
Recommander- Nom
- Jimeng AI
- Version
- seedance-2
- Tarif
- Gratuit
- Open source
- Propriétaire
- Système
- WindowsmacOSiOSAndroid
- Mis à jour
- 2026-10-06 21:41
Les outils pour l'image et les outils pour la vidéo s'achètent généralement séparément, et retoucher ce qui en sort suppose d'ouvrir une troisième application. Jimeng AI prend une autre ligne. Sa position déclarée est celle d'une plateforme créative tout-en-un : génération d'images, production vidéo générative et un canevas qui permet de continuer à retoucher le résultat tiennent derrière une seule entrée, avec une galerie communautaire à côté pour les idées.
Images : pas seulement du texte vers l'image
La génération prend du texte ou une image comme point de départ, et un prompt court suffit. Le plus utile est ce qui arrive à une image existante. On peut demander que l'apparence d'une personne ou d'un sujet soit préservée, puis laisser le modèle changer le fond, transporter un style, tenir la direction artistique ou conserver la pose. Pour un travail répétitif comme changer le fond d'une photo produit ou redonner un style à un avatar, cela évite de redécrire le sujet à chaque fois.
Vidéo : les deux bouts du plan vous appartiennent
Côté vidéo, texte et image servent également d'entrée : un script ou une image fixe entre, un clip sort. Les promesses portent sur un mouvement cohérent, un écoulement naturel, un mouvement de caméra pilotable et des variations de vitesse réglables. La fonction de contrôle qui mérite une mention à part, ce sont les deux emplacements d'image : fournir une image d'ouverture et une de fermeture, fixer les deux extrémités et laisser le modèle remplir l'intervalle. C'est bien plus proche du plan qu'on a en tête qu'une seule phrase de description. Le second point concerne la langue : le système est bâti pour les prompts en chinois et les comprend mieux, ce qui aide avec les expressions figées, les noms propres et le ton d'un texte.
La deuxième génération et ses références
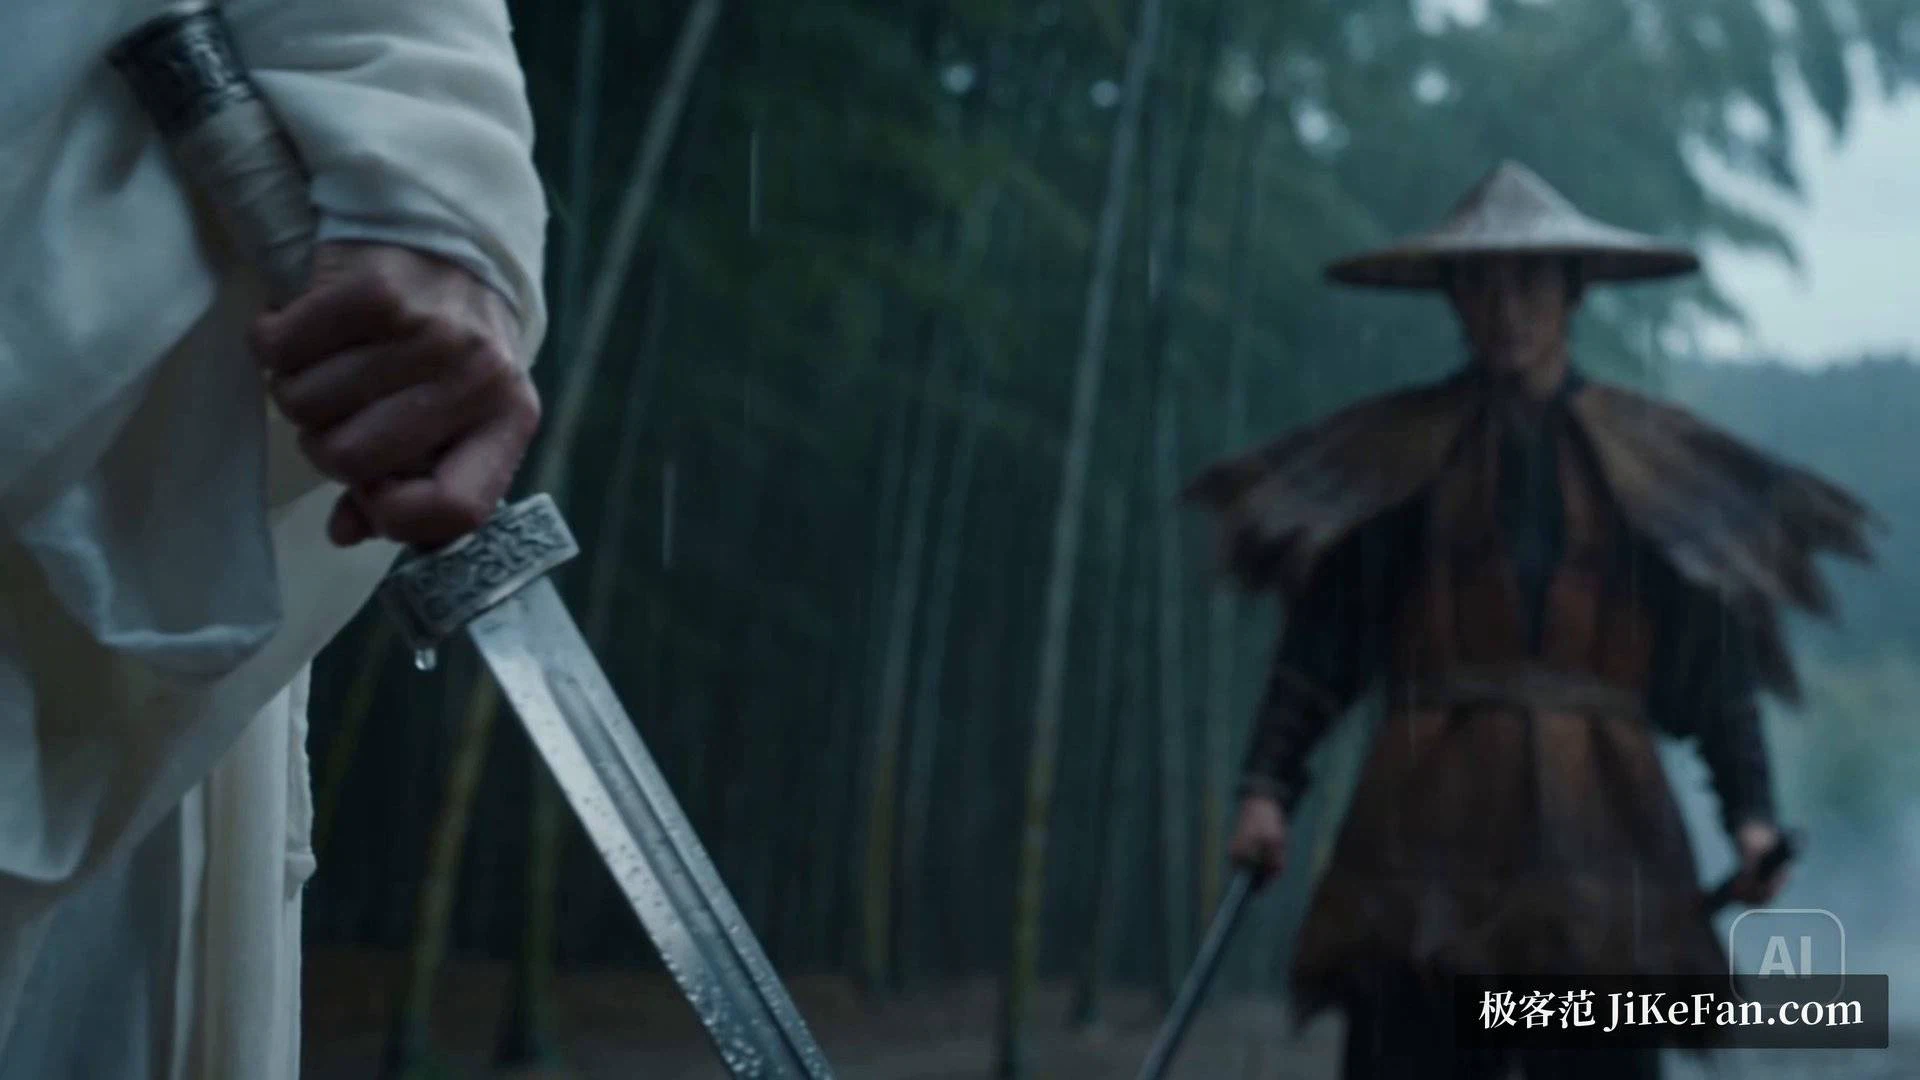
La vidéo derrière le service vient de la série Seedance. La note de publication de l'équipe de développement indique que la deuxième génération est en ligne et que, face à la précédente, elle tient mieux dans les interactions complexes et les mouvements rapides, avec une exactitude physique, un réalisme et une contrôlabilité nettement améliorés — plus près de ce qu'exige une production industrielle.
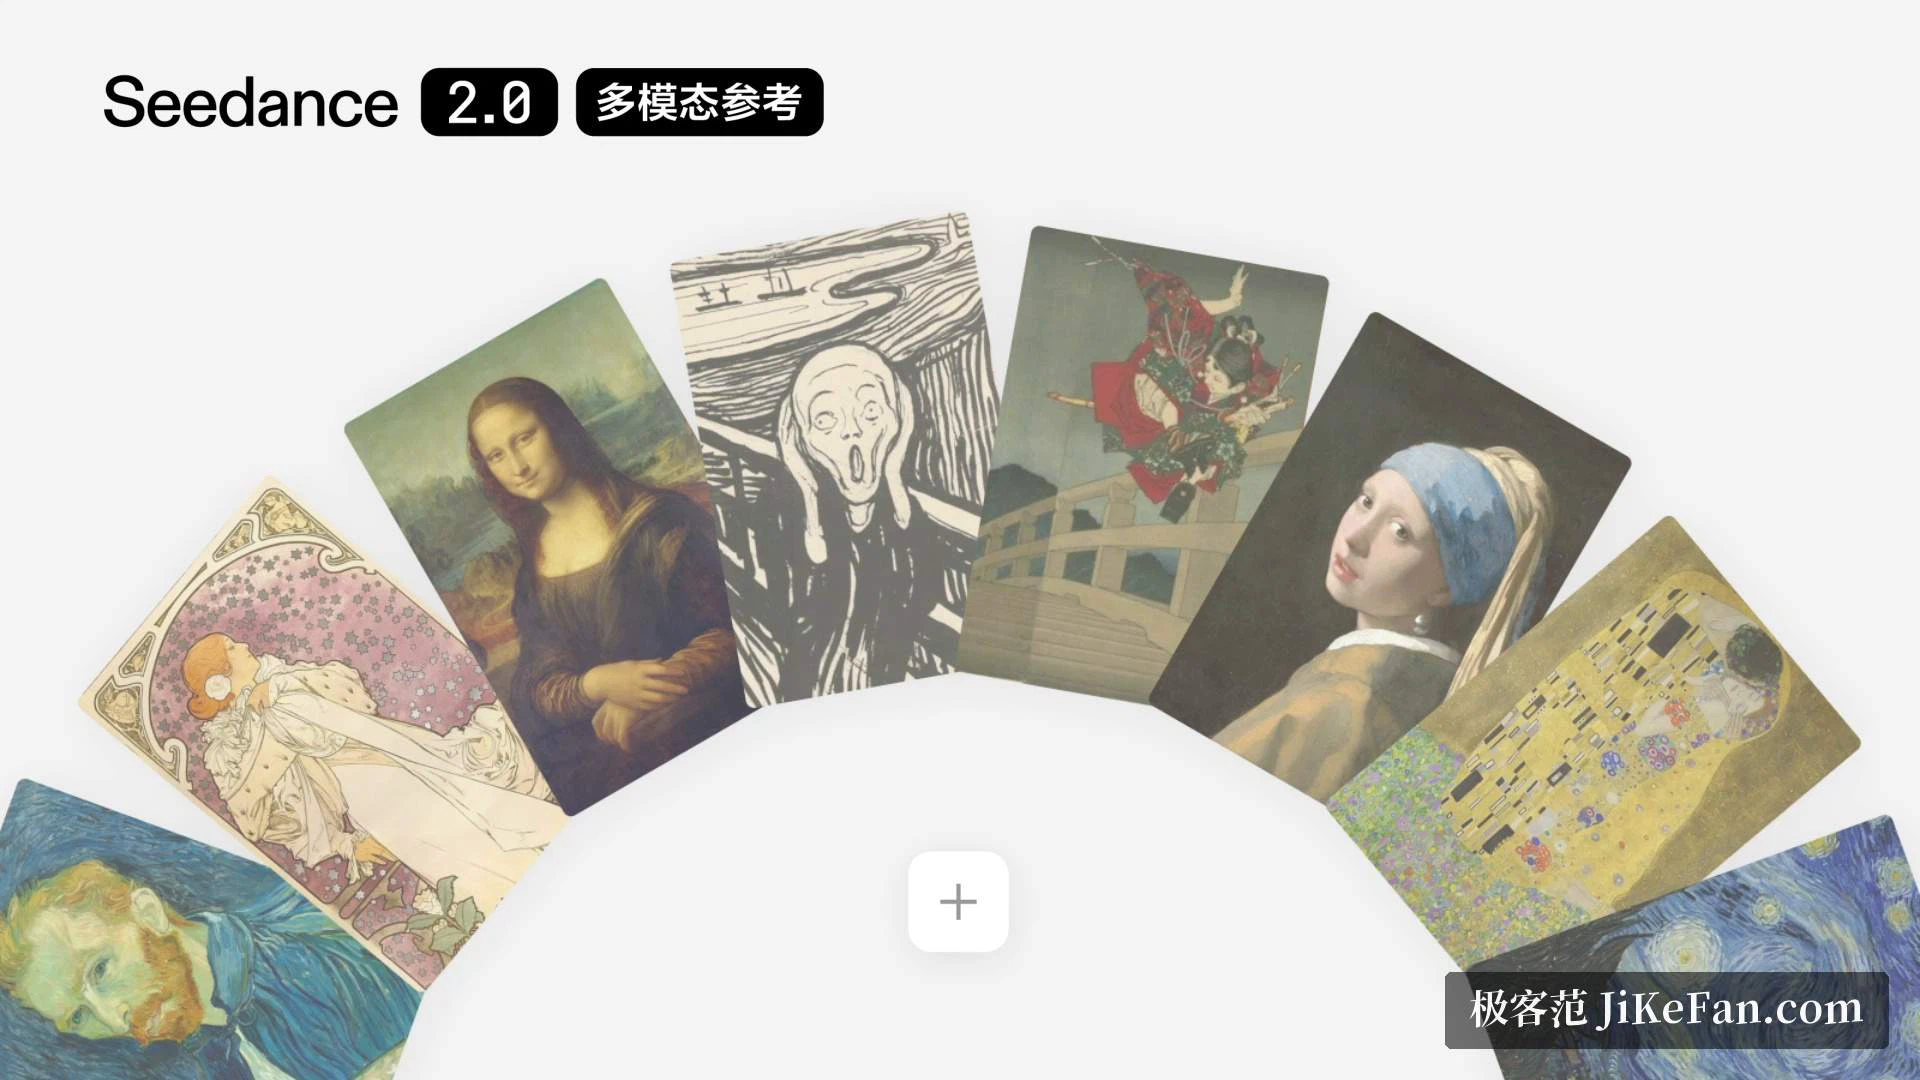
Le point central, ce sont les références multimodales. Texte, images, audio et vidéo peuvent être fournis en même temps, jusqu'à neuf images, trois clips et trois pistes audio dans une seule requête, et le modèle puise dans la composition, le mouvement, le travail de caméra, les effets et le son de ce matériel. Donner un storyboard et demander la scène devient une instruction exécutable plutôt qu'une figure de style. En sortie, quinze secondes de vidéo multi-plans avec son sont prises en charge, en deux canaux, de sorte que musique, ambiance et narration tournent sur des pistes parallèles et restent calées sur le montage.
On peut le modifier, et le poursuivre
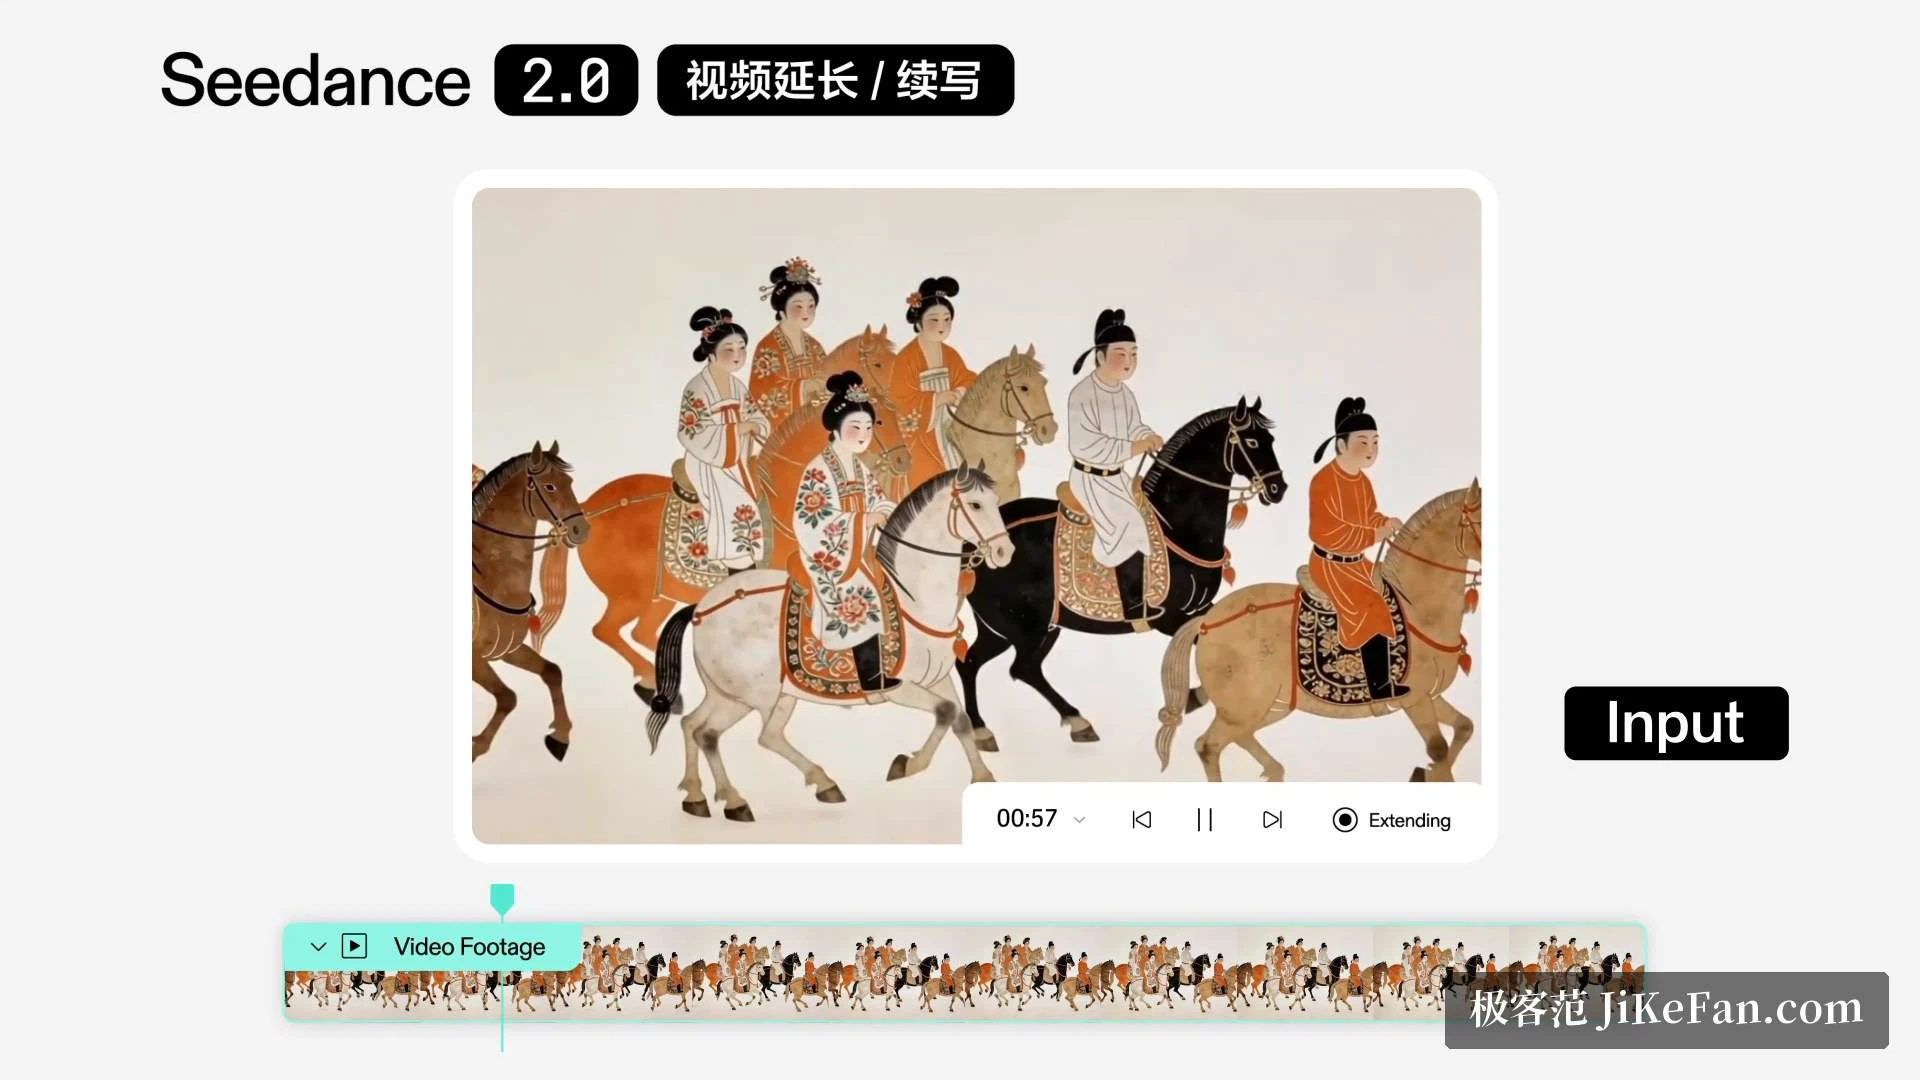
La génération n'est que la première étape. La note ajoute une édition qui cible un segment, un personnage, une action ou un point de récit pour le réviser, ainsi qu'une extension qui fait croître une séquence continue à partir d'un prompt — la formule employée est qu'il ne fait pas que générer, il continue de tourner. Combiné aux deux emplacements d'image, le niveau de contrôle se situe plutôt en tête de cette catégorie d'outils.
Le canevas garde la correction au même endroit
Le canevas est le module dont on parle le moins. Il embarque un générateur de composition, plus retouche locale, extension en un clic, suppression d'objets et détourage. Plusieurs éléments se joignent sans couture sur une même surface, de sorte que le résultat garde une seule écriture visuelle, et l'édition multi-calques permet un contrôle plus fin. Autrement dit, ce qui déplaît se corrige là où cela a été produit, sans faire voyager des fichiers entre un générateur et une application de retouche.
Les limites, dites clairement
L'évaluation de l'équipe elle-même n'esquive pas les problèmes. La stabilité du détail, le réalisme et la vivacité du mouvement demandent encore du travail, le mouvement des lèvres sur plusieurs personnes n'est pas encore fiable, et le son se déforme parfois. Ce sont des choses à savoir avant de choisir plutôt qu'à découvrir après. S'y ajoute une mise en garde explicite sur l'usage d'une personne réelle comme référence : la personne du matériel doit être générée par IA ou déjà autorisée, et un portrait authentique exige la vérification de l'intéressé ou une autorisation juridique préalable.
En résumé : la force n'est pas dans une capacité isolée, mais dans le fait que génération d'images, production vidéo, correction et choix du modèle tiennent dans un seul flux, avec un soutien officiel pour le chinois comme langue de travail. Qui veut un studio chinois immédiatement opérationnel devrait l'essayer d'abord. Qui a besoin d'une image de temps en temps trouvera le reste superflu.